求职最消耗人的从来不是面试,是前面那一段:一份简历反复投出去,沉进黑盒,等回音的时候你连自己投过哪些岗位都记不清了。作者在 README 开头写得很直白 ——「我花了好几个月用最笨的方式投简历,所以我把当初希望存在的系统做了出来。」
他甚至说了一句挺扎心的话:公司用 AI 筛候选人,那我就给候选人一套 AI 去挑公司。
是什么
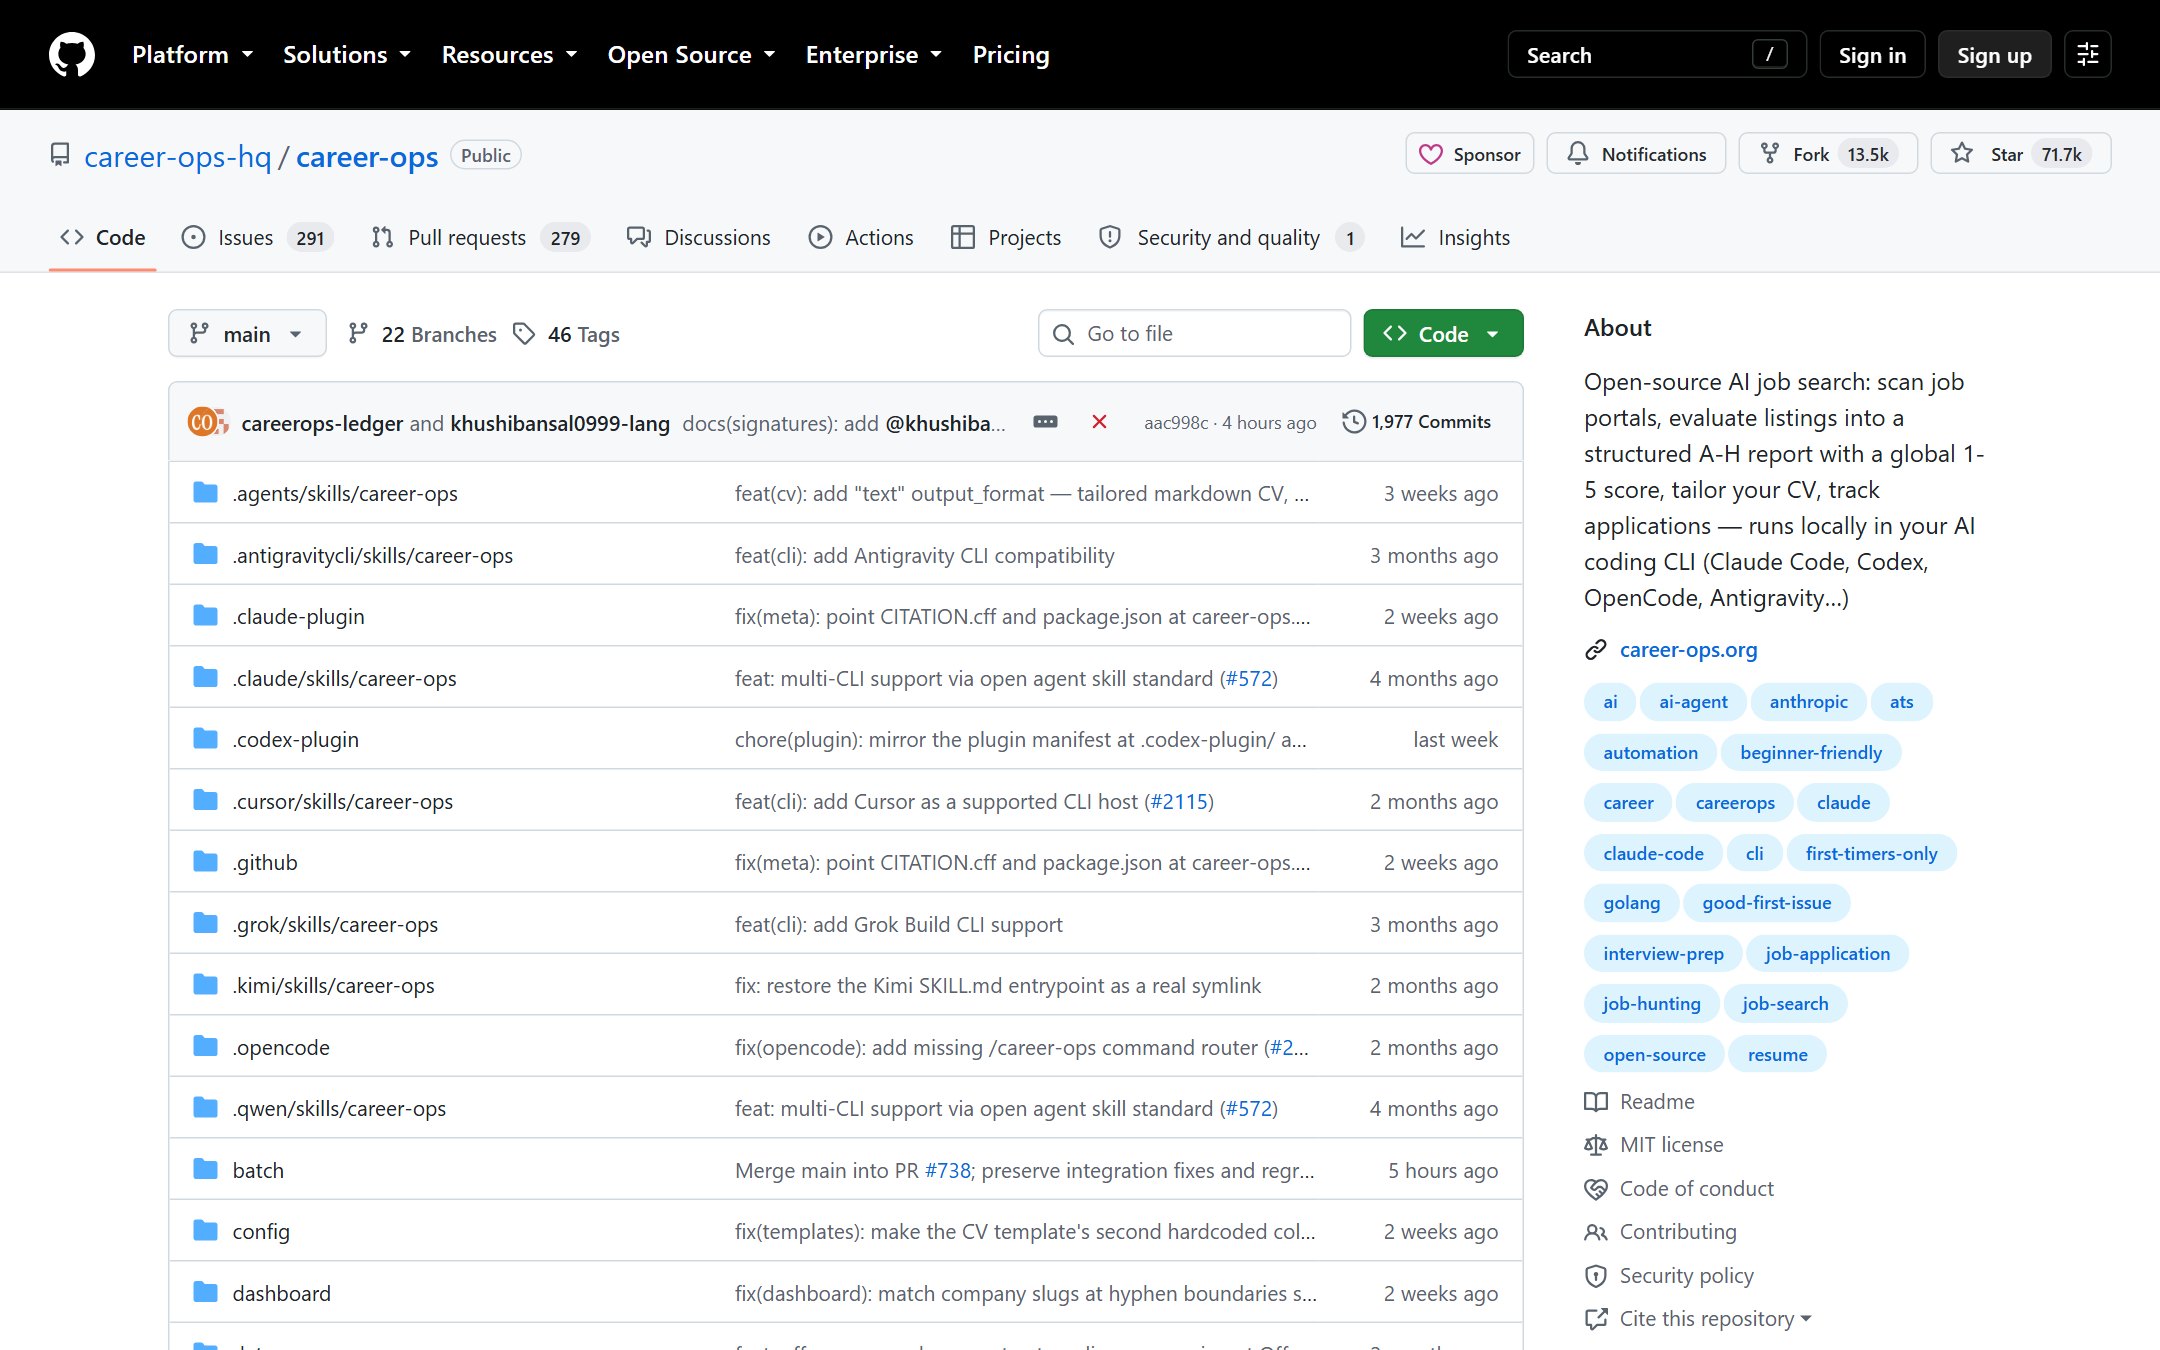
career-ops 是一套跑在本地 AI 编码 CLI 里的求职流水线。它不是网站,不是 SaaS,你不需要注册账号,数据都在你自己的电脑上。项目在 GitHub 上 7.2 万 Star,1.35 万 Fork,MIT 协议,最新版本 v1.32.0(2026-09-03),从 4 月建仓到现在每天都有提交。
作者用它评测了 740 多个岗位、生成了 100 多份定制简历,最后拿到了一个 Head of Applied AI 的职位。README 里还有一个「已上岸」名单,每条记录都公开可查。
需要先说清楚一件事:它不是海投工具,它是个筛子。README 里把话说得很硬:评分低于 4.0/5 的岗位,系统会明确建议你别投。理由也站得住:你的时间值钱,招聘方的时间也值钱。
核心优势
A 到 H 八块的评估报告,是它最有价值的部分。你把一个岗位链接或者 JD 文本丢进去,它出一份结构化报告:A 是岗位概要,B 是简历匹配度,C 是级别策略,D 是薪酬调研,E 是针对性改写建议,F 是面试准备(用 STAR+R 结构),G 是岗位真实性核查,H 只在评分达到 4.5 以上时才起草。最终那个 1–5 的总分不是加权算出来的,是综合五个维度做整体判断给的。B 块里每一条要求都会标重要程度,而且会注明这个权重是从 JD 的措辞来的、从它的结构来的、还是模型估计的 —— 估计来的权重永远进不了最高档。G 块专门抓骗局岗和幽灵岗,还有一条工作授权信号,如果 JD 明确写了不提供签证担保,会被当成硬性阻塞项直接标出来。
简历是按岗位改的,不是一份投到底。它会针对具体 JD 生成 ATS 友好的 PDF 简历,做关键词注入,版式走 HTML 加 Playwright 渲染成 A4。求职信生成器也一样:四个可交互的角度提示(为什么 / 问题 / 方案 / 语气),在对话里先出草稿给你过一道关,确认了再生成 PDF。投递邮件也支持起草正式版、内推版、冷启动版三种,带主题行、附件清单和基于真实资料的匹配点。但注意,它只起草,从不发送、从不提交、从不点击任何按钮。
招聘站扫描开箱就有 100 多家公司。预置列表里有 Anthropic、OpenAI、ElevenLabs、Retool、n8n 这些,也支持你自己按 Ashby、Greenhouse、Lever、Wellfound 四个渠道加自定义查询。另外还有一个审核优先的 company:funded 命令,从公开的结构化信息源里找出最近拿到融资的公司。
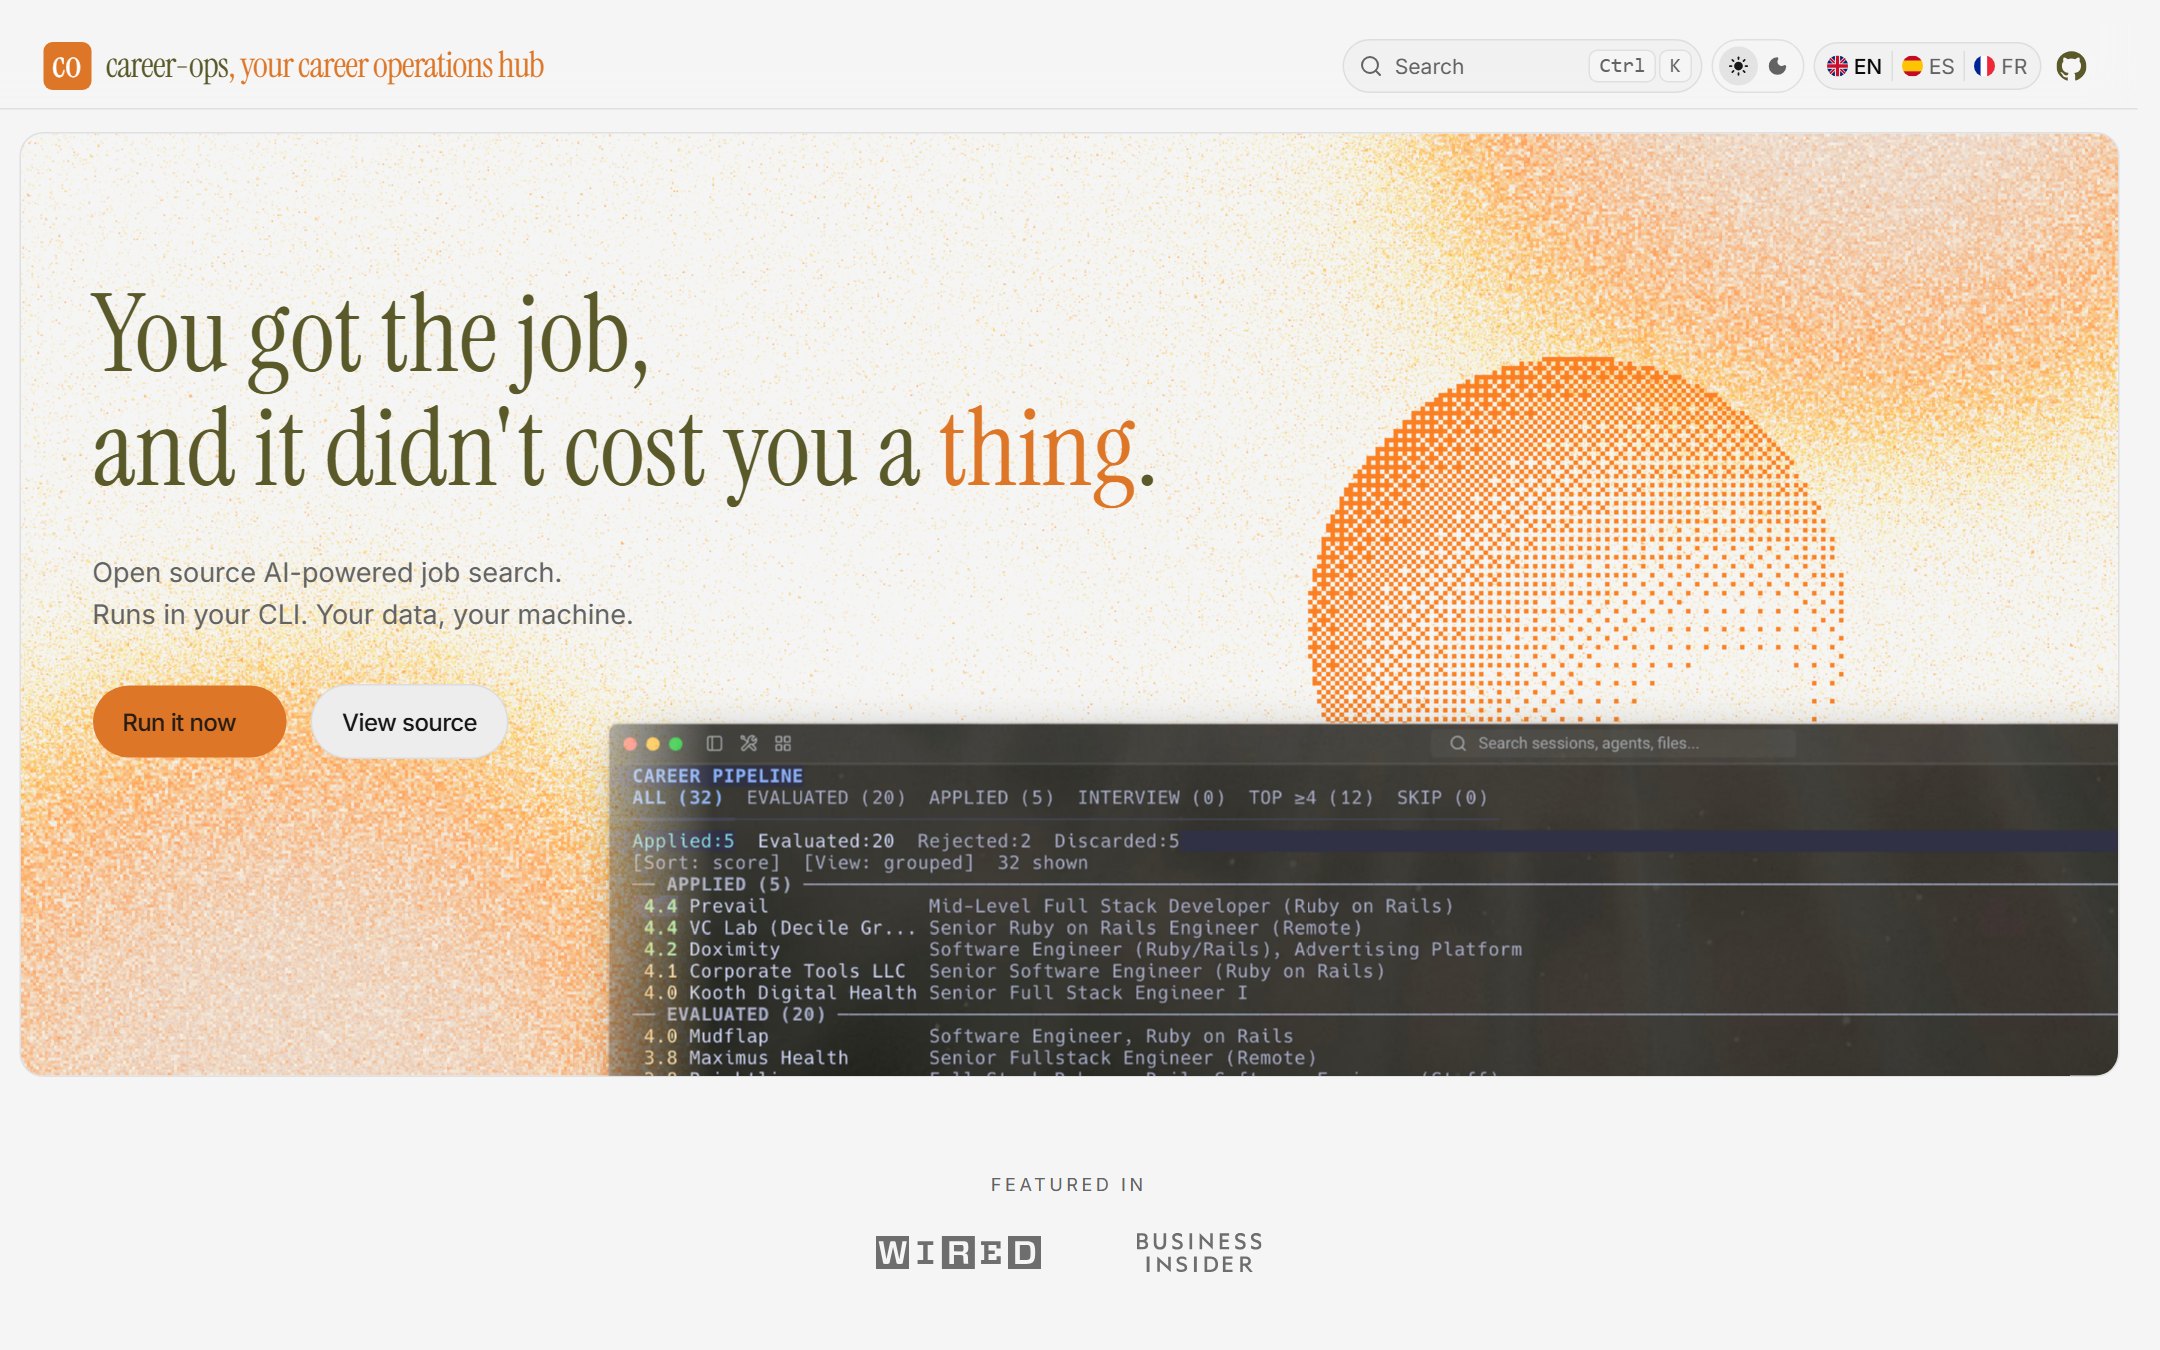
批量和终端界面也都做了。批量模式可以用无头 CLI 工作进程并行评测十份以上岗位(claude -p 或 opencode run)。Dashboard 是一个终端界面,可以浏览、筛选、排序你手上的整条流水线。另外流水线本身带了完整性检查:自动合并、去重、状态归一化。
它往外还延了一层,研究人。deep 模式会给公司做背景调查,看它的 AI 战略、最近的动作、工程文化;contacto 模式找出值得联系的招聘经理、HR 或团队同事,并针对不同角色起草一条三百字符以内的领英消息。它自己的说法是:投递让你排进队列,调研才让你有对话。这句话在真实求职里是对的。
怎么用
最省事的方式是一条命令:
npx @santifer/career-ops init
它会把最新版本拉到 ./career-ops 目录并装好依赖。然后 cd career-ops,用你的 AI CLI 打开这个目录,claude、codex、qwen、opencode 都行。第一次启动它会通过对话带你完成配置:你的简历、个人档案、目标岗位,不用手动改配置文件。
想手动装的话:git clone 之后 npm install,需要生成 PDF 的话再跑 npx playwright install chromium,然后 npm run doctor 检查前置条件,复制两份示例配置改成自己的,再把简历写成 cv.md 放到项目根目录。
之后就是粘一个岗位链接进去,触发生成流水线。项目 README 有 18 种语言版本,包含简体中文。
不是没有槽点
前几次评测会很难看,这是设计如此。作者专门加了一段提示:系统一开始不认识你。你得把简历、职业经历、能拿得出手的成果、偏好、擅长什么、想避开什么都喂进去。他用的比喻挺准,就像新来一个招聘顾问,第一周他得先了解你,之后才变得不可替代。
招聘站渠道是以海外为主的。预置的 Ashby、Greenhouse、Lever、Wellfound 都是欧美公司常用的 ATS,加上那 100 多家预置公司也基本都是海外科技公司。如果你主要投国内平台,这套扫描器基本用不上,能用的只有「把 JD 文本粘进去做评测」这一半功能。领英消息起草同理。
它需要一个 AI 编码 CLI 才能跑。没有 Claude Code、Codex、Qwen 这类工具的话,这个项目对你来说是空的。这倒不算大问题,会关注这个项目的人基本都装了。
它不知道你的真实处境。评分是模型综合判断的,五维度打分听起来很结构化,但它读的是 JD 文字和你的材料,读不出「这家公司下个月可能裁员」或者「这个岗位其实是内部已经定了人」。G 块的岗位真实性核查能挡掉一部分骗局岗,但挡不住所有。报告是给决策提供信息的,不是替你决策的。
项目还很年轻。四个多月冲到 7 万 Star,目前 570 个未关闭 issue,功能面上还在快速扩张(谈判脚本、薪资落差分析、拒信模式分析、跟进节奏计算、雇主回复分类,这些都还在往前推)。用最新版能吃到新能力,也会碰到新毛刺。
跟同类比怎么看
和简历优化网站比,最大的区别是数据面。那些服务拿到的是你上传的一份简历,career-ops 拿到的是你的完整档案加上每一个具体岗位的 JD、公司背景、联系人;而且它跑在本地,简历和工作经历不用上传到第三方服务器 —— 除了和模型对话那部分。
和求职追踪表格比,它多出来的不只是自动填表,是「该不该投」这个判断。表格只记录你投了什么,它会先告诉你值不值得投。
和让 Claude 直接帮你改简历比,它的区别是流程化:八块结构固定、评分标准公开、状态跟踪和去重都有,不会每次问都得到风格不一样的建议。
一句话:如果你在投海外科技公司的岗位、手上有 Claude Code 或者类似的 CLI,这套东西值得花一个晚上配置起来,光是「低于 4.0 就别投」这条规则就能帮你省下大量时间。如果你主要投国内平台,可以先把它当 JD 分析器和面试准备工具用,扫描器那部分先放过。
GitHub:https://github.com/career-ops-hq/career-ops
官方网站:https://career-ops.org
标签:#career-ops #AI求职工具 #简历优化 #面试准备 #求职流水线 #效率工具
你投简历的时候,最想提前知道的是这个岗位的真实薪资,还是它到底是不是个幽灵岗?