手机相册这件事,大部分人已经默认交给云了。免费额度用完就是订阅,想换服务商,几年的照片得一箱一箱往外搬。更实际的问题是,那些照片躺在别人的服务器上,你连"它拿这些图训练过什么"都问不出来。
Immich 是目前这条路上走得最远的开源方案。它不像很多自建工具那样只求"有",而是把云相册那套体验(手机自动备份、按人按地点找图、几年前的今天)原样搬到你自己的机器上,连人脸识别和语义搜索也一起搬了过来。
是什么
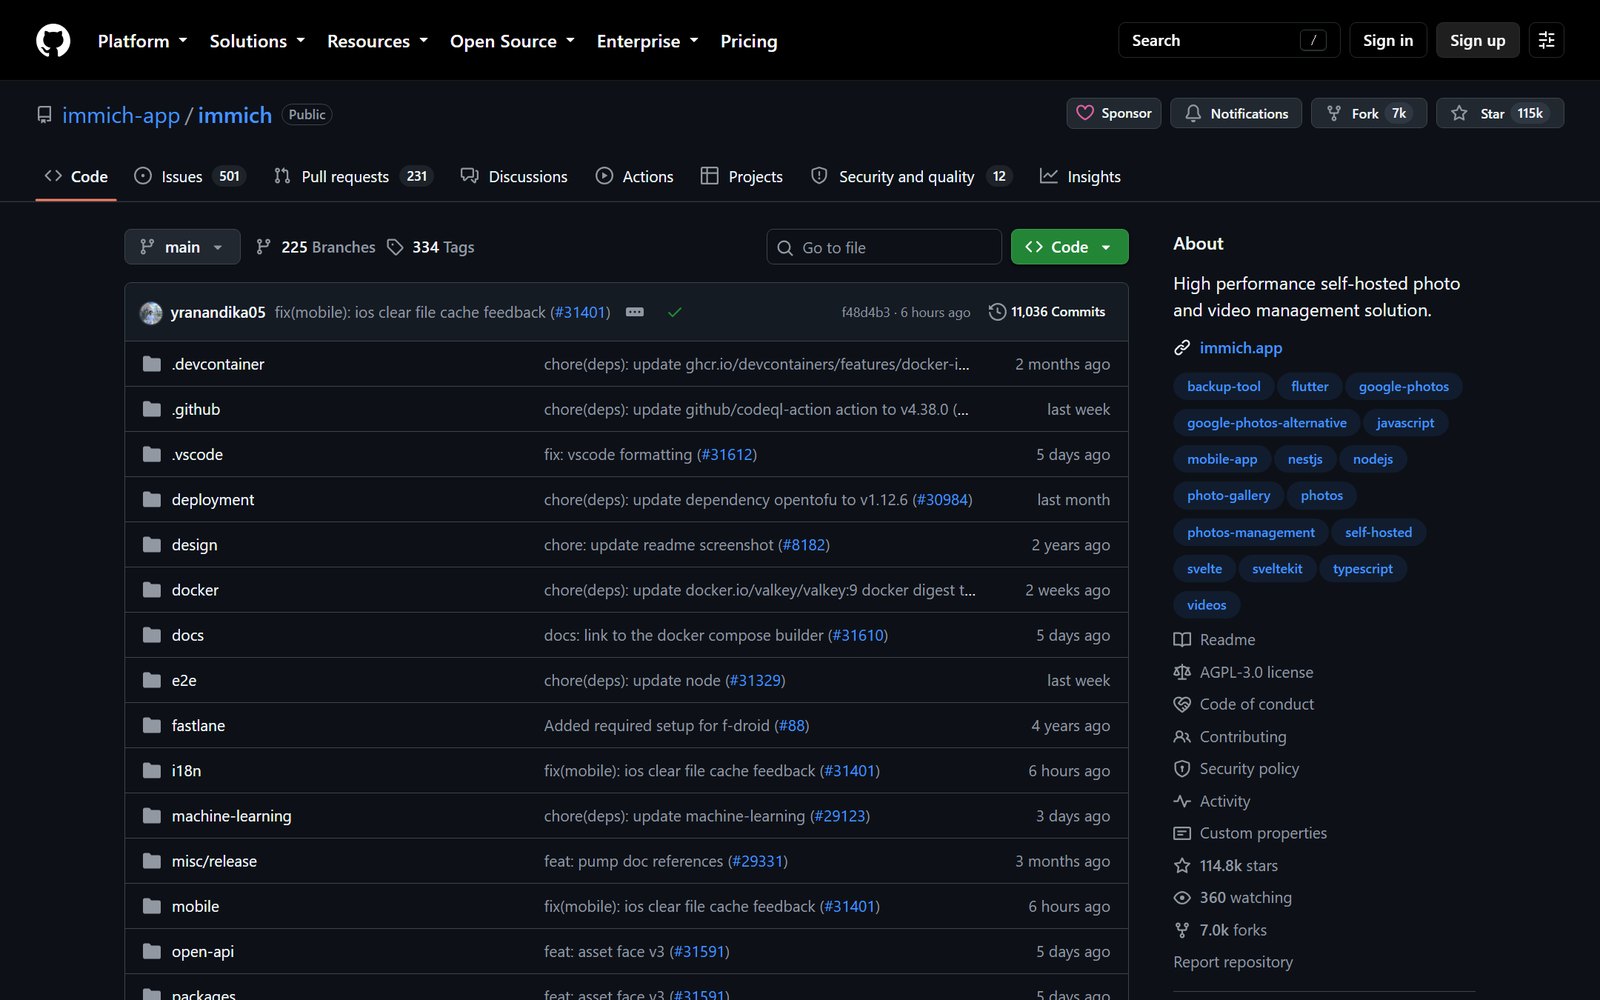
immich-app/immich,TypeScript 写的自托管照片和视频管理平台,AGPL-3.0 协议,11.5 万 Star、7025 Fork,当前版本 v3.2.2(9 月 15 日发布),9 月 21 日仓库还有提交,待处理 Issue 501 个、待合并 PR 231 个,这个活跃度在同体量项目里算很健康的。
部署就一套 Docker Compose,起来是四个容器。immich-server 管接口、时间线、相册这些业务逻辑;immich-machine-learning 是一个独立的 Python 服务,专门干人脸识别、CLIP 语义搜索、物体识别;底下是 PostgreSQL 加向量扩展,存元数据和向量;再加一个 Redis 做任务队列和缓存。手机 App 把相册增量传上来,机器学习服务给每张图抽出人脸特征和文本向量写进向量库,搜索时把你的话转成向量做相似度匹配。整条链路不调用任何外部云服务,原始文件就是磁盘上的标准文件,你随时能拿别的工具去读。
核心优势
手机端是真的能自动跑。iOS 和 Android 都有原生 App,支持整库后台增量上传。这话听着平平无奇,但它恰恰是绝大多数自建相册折戟的地方:Android 的后台限制卡得很死,能把这块做稳的项目没几个。体验上的分水岭就在这里。
认人认得全,也认得过来。人脸识别自动聚类,认一次人,这人其余照片自动归到一起。v3.2 新加的 cluster group 更实用:家庭成员共用一台服务器时,你在自己库里标好的人,系统能在别人分享的照片里也认出来,而且参与聚类的脸变多了,准确率本身也会涨。代价得说清楚:开启这个功能要对全组重新跑一遍人脸识别,之前手动标的姓名和生日会清掉,所以官方反复强调先备份、想清楚再开。另外,名字和生日这两样仍然是各人自己的,不会在组里共享,这条隐私边界是刻意留的。
一句话搜图,不是搜文件名。输入「海边那只狗」它能找出来,靠的是 CLIP 语义检索,向量就存在你自己那台机器的 Postgres 里。v3.2 还把搜索接口整个重做了一遍:新版能用 AND、OR 组合多个条件,也能限定在某一个相册里搜。这一步的意义比看上去大——搜索从界面功能变成了可编程的接口,写脚本做自动整理、备份、同步才算有了正经入口。
编辑不破坏原图。v3.0 起移动端就能裁剪、旋转、调亮度对比度,随时一键恢复,原图始终在原地。视频那边上了 HLS 流媒体和实时转码,弱网也能流畅播放。这几处细节比不少商业方案做得还细。
自动化的口子留得比较全。工作流能按条件自动打标签、归档、整理相册,可视化编辑器和 JSON 两种写法都有;v3.2 起还能用"打上某个标签"来触发工作流,并且能判断一张图是否同时满足、任一满足或完全不满足一组标签。除此之外还有 OCR 取字、重复检测、地图视图、外部库只读索引,以及网页端一键备份还原数据库。
怎么用
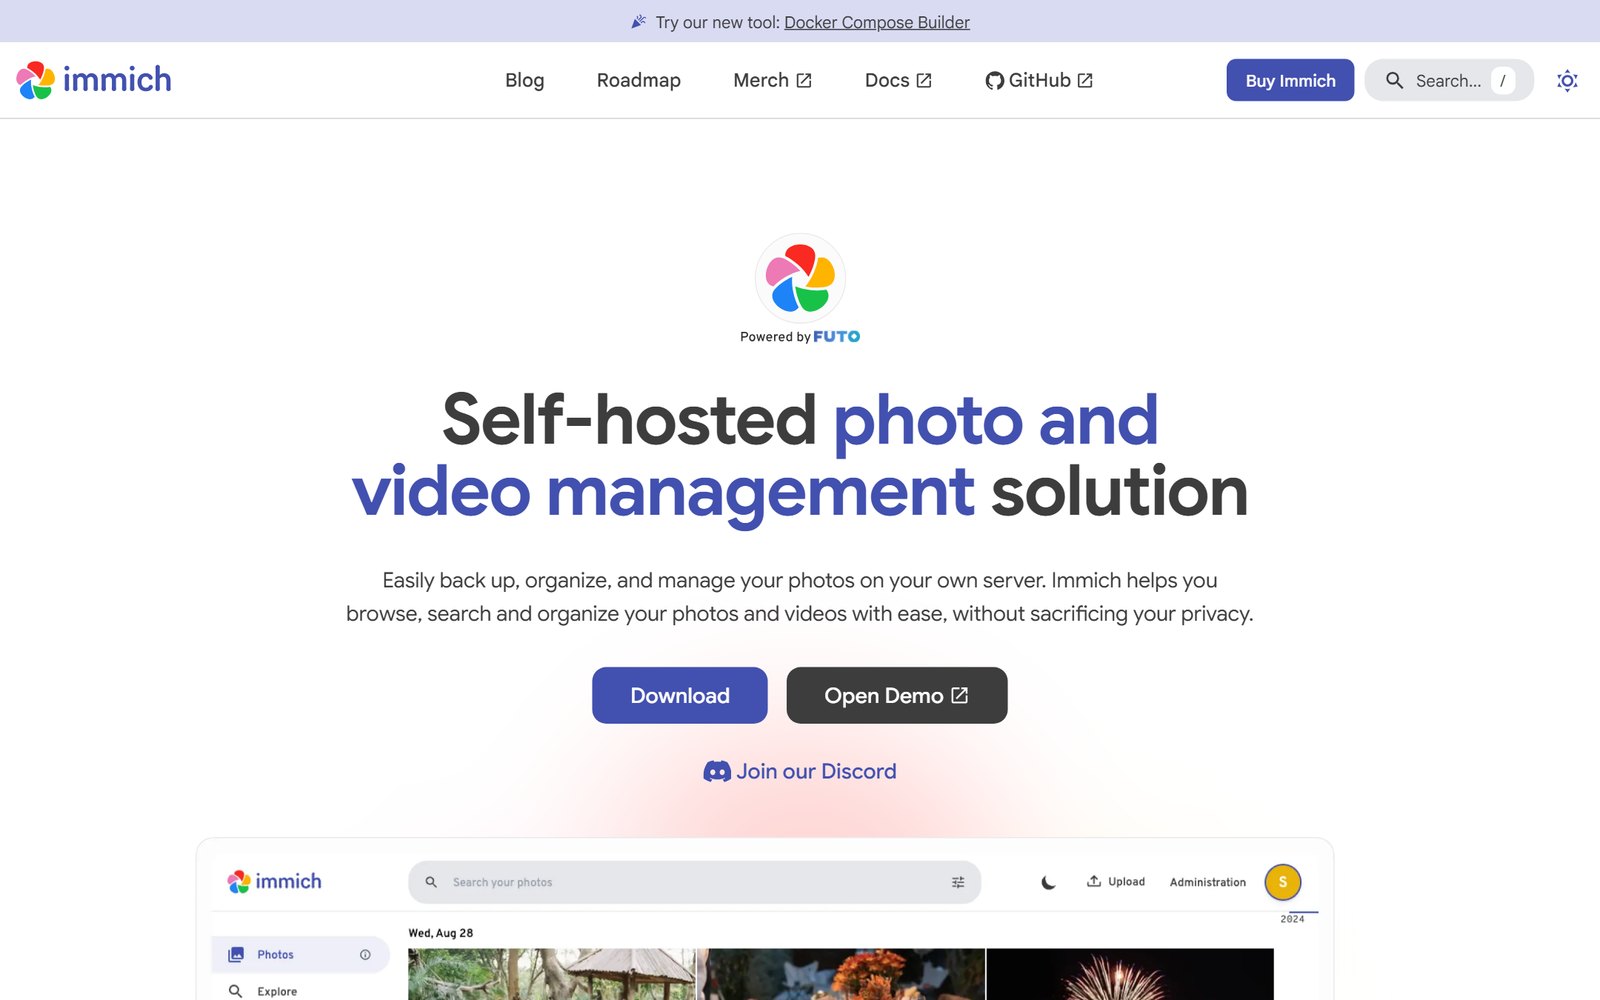
最低门槛的路径是 Docker Compose:拿官方的 compose 文件,配好上传目录和数据库密码,docker compose up -d,然后浏览器打开对应端口走完初始化向导。想先看看长什么样,官方有在线演示站,账号 demo@immich.app,密码 demo,手机 App 也能直接连上去试。
装完之后别急着一次全传。先把机器学习服务跑起来让它下模型,然后挑一个几千张的相册试一遍索引速度,再决定要不要上全库——这一步的顺序反了,很容易在第一天就等到怀疑人生。
不是没有槽点
机器学习很吃资源。给一个积累了十几年的库做人脸识别和内容索引,是一次性的大活。纯 CPU 跑可能是几小时到几天,有显卡会快很多。没有独显也不是不能跑,就是得有耐心。它支持 CUDA、OpenVINO 加速,ARM 设备也有对应方案。
存储只增不减。照片库这东西,从来不会有人主动决定它变大。规划容量的时候得留余量,用 ZFS 或者 LVM 这类能在线扩的分层方案,后面会省很多事。
备份必须自己负责,这是最关键的一条。把照片放回自己家里,责任也一起搬过来了。一个没有做过恢复演练的自建相册,处境其实比云相册更糟——至少那边丢数据不用你赔。项目 README 顶部挂着 3-2-1 备份原则的链接,这不是客套话。
升级偶尔要动手。这个项目迭代很快,历史上出现过需要手动跑迁移步骤的版本。看到新版本先读完 release notes 再升,别升完了再研究怎么退。
中文查询的默认表现一般。有第三方实测提到,默认的 CLIP 模型对中文描述理解偏弱。真要用中文搜,就换一个更适合中文的模型,或者干脆用英文关键词。这属于模型层面的问题,不是软件本身的缺陷,但你得知道有这回事。
跟同类怎么比
对 Google Photos、iCloud 这类商业云相册。功能上 Immich 已经能打了:自动备份、人脸分组、语义搜索、共享相册、时间线、地图、回忆,一样不少。差价在运维成本和可靠性上限:你换来数据完全归属自己,代价是得有人管这台机器。单人用、只图省事,云更划算;家里有 NAS、有几十万张照片、在意隐私的,这笔账要反过来算。
对 PhotoPrism、LibrePhotos 这类老牌自托管相册。它们资历更老,PhotoPrism 的图像分类做得很细,LibrePhotos 走 Django 那套技术栈。Immich 领先的地方主要在移动端体验和迭代节奏:手机后台备份的稳定性、原生 App 的完成度、多用户和共享的细节处理,这几块差距肉眼可见。
对 Nextcloud 加相册插件。Nextcloud 是全能网盘,相册只是它的一个模块。要是你本来就在用它存文件,插件够用就别折腾;但真把照片当主力管理对象,专用工具的检索和浏览体验还是另一个档。
对"自己拿文件夹加大模型硬搭"。这条路理论上完全自由,实际成本全在维护:得自己写增量备份、自己接人脸模型、自己做索引和前端,写着写着就变成一个半成品 Immich。多数人编到一半会回来。
一句话:你要的是"照片归我、体验不减、愿意花个周末搭起来",Immich 是现在最不容易选错的那个;你要的是"零运维、开箱即用",那它从方向上就不适合你。
项目地址:https://github.com/immich-app/immich
官网与文档:https://immich.app/
标签:#Immich #自托管 #照片管理 #开源工具 #Docker #私有云
你手机里那些照片,是继续交着月费放在云上,还是愿意花个周末搬回自己的机器?