把公司几年的合同、手册、研究报告一股脑塞给大模型做问答,第一次演示通常很惊艳,第二次就开始翻车:表格里的数字串了行,扫描件里的字漏了一大截,问到出处的时候支支吾吾。业务方只要问一句"这段话是从哪一页来的",当场就僵住了。
问题大多不在模型,而在喂进去之前那一步。市面上多数 RAG 框架默认你给的是干净文本,PDF 随手调个解析库切一切就算完事——可真实的企业文档恰恰是最不干净的那一类。
是什么
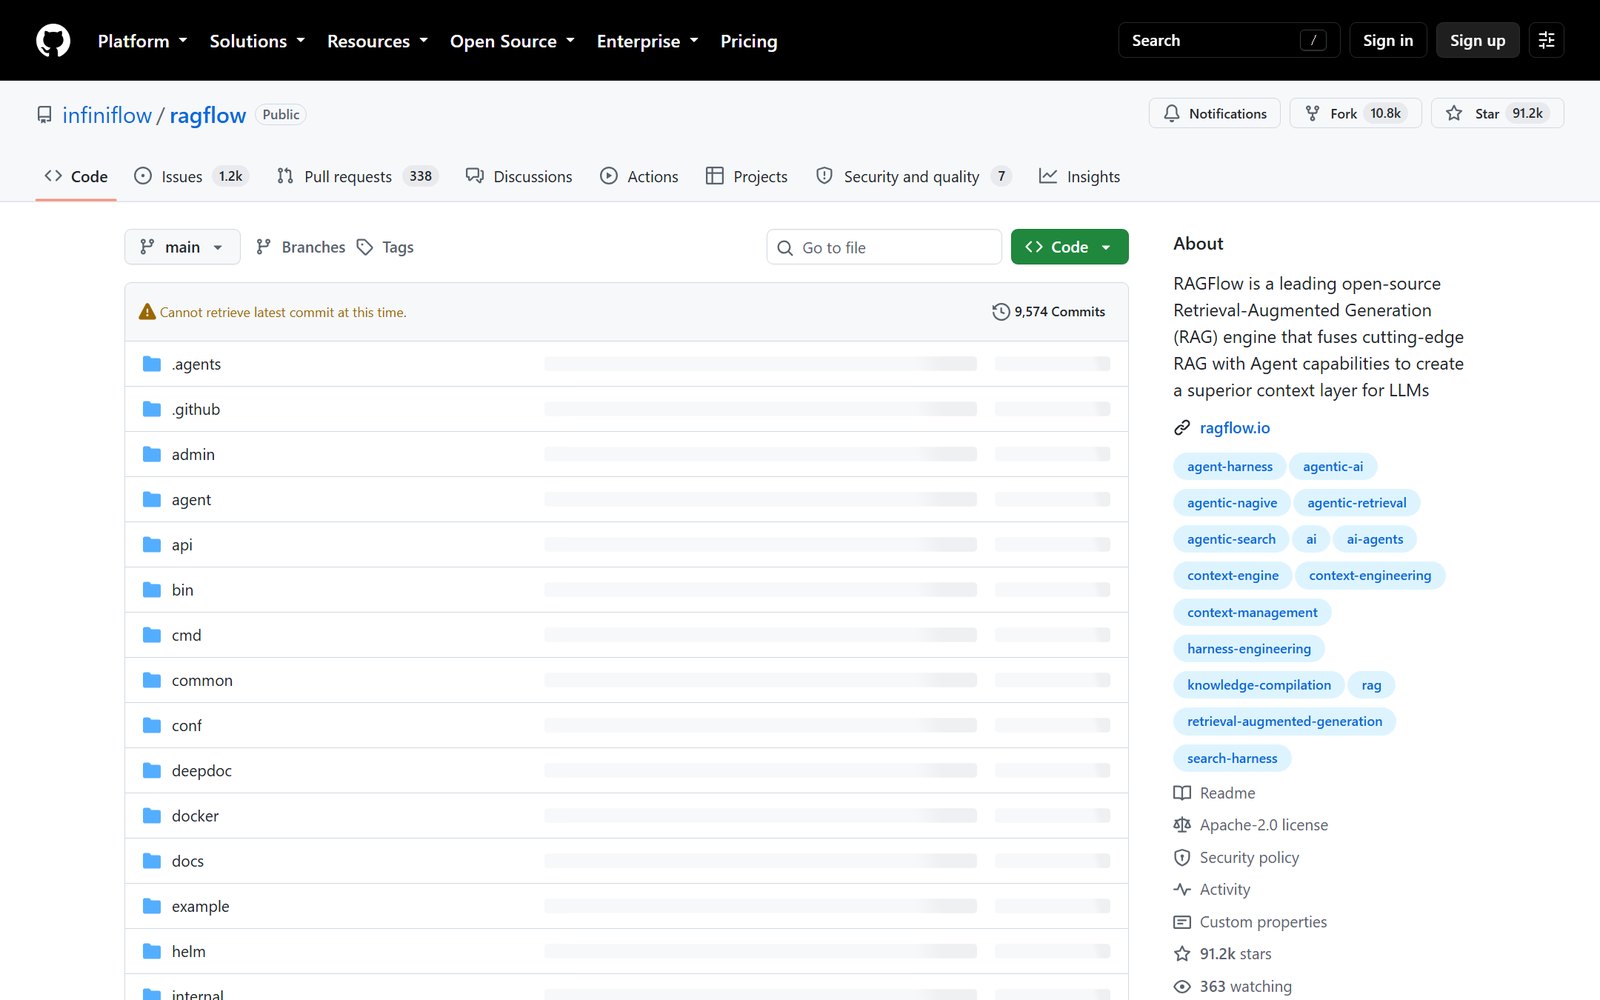
infiniflow/ragflow,Apache-2.0 协议,9.1 万 Star、10809 Fork,当前版本 v0.27.2(2026 年 9 月 10 日发布),9 月 22 日仓库还有提交,待处理 Issue 1152 个、待合并 PR 338 个。项目 2023 年底开源,跑了两年半,节奏一直没松下来。
它给自己的一句话定位是"为 AI 智能体构建上层上下文":把非结构化文档吃进去,编译成结构化的、能被检索和复用的知识资产,再把检索能力开给上层对话和 Agent。整套东西自托管,Docker Compose 拉起来,数据不出内网。
有一点值得单独讲:v0.27 是最后一个以 Python 为后端的版本,下个大版本后端迁到 Go。官方给的解释不是性能洁癖,而是"检索这件事的调用方正在从人变成 Agent"——调用频率和延迟要求完全是两个量级。一个已经跑了两年半的项目愿意做这种级别的重构,说明它对往后几年想得很清楚。
核心优势
先把文档读懂,再谈检索。它用的是版面感知的解析,复杂表格、插图、扫描件都能认,表格里的行列关系不会在切分时散架。这话听起来像基本功,但绝大多数 RAG 项目恰恰死在这一步:源头切错了,后面检索再花哨也救不回来。RAGFlow 选的路线是把 ETL 当成真正的难题,而不是假设上游已经干净。
一份文档,编译成七种读法。v0.27 引入的知识编译引擎,把解析、切分、索引之外的东西也做了:识别实体、关系、概念、时间和层级结构,然后落成七类知识资产。Wiki 把零散资料组织成可浏览的知识页面,支持编辑、版本对比,能导出 Markdown;Graph 抽实体和关系,点节点就能看跨文档的关联;Tree 按语义组织成层级,保留原文阅读序,适合大部头和复杂长文档;Page Index 按标题、小节、关键事实生成层级索引,专门对付技术手册、研究报告、法律文件这类长文档;Mind Map 让你快速看清全貌;Timeline 把文档里的时间和事件排成序列,企业发展、项目里程碑、政策演进用起来很顺;最后 To Skills 把数据集里的知识整理成一批 Skill 文件,每个带名称、描述、层级、知识概览和源文档。这套东西的价值在于:一次性把文档处理完的结果,变成了可以长期检索和复用的资产,而不是每次提问都从零召回。
检索会先想一下再动手。传统 RAG 的流程是固定的:提问,检索一次,拿到 Chunk,模型照着写。问题稍复杂就不够用。比如你问"这个版本相比上一版在文档处理上有什么变化",这一句话里其实藏着好几个信息需求,一次性召回很容易漏。v0.27 引入的 Agentic Retrieval 让检索先做判断:拆子问题、改写或拆分 Query、分别找证据,觉得不够再补检索,最后综合多轮结果作答。落到界面上是五档 Thinking 模式——朴素、轻、中、高、极高。朴素档还是老流程,事实型问题够用;中档开始会把问题拆成若干必须查清的 Claim 分别验证;高档和极高档先判断问题意图是查事实、做对比、看流程还是归纳,再定检索计划,极高档还能发现新方向重新规划路径。按问题难度换延迟,比一刀切要合理得多。v0.27.2 又把这个框架重构了一遍,进一步压了推理耗时、抬了基准表现。
接数据的口子铺得够宽。增量连接器覆盖 Outlook、OneDrive、Teams、Slack、SharePoint、Salesforce、Azure Blob、BigQuery、Azure DevOps、WebDAV,还有基于 sitemap.xml 抓网站的 Sitemap 数据源。这件事的分量在于:企业文档真正待的地方就是这些系统,能不能从那里增量同步,是"能演示"和"能上线"的分界线。
模型接入按真实部署来设计。底层把模型配置做成了 服务商 → 实例 → 模型 三层:同一个服务商下可以挂多个实例,各自用不同的 API Key、区域和 Base URL,每个实例下再配自己的模型清单。配好之后 RAGFlow 会自动拉取该服务商可用的模型列表,不用一个个手敲,也能批量验证可用性。现实里的接入方式本来就五花八门——有人云端本地混着用,有人一个实例只跑对话、另一个专管向量化——这套结构就是照着这些情况补的。
混合检索是一条成熟的默认路线。官网首页把这件事单独列了一块:向量检索、BM25 关键词检索,再加一路自定义打分,最后过一遍重排序(rerank),追求的是答案准确率和上下文相关度。0.27.1 起元数据过滤被下推到元数据索引里执行,过滤条件不再等到检索完再筛,速度差别在高基数字段上很明显。这条路线的意思是不指望单走向量能解决所有问题——专有名词、编号、型号这类东西,关键词那一路的召回反而是更稳的。
怎么用
最省事的路径是 Docker Compose:官方仓库拉下来,配好端口和环境变量,起来之后浏览器访问对应端口进入管理台。要留意的是资源下限——官方给的是 4 核 x86、16GB 内存、50GB 磁盘起步,Docker 24 以上、Compose 2.26.1 以上,Python 3.13 以上。多路召回要另外接 Elasticsearch 或者 Infinity;用到代码执行沙箱还得上 gVisor。这不是个轻量玩具,装机之前先确认手头这台机器撑得住。
创建知识库的流程是:建数据集、上传文档、选一个解析模板。v0.27 之后多了一条编译路线——先在 Agent 模块里建 Compilation Operator,选抽取用的模型和要生成的资产类型(Wiki、图谱、树、索引、脑图、时间线),把它配进 Ingestion Pipeline 的 Compiler 环节,再把 Pipeline 应用到数据集或单份文档上。典型 Pipeline 是解析 → 切分 → 编译 → 索引四步。跑完之后,数据集下面会多出 Artifacts 入口,按类型看生成的知识资产,单份文档也有自己的 Artifact 页面。
顺序上有个建议:第一次别把全库导进去。先挑一份二十页、表格多的合同或者手册,完整跑一遍解析和编译,看表格有没有串行、扫描件认没认全,确认没问题再放量。这一步省下来,后面要还的债会多好几倍。
不是没有槽点
基础设施是真的重。4 核 16GB 只是起步线,多路召回还得再挂一个检索引擎,要跑沙箱再加一层。跟"pip 装一个库就能开始玩"的 LlamaIndex、Haystack 完全不是一类东西。你换来的是能上生产的完整链路,付出的是实打实的机器和运维成本。
文档跟不上发布速度。v0.27.2 是 9 月 10 日发的,指南还落在后面。这个项目的迭代频率决定了文档永远处于追赶状态,遇到卡点得靠翻 Issue 和源码。
UI 里 GraphRAG 和 RAPTOR 被下掉了。它们的功能被知识编译体系取代,之前按老教程找菜单项的人会扑空。已经生成的内容还能搜到,但路径变了,这一步迁移是硬性的。
ARM 没有官方 Docker 镜像。想在苹果本或者 ARM 服务器上跑,得自己构建。这个坑在部署阶段才会暴露。
开源版和企业版之间有落差。BYOC 和本地部署这类能力划在企业版,自托管用户得先确认自己需要的东西在不在开源范围内。
跟同类怎么比
对 Dify。两家经常被放在一起比,但重心不同。Dify 强在把整个应用编排串起来,工作流、插件、发布渠道一条龙,RAG 只是其中一块;RAGFlow 把绝大部分力气砸在文档解析和检索质量这一层。简单说,你要的是"快速拼一个能演示的 AI 应用",Dify 更顺手;你要的是"几千份烂格式文档进去,问答还能给出准确出处",RAGFlow 的下限更稳。两者并不排斥,社区里也不缺 RAGFlow 当检索层、Dify 当编排层的搭法。
对 FastGPT、AnythingLLM 这类开源知识库。它们上手更快,一台小机器就能跑,界面也更轻。代价在解析深度:碰到复杂表格、扫描件、多栏排版的 PDF,处理质量的差距会很明显。文档结构简单、体量不大,用它们完全够;文档又杂又多,省下来的部署功夫最后都会在"答案不准"上还回去。
对 LlamaIndex、Haystack 这类框架。它们是给人写代码用的库,灵活度最高,什么都能自己接。但"灵活"的另一面就是文档解析、增量同步、可视化编排这些全要自己搭,写着写着就写成了半成品 RAGFlow。
对 Vectara、Pinecone 这类托管服务。托管省心,不用管机器,但数据要出去,成本按用量走、不好预测,深度定制也受限。RAGFlow 被选中的理由很少是"更精致",基本是数据主权和成本可预期这两条——代价是托管、升级、扩容全归你自己。
一句话:你手上有一堆格式很乱的业务文档,要的是检索准、答得出处、数据不出门,还愿意为它准备一台像样的机器,RAGFlow 是现在开源里少数把脏活干完了的选项;你要的是十分钟搭个能看的东西,那它从第一步开始就会让你觉得累。
项目地址:https://github.com/infiniflow/ragflow
官网与文档:https://ragflow.io/
标签:#RAG #知识库 #文档解析 #开源工具 #智能检索 #自托管
你手里那些 PDF 和扫描件,是继续靠关键词搜文件名,还是值得花一个下午试试让机器把它们真正读懂?