做 RAG 或者把资料丢给大模型的人都会撞上同一堵墙:语料全是 .docx、.pptx、.xlsx 和扫描版 PDF,而模型只吃文本。
市面上转 Markdown 的工具不少,但基本都是「一个格式一套逻辑」,转出来的东西表格散架、公式变乱码、脚注直接消失。Firecrawl 上个月开源的 anydoc 想解决的就是这件事——14 种文档格式走同一套解析模型,输出同一份干净的 GitHub 风格 Markdown。
是什么
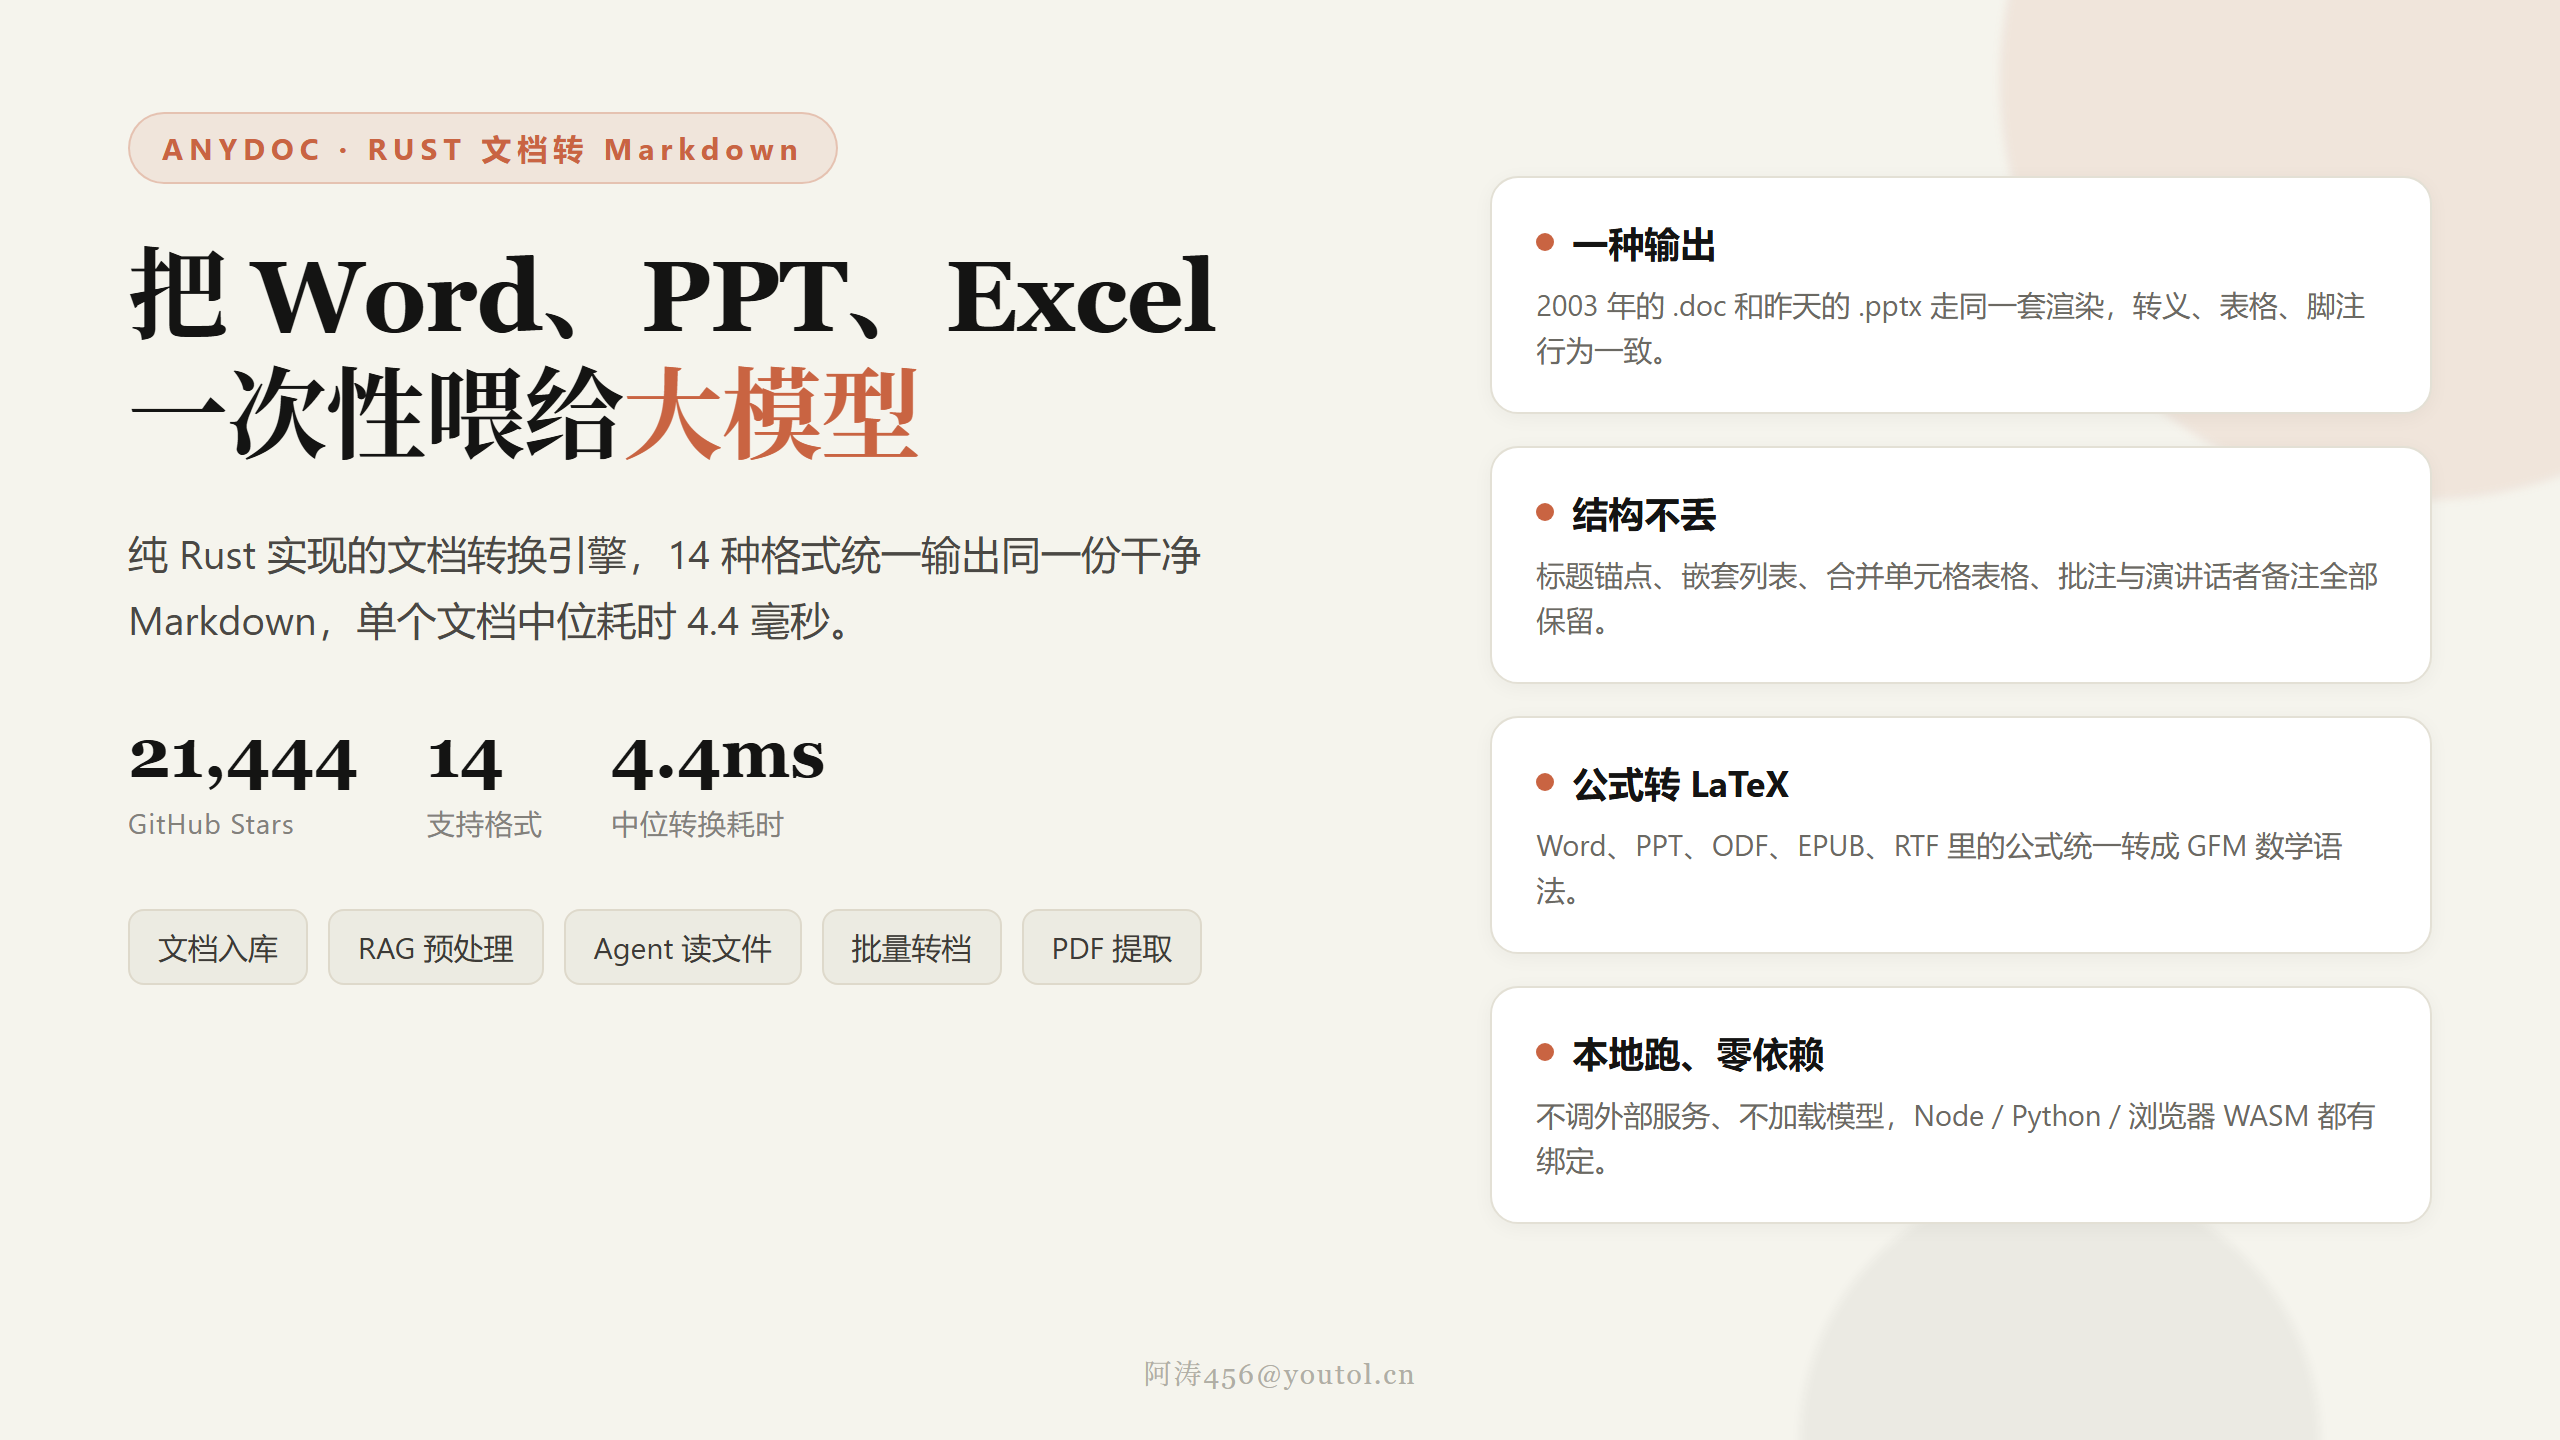
anydoc 是一个纯 Rust 写的文档转换引擎,能读 Word(.doc/.docx/.docm)、PowerPoint(.ppt/.pptx/.pps/.pot)、Excel(.xls/.xlsx/.xlsm/.xlsb)、OpenDocument(.odt/.ods/.odp)、RTF、EPUB、CSV 和 PDF,统一转成 Markdown。
它同时给了 Node.js、Python 和浏览器 WASM 三套绑定,也作为 Agent Skill 发布——npx skills add firecrawl/anydoc 之后,Claude Code、Codex、Cursor 这类工具就能直接读你项目里的 Office 文档。
项目 8 月 3 日开源,六周左右涨到 2.1 万 star,MIT 协议。
核心优势
一、不管什么格式进来,出去的都是同一种 Markdown。这是它最值钱的设计。每种格式先解析成共享的文档模型(块、行内元素、表格、脚注、附件),再由同一个序列化器渲染。所以转义规则、标题锚点、脚注编号的表现完全一致,2003 年的老 .doc 和昨天的 .pptx 不会给你两套脾气。
二、结构保留得比较完整。带锚点的标题、粗斜体与删除线、行内代码和代码块、链接与内部交叉引用、有序/无序/嵌套/任务列表(沿用源文档自己的编号)、含合并单元格和表头的表格、引用块、脚注尾注、PPT 的演讲者备注,这些都在。
三、公式统一转 LaTeX。Word 和 PPT 的 OMML、OpenDocument 与 EPUB 的 MathML、RTF 的公式,全部转成 GitHub 风格数学语法:行内 $...$、块级 $$。这一点对写论文、做技术文档的人挺关键,很多转换器到这一步就废了。
四、快,而且不依赖外部服务。纯 Rust,没有 ML 模型,不调用接口。官方给的基准里,100 篇真实文档测试下中位转换耗时 4.4 毫秒。
五、绑定做得不粗糙。Node 的转换跑在 libuv 线程池上不阻塞事件循环,Python 会释放 GIL;TypeScript 类型和 Python stub 都随包发布。
安装和使用
最省事的是 CLI,npx 跑一次会自动拉对应平台的预编译二进制:
npx @firecrawl/anydoc report.docx
输出到文件、读 stdin、开 OCR 都可以:
npx @firecrawl/anydoc slides.pptx -o slides.md
npx @firecrawl/anydoc - --format csv < data.csv
npx @firecrawl/anydoc scan.pdf --ocr hosted
想在代码里用,Python 是 pip install firecrawl-anydoc,然后 anydoc.to_markdown("report.docx");Rust 侧 cargo add anydoc;浏览器端装 @firecrawl/anydoc-wasm。整个库跑在本地,文件不会离开你的机器。
不是没有槽点
第一,它不做 OCR。扫描版或者图片型 PDF 会直接抛 NeedsOcr 错误,不会给你半成品。要用得开 --ocr hosted,把文档送到 Firecrawl Parse 上处理。免费但有限额,想提高要自己配 API Key。
第二,走了 hosted OCR 就是整份文档上传。Parse 不支持指定页码,你只想转第 3 页那两页扫描件,也得把整本 PDF 送出去。对保密材料来说这是硬门槛。
第三,Rust crate 没有 OCR 选项,也不联网。如果你想在纯 Rust 服务里处理扫描件,这条路目前走不通,只能在 Node 或 Python 里做。
第四,基准数据是项目自己跑的。那张对标表(对标 libreoffice、unstructured、markitdown、pandoc、docling、mammoth)成绩确实好看,anydoc 在 14 个格式上得分都领先,但评测方就是作者,裁判也是用 LLM 打分。当参考可以,别当定论。
第五,更新节奏在放缓。仓库最后提交停在 8 月 28 日,剩下 92 个 open issue。新项目早期这样很正常,但如果你打算把它放进生产流水线,得留意后面维护是否持续。
跟同类怎么比
如果你只是偶尔转几个 Word,markitdown 更轻,但它只覆盖 6 种格式,表格和公式处理弱一档。pandoc 是老牌全能选手,格式转换生态最全,可惜它对 Office 二进制格式的支持本来就靠外部程序,速度和结构都不占优。
docling 更偏文档理解,带版面分析和表格识别,适合论文场景,代价是慢——中位 513 毫秒,anydoc 是 4.4 毫秒。libreoffice 命令行几乎是万金油,1.1 秒一篇的速度适合跑批,质量就一般了。
我的建议是这样:要处理大量 Office 文档喂给大模型,优先试 anydoc,几毫秒一篇的量级让它很适合做入库前的预处理;扫描件占了不小比例的话,一定要先确认你能不能接受把文档送到云端 OCR,不能接受就得另找方案;只做纯文本格式转换、又不想引入新依赖的,pandoc 依然够用。
对做 RAG 的人来说,它解决的其实是一个很脏但绕不开的工序。值得花十分钟试一下。
GitHub:https://github.com/firecrawl/anydoc
官方网站:https://firecrawl.github.io/anydoc/
标签:#anydoc #文档转Markdown #RAG #AI工具 #开源项目 #Rust
关注我,每期分享一个帮你省事的强大工具 🛠️