用编码 Agent 的人大概都有过这种体验:问一个问题,它先铺垫两句,再解释背景,最后才说出那个你想要的答案。答案本身只有一行,前面那两百个字全是客套。
账单上这些都是钱。caveman 想干的事很暴力——让 Agent 少说话。
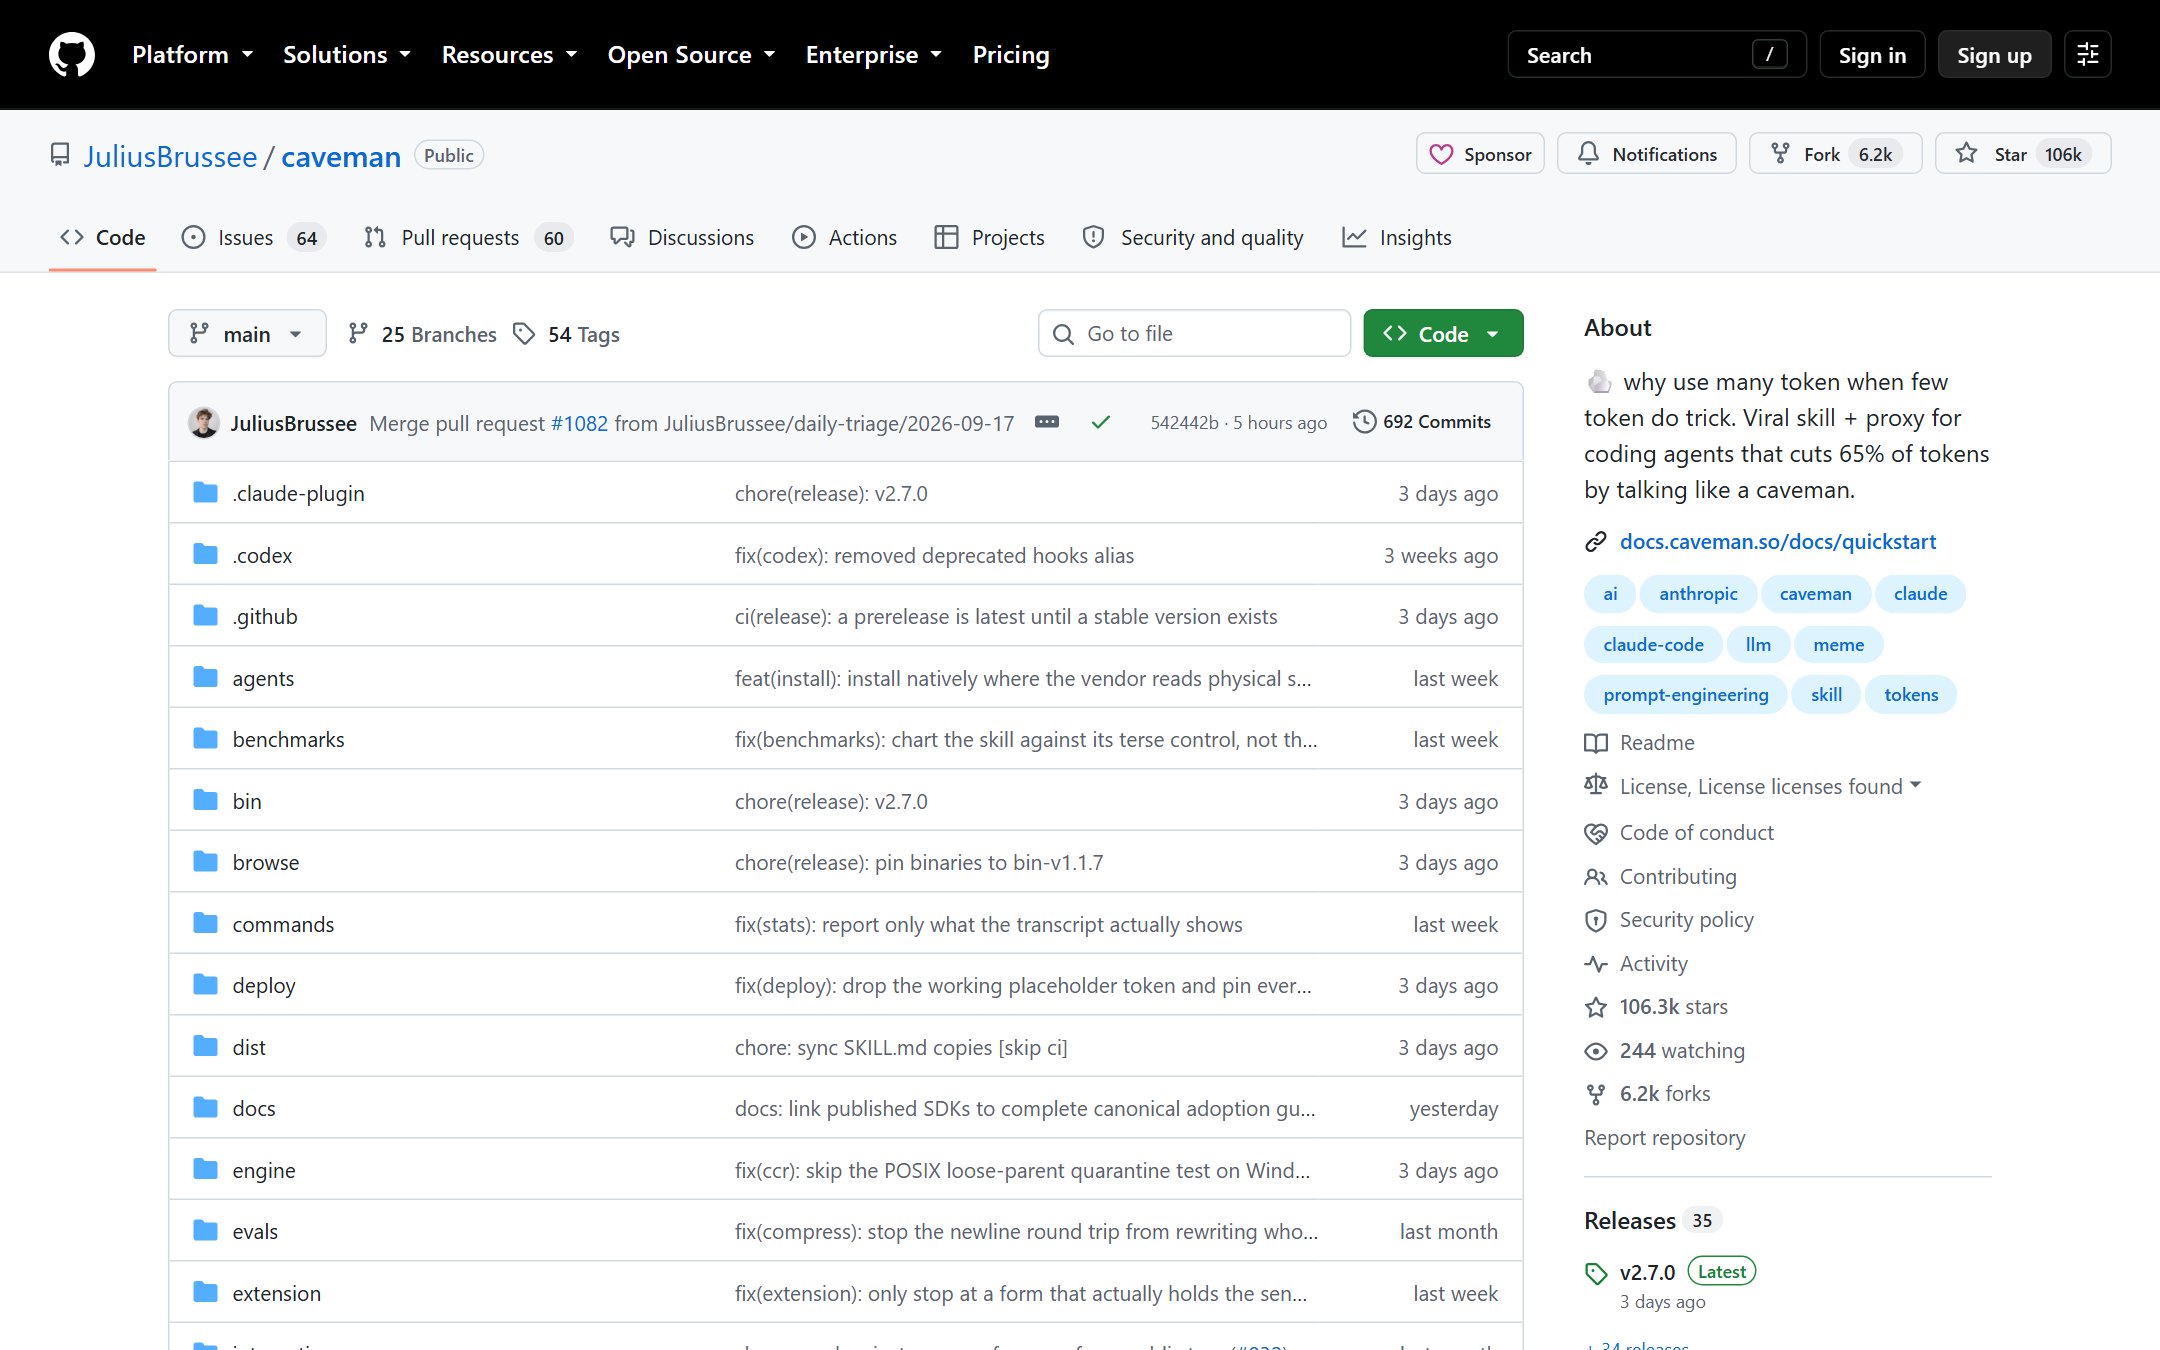
是什么
caveman 是 2026 年 4 月开源的编码 Agent 辅助工具,用 Go 写成。它的名字和那套「原始人说话」的梗是绑在一起的:让模型的回答变成 New object ref each render. Inline object prop = new ref = re-render. Wrap in useMemo. 这种电报体,把诊断、结论、修法留下,把铺垫全砍掉。
但它真正解决的不是语气问题,是 token 问题。而且它把 token 拆成两半来看:Agent 写出来的是输出 token,Agent 读进去的是输入 token。市面上绝大多数"省 token"的说法只盯着前一半,caveman 认为真正的账单在后一半。
所以它由两个独立的部分组成。一个是技能(一个规则文件),管 Agent 怎么说话,MIT 协议,不收费。另一个是本地代理(一个跑在你自己机器上的进程),管 Agent 读到的东西——日志、测试输出、JSON、diff、搜索结果,在发给模型之前先压一遍,原文存在本地 SQLite 里,Agent 随时能把全文要回去。
两个能单用,也能叠起来用。项目在 GitHub 上 10.6 万 Star,6153 Fork,当前版本 v2.7.0(2026-09-15 发布),仓库到 2026 年 9 月 17 日还有提交。它是 2026 年 4 月建仓的,五个月做到这个量级。
核心优势
数字给得比同行诚实,包括对自己不利的那一行。官方公开了一份 54 轮的 Claude Code 压测,用服务商自己上报的输入 token 计数,每个用例跑三遍,每份答案都拿精确校验器验过。总量从 88.58 万降到 59.17 万,降幅 33.2%,18 项答案校验全部通过。分场景看差别很大:CSV 找异常点从 16.58 万降到 7.45 万(-55.1%),日志里捞针从 14.88 万降到 7.41 万(-50.2%),但"仪表盘 HTML 告警"那一格是 14.07 万涨到 15.46 万,涨了 9.9%。作者没把这一行藏起来,还在旁边写了一句话:哪天我把红的藏了,你就不该再信绿的。这种披露态度在省钱类工具里很少见。
它公开承认自己什么时候没用。项目文档里专门有一节讲适用边界:如果你是按次数计费而不是按 token 计费(比如某些按 premium request 计费的订阅),回答变短不会让你少付一分钱;如果你的工作负载是纯代码生成、几乎没有叙述文字要砍,那也省不下来;短问短答的场景下,规则文件本身要占大约 1000 个输入 token,可能亏本。这些话术换成别的项目,通常会被写进"注意事项"然后一笔带过,这里是被单独拎出来讲的。
技能那一半,装上就能用,零成本。一条 npx skills add JuliusBrussee/caveman -g 装完,支持 30 多个 Agent——Claude Code、Codex、Gemini、Cursor、Windsurf、Cline、Copilot 都在列表里。强度分四档:lite 是"简短但客气",full 是默认的电报体,ultra 基本只剩名词和动词,还有一个 wenyan 档用文言文,据说是有人提了需求就顺手做了。这个技能里有三条硬规矩:不缩短代码、不改写报错信息、不拿电报体糊弄安全警告——碰到不可逆操作它会自己切回完整句子,然后再变回来。
代理那一半,换来的是"读"的节省。它跑在 Agent 和你选的服务商之间,按载荷类型分流处理:JSON、日志、代码、diff、搜索结果、纯文本六类各有各的压法。压缩前的原始内容写进本地 SQLite 并返回一个恢复句柄,Agent 觉得信息不够就能把全文拉回来。这一点很关键——很多压缩方案是单向的,压完就找不回来了,Agent 在后半程才发现自己缺了关键上下文,只能重新跑一遍,省下的钱又吐回去。
顺带它还压别的东西。浏览器页面用 caveman browse 取压缩视图:一个 200 行的表格,直接给 Agent 的 Playwright 快照是 15704 个 token,压缩后是 121 个,小了 129.8 倍。写记忆文件有 /caveman-compress:拿五份真实的 CLAUDE.md 类文件测,平均小 46%,标题、代码、路径、链接逐项校验没丢。连技能自己都能压——渲染成 PNG 图片让模型读,估算从 1069 个 token 降到 415 个。
安装/使用方法
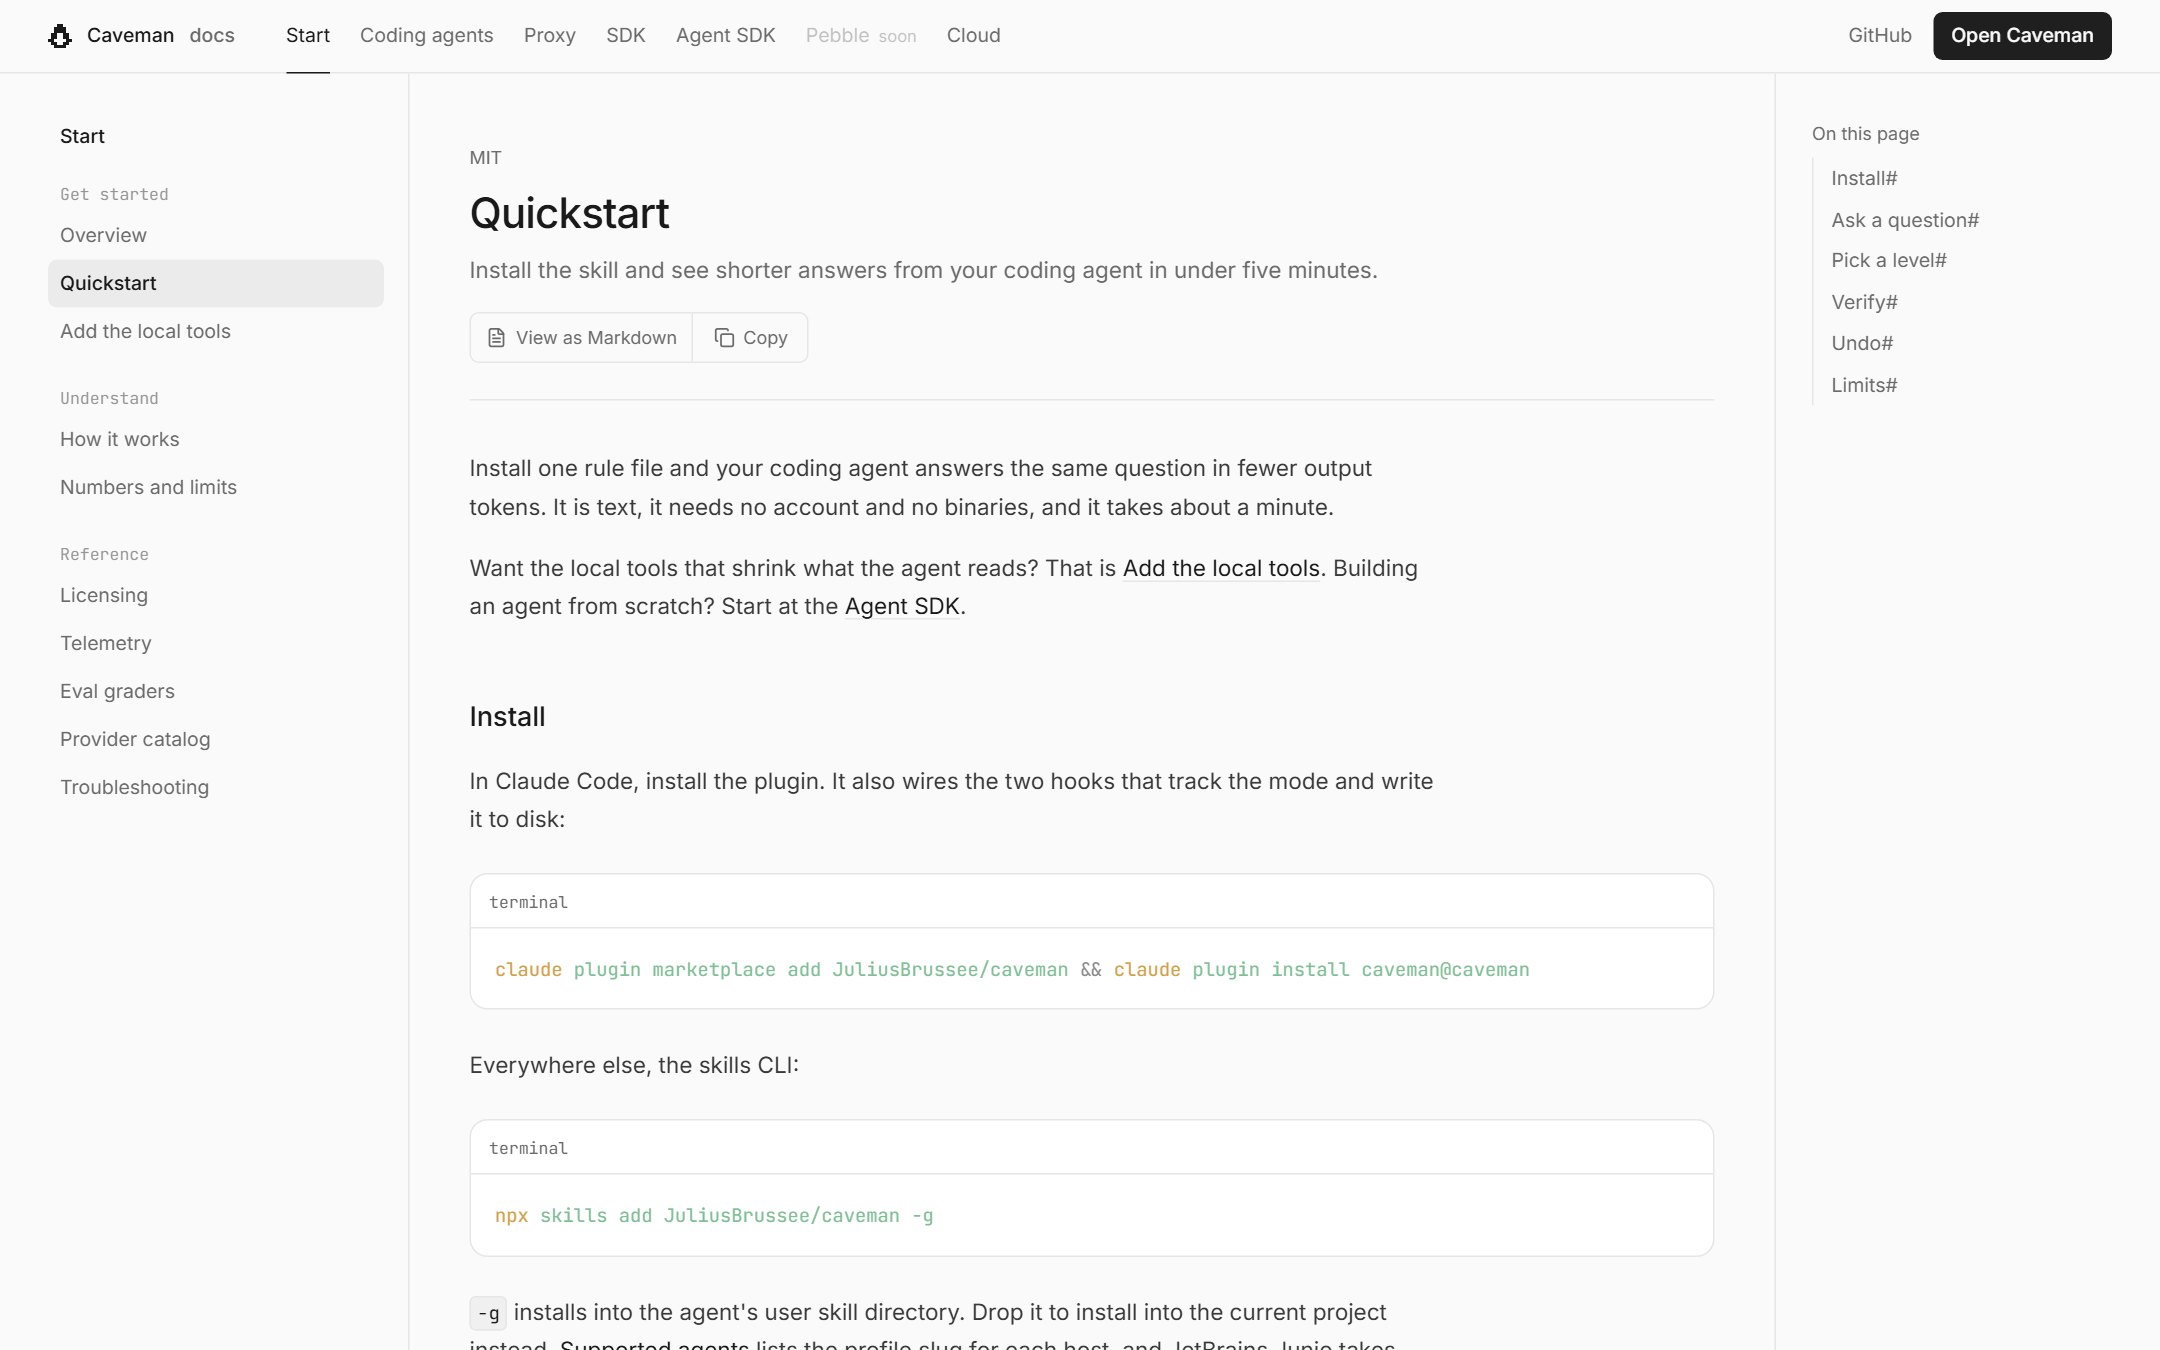
先装小的那个。技能只要一条命令:
npx skills add JuliusBrussee/caveman -g
如果想用完整安装器(会去找你机器上所有受支持的 Agent,并且给 Claude Code 挂上钩子和状态栏角标),macOS / Linux 用 curl -fsSL https://raw.githubusercontent.com/JuliusBrussee/caveman/v2.7.0/install.sh | bash,Windows PowerShell 用 irm https://raw.githubusercontent.com/JuliusBrussee/caveman/v2.7.0/install.ps1 | iex,需要 Node.js 22.13 或更新版本。装完在 Agent 里敲 /caveman 就算生效。
再装代理:
npm install -g @caveman-ai/cli && caveman setup --install
装完之后建议按这个顺序走。先用 caveman learn,它会读你磁盘上已经攒了几个月的历史记录,本地分析,把你的 token 黑洞按严重程度排出来,每个后面附一行修法。这一步不联网、不改东西,是最值钱的五分钟。然后 caveman learn implement 把每条修法一次一个 diff 交给你确认,改完如果 token 没降会自动回滚。
接着把 Agent 包起来:caveman claude,换成 codex、gemini、aider、opencode、pi 都行,比如 caveman shrink -- pnpm test 可以单独压一条命令的输出。最后用 caveman trial -- claude 跑一次对照实验,同一批任务开关各跑一遍,caveman trial report 出对比报告——文档里说得很直白:这个自测数字比页面上任何一个官方数字都更值得信。要是它测不出来,它会明说测不了,而不是给你一份全是零的报告。
有一点要提前知道:caveman 命令行默认会发匿名使用统计。发的是哪些命令跑了、过了多少 token、省了多少;不发 prompt、代码、文件路径或任何可识别信息。第一次运行会告诉你这件事,介意的话一条 caveman telemetry off 永久关掉,或者设 DO_NOT_TRACK=1。
不是没有槽点
许可证是拆开的,得看清楚。技能、CLI、SDK 这些是 MIT,但引擎和相关运行时是 BSL-1.1——源码可见,自用和自托管免费(含生产环境),但拿它给第三方做托管服务需要商业授权。每个版本会在 2030 年 6 月 21 日或发布满四年(取较早者)自动转成 Apache-2.0。对绝大多数个人和自用团队没影响,但如果你的打算是把这套东西包进一个对外售卖的产品,这一条必须先问清楚。
它没有免费额度,也不会替你和模型服务商搭桥。你的 Agent 还是连你自己选的服务商、用你自己的密钥,caveman 只是夹在中间的一个本地进程。所以它省钱的上限,取决于你的账单本身是不是按 token 算的。
规则文件本身要占输入。完整技能大约 1000 个估算 token,每一次调用都会跟着上。如果你的用法就是问一句答一行,省下的输出还不够付这个开销。文档说得很清楚,这种场景建议直接关掉。
实测数据的覆盖面有限。那份 54 轮的压测是仓库里的一份固定报告,原始测试产物不在代码库里,官方自己标注说请当成"一份固定报告"看,不是"可以被公开复现的基准"。用例只有 6 个,样本量按统计学标准不算大。另外,第三方最严谨的一次 A/B 是 JetBrains 在 2026 年 7 月做的,只测了技能那一半(当时代理还没发布),86 个真实编码任务,输出 token 少 8.5%、成本约少 10%、质量未检出差异——这个数字比仓库宣传的要保守得多,而官方把 8.5% 这个保守数字放在显眼位置,也正是因为这个数字才决定去做代理。浏览器页面那条红行更是明摆着的反例。
项目还在快速迭代期。仓库到 2026 年 9 月中旬有 124 个打开状态的 issue,各种子仓库的状态也不一样——官方列了七个相关仓库,其中三个标注为"已冻结"。冻结的仍然能装能用,但如果你是冲着长期维护去的,得先看清自己用的是哪一块。
跟同类怎么比
省 token 这件事上,市面上的做法大致分三类。一类是"换个更小的模型",但那会直接改变答案质量,不可逆。一类是上下文管理框架(自己做摘要、自己做裁剪),效果取决于你自己写的策略好不好,门槛高。还有一类就是提示词约束,让模型自己少说点——这一类最简单,但也最容易被当成玄学。
caveman 的位置比较特殊:它把这三条里最玄的那条做成了可测量的,又在中间夹了一个真在动数据的代理。同时它自己承认,纯提示词那部分的收益在真实编码任务里只有个位数,大头得靠代理去压"读"。这种"先告诉你哪部分没用,再说哪部分有用"的顺序,至少比反过来要可信。
更实际的一条判断标准是:如果你的账单是按 token 计价的,并且你经常让 Agent 读日志、读测试输出、读配置 diff,那它值得花半小时试一次,最好按官方建议自己做一次开关对照,看你自己账单上的数字。如果你的计费单位是"次数",或者你几乎不读大文件,那这个工具对你意义不大,直接跳过就行。
项目地址:https://github.com/JuliusBrussee/caveman
文档站:https://docs.caveman.so/docs/quickstart
标签:#caveman #省Token #编码Agent #上下文压缩 #AI编程工具 #本地代理
你有没有算过,自己一个月的编码 Agent 账单里,是"写"花得多,还是"读"花得多?