先说一个数字:744B 参数的模型,就算量化到 int4,权重也有 370GB 左右。常规推理引擎的做法是把权重全塞进显存,所以这个量级的模型长期只能在云端的大机器上租着用。你的笔记本不是不行,是压根装不下。
Colibrì 换了个前提。它不追问"怎么把 370GB 塞进 24GB 显存",而是先承认装不下这件事,然后重新设计一个更基础的问题:哪些权重真的需要常驻,哪些可以放在盘上等着被叫。
是什么
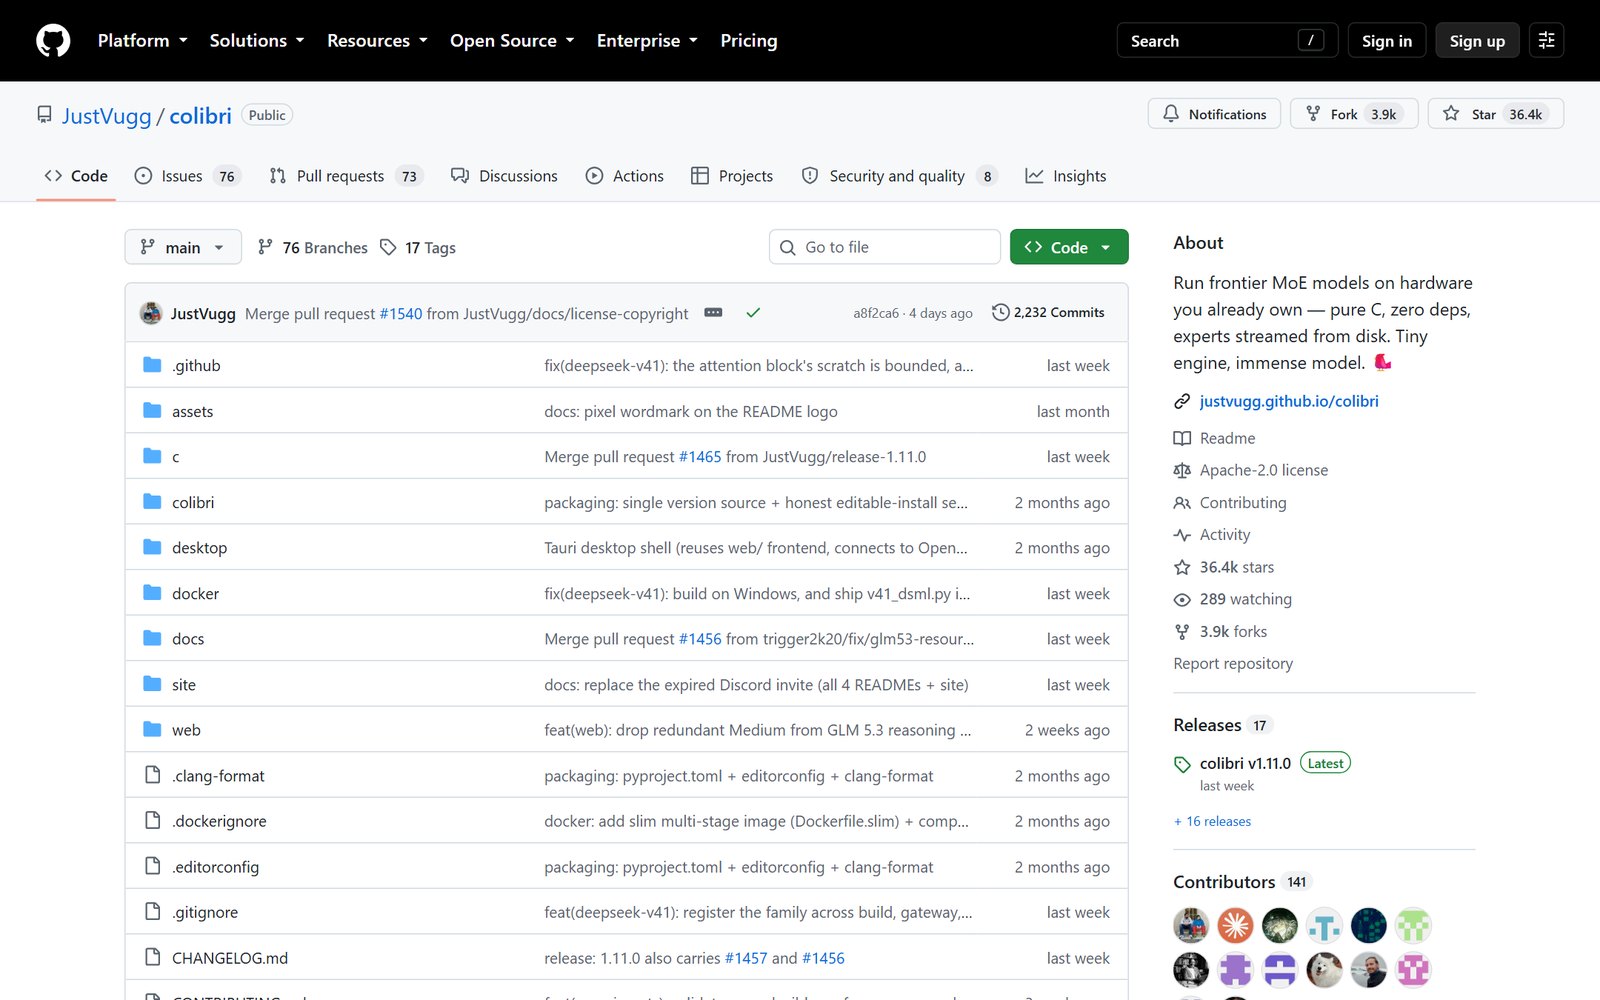
它是纯 C 写的 MoE 推理引擎,Apache-2.0 协议,把显存、内存、NVMe 固态盘当成同一套存储层级来用:密集层常驻内存,路由专家留在盘上按需流式读取。引擎本体是一个 C 文件(c/colibri.c 加几个小头文件),没有 BLAS,运行时不需要 Python,也不要求有显卡。Python 只出现在一次性的模型转换和可选的 API 网关上,CPU 侧并行靠 OpenMP。
仓库 3.6 万 Star、3860 Fork,2026 年 7 月建起来,两个月出头冲到现在这个量级。当前版本 v1.11.0,9 月中旬还有提交,149 个 open issue 里能看到作者在逐条回。
核心优势
它的算法前提是稀疏性,账算得很清楚。744B 的 MoE 每个 token 只激活约 40B 参数,而这里面逐 token 变化的只有约 11GB,也就是被路由选中的那批专家。GLM-5.2 的密集部分(注意力、共享专家、词嵌入)约 17B 参数,int4 之后约 9.9GB,常驻内存;剩下 19456 个路由专家(75 层乘 256,再加一个 MTP 头,每个 int4 约 19MB)总共约 370GB,留在盘上。作者把这个思路叫"给权重做 JIT":编译器不会把整个程序编完,它只盯着真正跑起来的热路径,边跑边编。
它是会变快的,因为你用过。引擎记录你的工作负载实际路由到哪些专家(.coli_usage,每轮更新),把最热的一批自动钉在快层里;每层还有独立的 LRU 缓存。另外单独起一个线程让路由提前一层跑(PILOT=1),把下一层的专家提前读进来。README 给的实测是路由一层可预测率 71.6%,也就是大多数预取在下一次真的读之前就已经到位。读的时候它还有两个省事的设计:每个专家的三个矩阵存在相邻位置、一次 pread 读完;一批位置走 batch-union,同一个专家一轮只读一次。异步 I/O 池(PIPE=1,默认开)负责在常驻专家计算的同时把缺的读进来。
第二块盘不是摆设。解码在多数机器上是磁盘瓶颈,而专家数据只读。所以如果你手上有第二块 SSD,把一份完整镜像放上去,引擎按实测带宽做加权哈希把专家分到两块盘,读带宽就是两块盘相加,实测 9GB/s 配 3GB/s 的组合比只用快盘快约三分之一。镜像启动时逐文件校验大小和 safetensors 头,对不上就安静地退回主盘,所以放个部分镜像(小盘只装一部分分片)也有用;镜像只读不写,读取出错只是降级报警不会崩。
KV 状态压了 57 倍,而且能跨重启。MLA 注意力把每 token 的 KV 状态从 32768 个浮点压到 576 个,压完还持久化到 .coli_kv,对话重开是热的,不用重新 prefill,跟没中断过一回事。项目强调这不是"换个更小的模型",同一个 int4 容器前向传播和 transformers 做过教师强制验证。
速度上限和下限都写出来了。6 张 RTX 5090 全驻留:5.8–6.8 tok/s,TTFT 约 13 秒;128GB 纯 CPU 台式机热态约 1.8 tok/s;单张 RTX 5070 Ti 的笔记本级机器 1.07 tok/s;25GB 开发机冷启动 0.05–0.1 tok/s。同一个引擎,同一份 int4 容器,硬件只决定专家住在哪一层。
怎么用
需要两样东西:程序(几百 KB)和模型(372GB)。程序从 Releases 下对应平台的压缩包解开即可,Linux、macOS、Windows 都有预编译版,解压后 python3 coli info 就能确认引擎可用。想自己编就从源码走:git clone 之后进 c/ 目录跑 ./setup.sh,它会检查 gcc 和 OpenMP、编译、顺手跑一遍自测。
然后准备模型。GLM-5.2 有一份转好的 int4 容器放在 Hugging Face,约 372GB,需要一块放得下的盘(最好是快的)。也可以从 FP8 源自己转,转换命令是分片的、可续传,不需要同时占满 756GB 空间。
跑起来前先看它打算怎么放:COLI_MODEL=/nvme/glm52_i4 ./coli plan 打印 VRAM/内存/磁盘的放置方案;./coli doctor 做只读体检,加 --deep 会把张量、分片、索引、镜像都查一遍;./coli tune 测出这台机器上最快且安全的执行档位并存下来。之后 ./coli chat 交互聊,./coli web 起 API 加仪表盘并自动开浏览器,./coli serve 只起服务不开浏览器。Windows 的压缩包里带 coli.cmd,双击就能走快速开始。
目前跑得动的有九个家族:GLM-5.2/5.3(744B)、GLM-5.3-Flash(321B,带视觉)、Inkling(975B)、Kimi K3(2.8T)、DeepSeek V4 Flash(284B)、DeepSeek V4.1 Flash(552B,带视觉)、Qwen3.8-Flash-Next(125B 加 51B n-gram)、Qwen3.6(35B-A3B)和 OLMoE(7B)。每个家族的硬件要求差别很大:OLMoE 只要约 7GB 盘和 8GB 内存,GLM-5.2 要 372GB 盘加 16GB 内存起,Kimi K3 要 1.6TB 盘和 32GB 以上内存。都是"不需要显卡"。
不是没有槽点
慢是真慢,作者自己也不掩饰。README 里写明"不承诺速度 SLA,只承诺语义":快内存不够只会让它变慢,不会偷偷改你的模型精度和路由语义。25GB 开发机冷启动 0.05–0.1 tok/s,基本只能用来验证"它真的能跑",谈不上日常使用。
门槛从显卡挪到了盘。372GB 是起步,Kimi K3 要 1.6TB。你省下了几万块的卡钱,但得先有这么大一块 NVMe,而且盘的速度直接决定体验。作者的说法是"速度由你的盘决定"。
模型容器挑得很细,用错会踩坑。GLM-5.2 必须用 group-scaled 的 gs64 容器配 int8 的 MTP 头。README 里说得很直白:旧的 per-row int4 镜像质量上差约 9 个百分点,还是早期"思考模式打转、生成不收敛"那批问题的根因;MTP 头如果误用 int4,草稿接受率会掉到 0–4%。这类细节不看文档直接下个量化版就上,很容易以为是引擎不行。
有一批开关是"看你的硬件说话"的经验值。比如 DIRECT=1(走 O_DIRECT 绕开页缓存)在带 DRAM 缓存的盘上实测 +34% 解码速度,但在 QLC 或者无缓存盘、虚拟化磁盘上可能是零收益甚至负收益。双盘的带宽模型也只是"实现了、验证过、还需要更大规模的社区 A/B"。项目自己的建议就是:先试,硬件给回报的才留下。
它还处在"一半东西仍是假设"的阶段。README 专门列了六条待验证假设:学习型 pin 会不会在别的负载上过拟合、双盘带宽模型、硬件感知规划器能不能逼近人工调优、路由感知的投机解码在什么区间才划算等等。这是它诚实的地方,也说明别把它当交付级基础设施。它更像一个开放研究平台,只不过恰好今天就能跑。
跟同类怎么比
对 llama.cpp 和 Ollama。这两个的目标是"让模型装得下",靠量化把几十 B 以内的模型压进内存和显存,体验是开箱可用、速度体面。Colibrì 走的是相反的路线——装不下就流式读,目标是几百 B 到 2.8T 这一档,速度换容量。你手上有 8GB 显存想跑 7B,用前者;你想在自有硬件上碰 744B,用后者。
对 vLLM 这类多卡推理框架。它们的路线是把吞吐做到极致,前提是权重能常驻显存。Colibrì 在多机上换了种拆法:协调节点留在本地管生成和路由,专家节点只负责执行被路由到的 FFN,一层路由的并集打包成一条持久 TCP 请求发过去,不会每个专家一次往返。中小规模集群也能跑超大模型,因为不是每台机器都得存 370GB 专家。
对直接租云 API。租的优点是快、省心、随开随用,缺点是按 token 付费、数据出内网、模型版本不由你定。Colibrì 给的是"持有":能探它、量它、改它。适合离线环境、数据不能出门的场景,以及就是想研究推理侧优化的人。
一句话判断:如果你要的是能立刻上手的本地助手,先去用 Ollama;如果你想在自己的机器上真的跑起一个 744B,愿意接受一两 tok/s 和一块大容量快速 NVMe,那这个项目现在就能给你结果。
项目地址:https://github.com/JustVugg/colibri
官方网站:https://justvugg.github.io/colibri
标签:#Colibri #本地推理 #MoE #大模型部署 #C语言 #Apache2
你更愿意为一块大容量 NVMe 一次性花钱,还是继续按 token 付费?