用 AI 助手的人都经历过这个循环:今天跟它讲清楚了自己在做什么项目、用什么技术栈、不喜欢什么写法,明天开个新对话,一切归零,又得从头交代一遍。聊得越久越明显——它不是不聪明,是根本记不住。
上下文窗口拉长只能缓解一部分,因为你不可能把三个月的聊天记录全塞进去:贵,慢,而且塞进去之后模型反而更容易抓错重点。mem0 想解决的是这个问题中间的那一层——决定什么值得记下来、什么时候该把它捞出来。
是什么
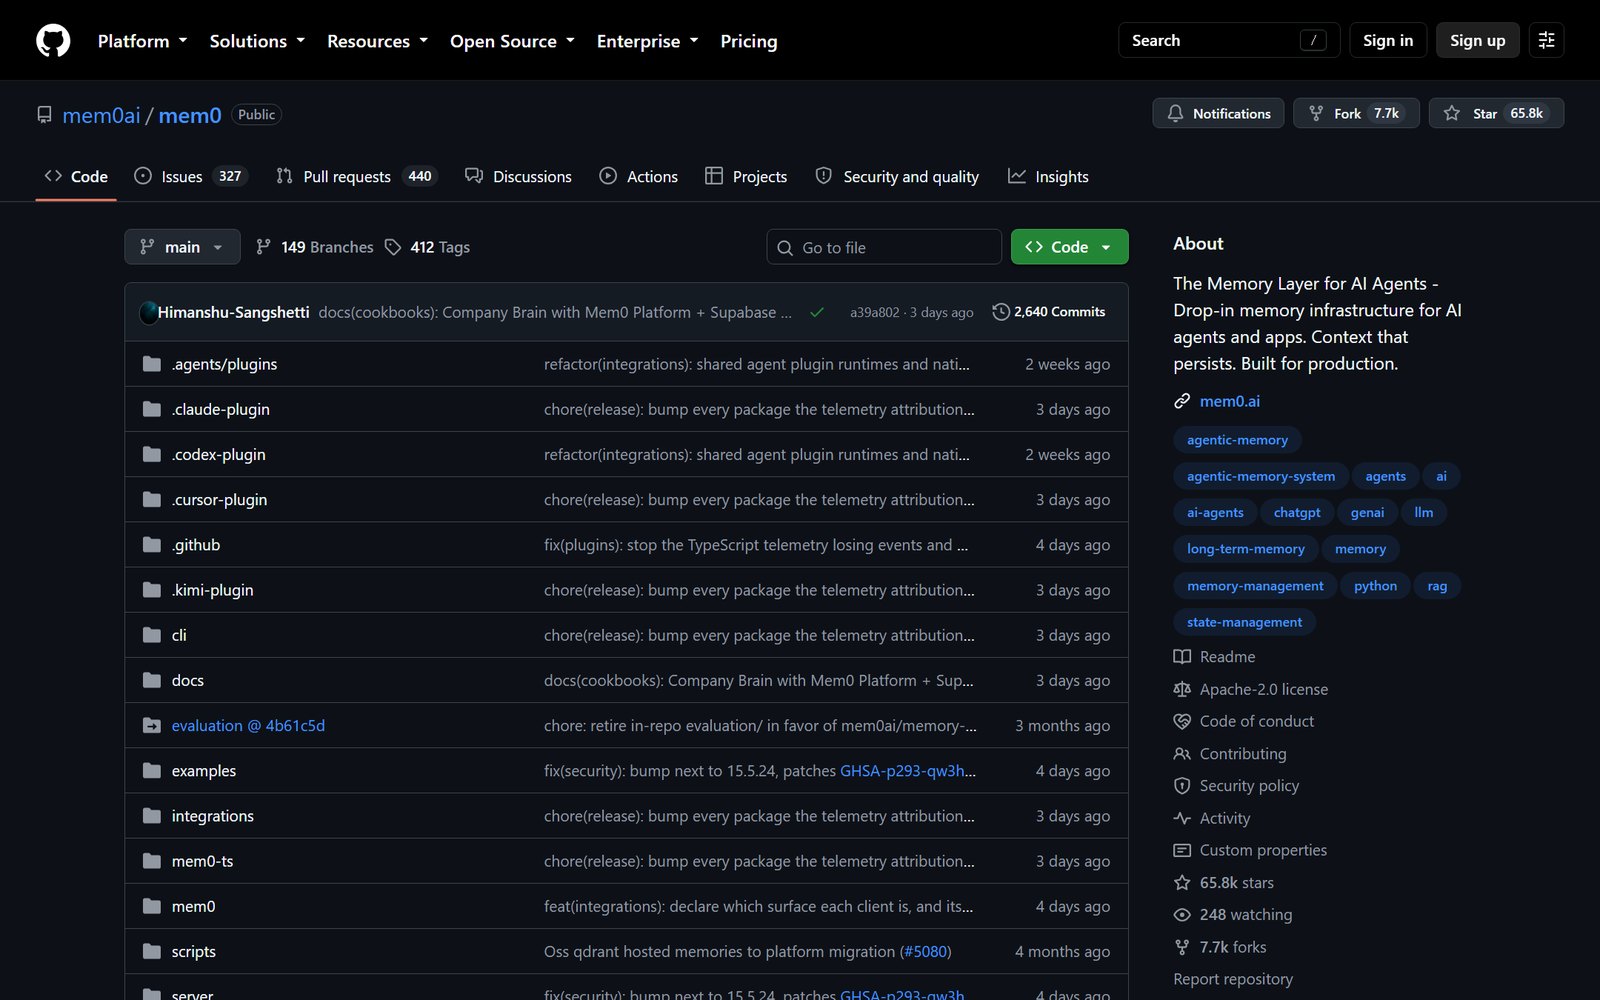
mem0ai/mem0,Python 写的 AI 记忆层,Apache-2.0 协议,6.5 万 Star、7725 Fork,当前版本 v2.1.0(9 月 18 日发布),当日仓库还有提交,待处理 Issue 327 个、待合并 PR 440 个。项目 2023 年 6 月建仓,是 Y Combinator S24 的项目,也发过论文(arXiv 2504.19413)。
要注意它不是向量数据库。向量库解决的是"怎么快速找到相似的文本",mem0 解决的是"这段对话里有什么值得长期记住、该以什么形式存、下次什么情况下取出来"。它架在向量库和模型之间:底下可以接 Qdrant、pgvector 这类存储,上面接你自己的模型,中间这层抽取、去重、检索融合的逻辑才是它的本体。
它有三种形态,按投入递增:装个库直接用、docker compose 起一个自托管服务、或者用官方云平台。README 给的建议很直白:只是在试就用库,给团队做就自托管,一点运维都不想碰就上云。
核心优势
检索成本压到了几千 Token 这个量级。这是它最值得看的一页数字。今年 4 月换掉旧算法之后,官方基准里单次检索(一次调用、不走 agent 循环、检索预算取前 200 条)的 Token 消耗在 6.7K 到 7.0K 之间,p50 延迟一秒出头。分数那边:LoCoMo 从 71.4 提到 92.5,LongMemEval 从 67.8 提到 94.4,其中助手记忆召回这一项是 98.2;另外还有两个百万级 Token 的 BEAM 测试,分别是 64.1 和 48.6。同一套检索路径,分数涨了二三十点,Token 反而更省——这两件事同时发生,才是这个版本真正的看点。
不过 README 自己写得很清楚:这组数字跑在官方托管平台上,包含了一些开源 SDK 里没有的优化,开源用户应该预期"方向类似但数字不完全一样"。这句话挺少见地诚实,也让上面那组数更可信一些——它没打算把基准当宣传页用。
写入改成只增不删,旧信息不会莫名其妙消失。新版做法是一次模型调用完成抽取,不做 UPDATE 和 DELETE,记忆只累积、不覆盖。连带的一个变化是:Agent 自己确认过的动作结果也算一等公民,和别人说的话一样权重存进去。好处很好理解:你再也不用担心某次抽取把之前存对的东西改坏了。代价下面会说。
检索是三种信号一起投票。语义相似度、BM25 关键词、实体匹配三路并行打分,再融合排序。单走向量的老问题很好举:问"我上次说的那个方案",纯语义匹配很容易飘;而关键词那一路会因为"方案"这个字命中得更准。它还做了实体链接——把提到的实体抽出来做 embedding 并在记忆之间连起来,用来给召回加分。
带时间感。问"我现在用什么部署方式""上次那个 bug""下周要交的活"这类问题时,检索会按时间点去挑对应的那条记忆,而不是把所有相关记忆混成一锅粥。长期记忆里最烦的就是这种时序错乱,这块做了专门处理。
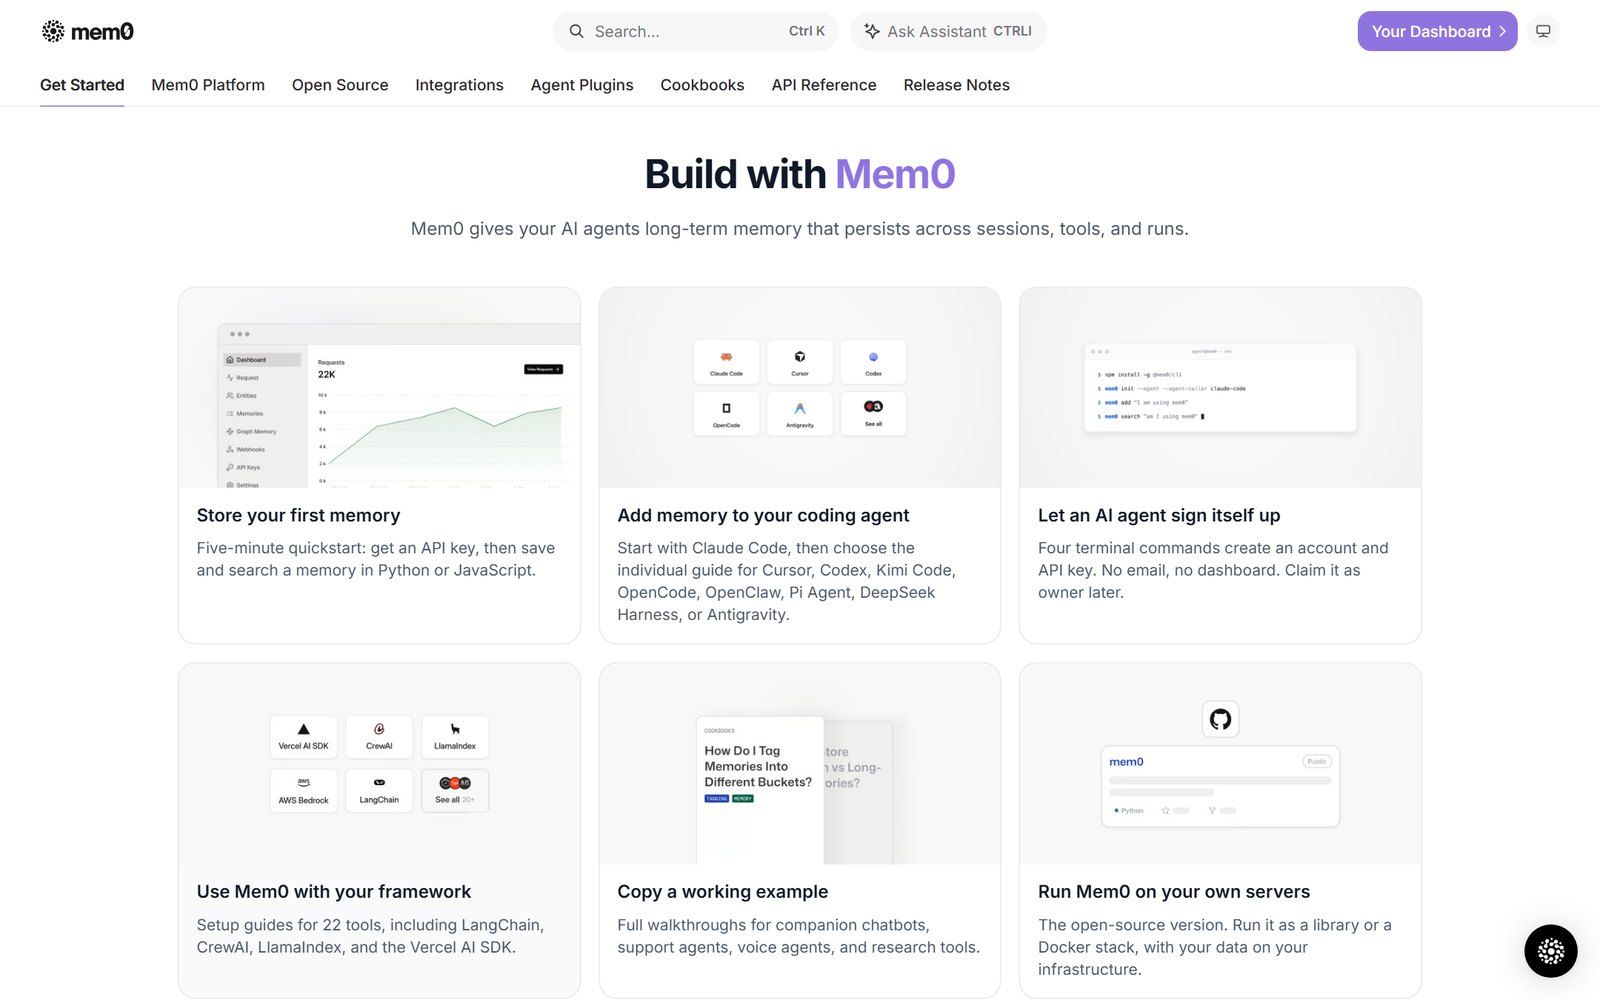
Agent 可以自己注册,不用人先开账号。这个小设计挺有意思:装完 CLI 跑 mem0 init --agent --agent-caller claude-code,四条命令走完就能拿到一把可用的密钥——不用邮箱、不用开后台、不用等验证码。人类主人之后随时可以用 mem0 init --email 把这个账号认领过来,密钥不变、记忆不动。对让 Agent 自己搭自己那套环境的用法来说,这一步省掉的事不少。
它对现在主流的编码助手做了适配。官方出了一批 skill,直接 npx skills add 装进 Claude Code、Codex、Cursor 这类工具里,有常驻的知识型(SDK 用法),也有按需跑流程的(把一个已有的仓库接进 mem0、跑通之后做验证)。
怎么用
最简单的路径就是一行安装:pip install mem0ai。然后 Memory() 实例化,写入用 memory.add(消息列表, user_id="某人"),读取用 memory.search(query=问题, filters={"user_id": "某人"}, top_k=3),把返回的记忆拼进系统提示词就行。官方 quickstart 里那个循环对话的例子只有几十行,基本可以直接拿去改。
要用上完整能力还得配两样东西:一个模型(默认是 gpt-5-mini)和一个 embedding 模型(默认是 text-embedding-3-small)。想开混合检索那套关键词和实体加分,得装带 NLP 支持的额外依赖,再下一个 spacy 的语言包;embedding 那边官方建议至少用 Qwen 600M 以上的量级,效果会比默认的好。
不想写代码就用 CLI:mem0 add "..." --user-id 和 mem0 search "..." --user-id,在终端里就能管记忆。给团队用就走自托管,cd server && make bootstrap 一条命令把整套栈起来、建好管理员、签发第一把密钥;手动起也行,docker compose up -d 之后在浏览器里走一遍向导。
不是没有槽点
它需要模型,就有持续成本。写入记忆要调模型做抽取,检索时的实体链接也可能要用 embedding 服务。也就是说每次对话都比不用记忆时多花一点钱。省下来的是"把全部历史塞进上下文"那笔更大的开销,但这笔账得自己算,别默认它一定便宜。
只增不删是把双刃剑。记忆只累积不覆盖,好处是安全,坏处是一年之后库里会躺着大量过时甚至自相矛盾的信息。用户换了工作、换了技术栈,旧记忆还在。"现在用什么框架"这种问题,靠时间感知能挑对,但"用户到底偏好什么"这类偏好会越堆越乱。怎么淘汰、什么时候合并、多久清一次,官方没有替你解决,这是要自己设计的部分。
它不是知识库,别拿它塞文档。mem0 存的是关于"人"和"交互"的碎片化事实,不是一篇篇完整文档。你要做的是把产品手册、规章制度检索出来,那该用 RAG——两者解决的问题不一样,混着用通常两边都做不好。
自托管这版有鉴权,从旧版本升上来会踩坑。自托管默认开了鉴权,如果你从没有鉴权的旧构建升上来,要么先设 ADMIN_API_KEY,要么走一遍向导注册管理员;把它设成 AUTH_DISABLED=true 只适合本地开发,别带去线上。
跨语言的细节没那么多。默认的 embedding 和 spacy 语言包都是以英文为主调的。中文场景不是不能跑,但实体抽取和关键词那一路的收益会打折,得自己换模型、试参数。这类"中文要额外调"的活,基本是同类项目的通病。
跟同类怎么比
对"纯向量库加自己拼提示词"。这是最常见的自建方案,灵活、零依赖,问题出在两头:写进去的时候没人替你判断什么值得留,读出来的时候也只有一个相似度分数。用户随口提一句"我住北京",你是存还是不存?下次问天气要不要带上?这些判断正是 mem0 替你做的部分。如果你的场景简单到只需要"把文档切块存起来再检索",那真的不需要它。
对模型厂商自带的记忆功能。那些功能开箱即用,零开发成本,代价是绑在那个产品里——换模型、换供应商,记忆带不走,数据结构你也看不到。自己做一层的好处是可迁移、可控、可审计,代价是要自己搭、自己维护。个人图省事就用自带的;做产品要给用户承诺"记忆归用户所有",那得自己搭。
对 RAG 那套知识库方案。不是竞品关系,是两层。RAG 管的是公共知识的检索,mem0 管的是个体交互历史的沉淀。真做产品,通常是两个都上——底层检索知识文档,上层记住"这个用户是谁、上次做到哪一步"。
对同赛道的其他记忆项目。这个方向最近一两年挤进来不少方案,路线也不太一样:有的往知识图谱那边靠,强调实体之间的结构化关系;mem0 更偏"轻量一层、随插随用"。选哪个主要看你愿意为结构化付出多少清洗成本。图谱类方案在关系推理上更强,但灌进去的数据得先规整好。
一句话:你在做的 AI 应用已经进入"同一个用户会反复来"的阶段,加一层记忆的边际收益就很高;你只是一次性问答工具,加它纯属给自己找活干。
项目地址:https://github.com/mem0ai/mem0
文档:https://docs.mem0.ai/
标签:#mem0 #AIAgent #长期记忆 #开源工具 #Python #RAG
你用 AI 助手的时候,最希望它记住的是你的偏好、你的项目背景,还是你们上次聊到哪一步?