公司那套后台系统,导出上个月的报表要点开"财务中心",再进"报表管理",选月份,勾表单,点确认,最后在弹窗里点下载——六步,二十来次点击。新同事培训第一课就是背这个路径。
这类界面本身没问题,问题在于它只认鼠标。Page Agent 想干的事,是让页面自己听懂"帮我把上个月的销售报表导出来"。而且是真正动手点,不是给个答案。
是什么
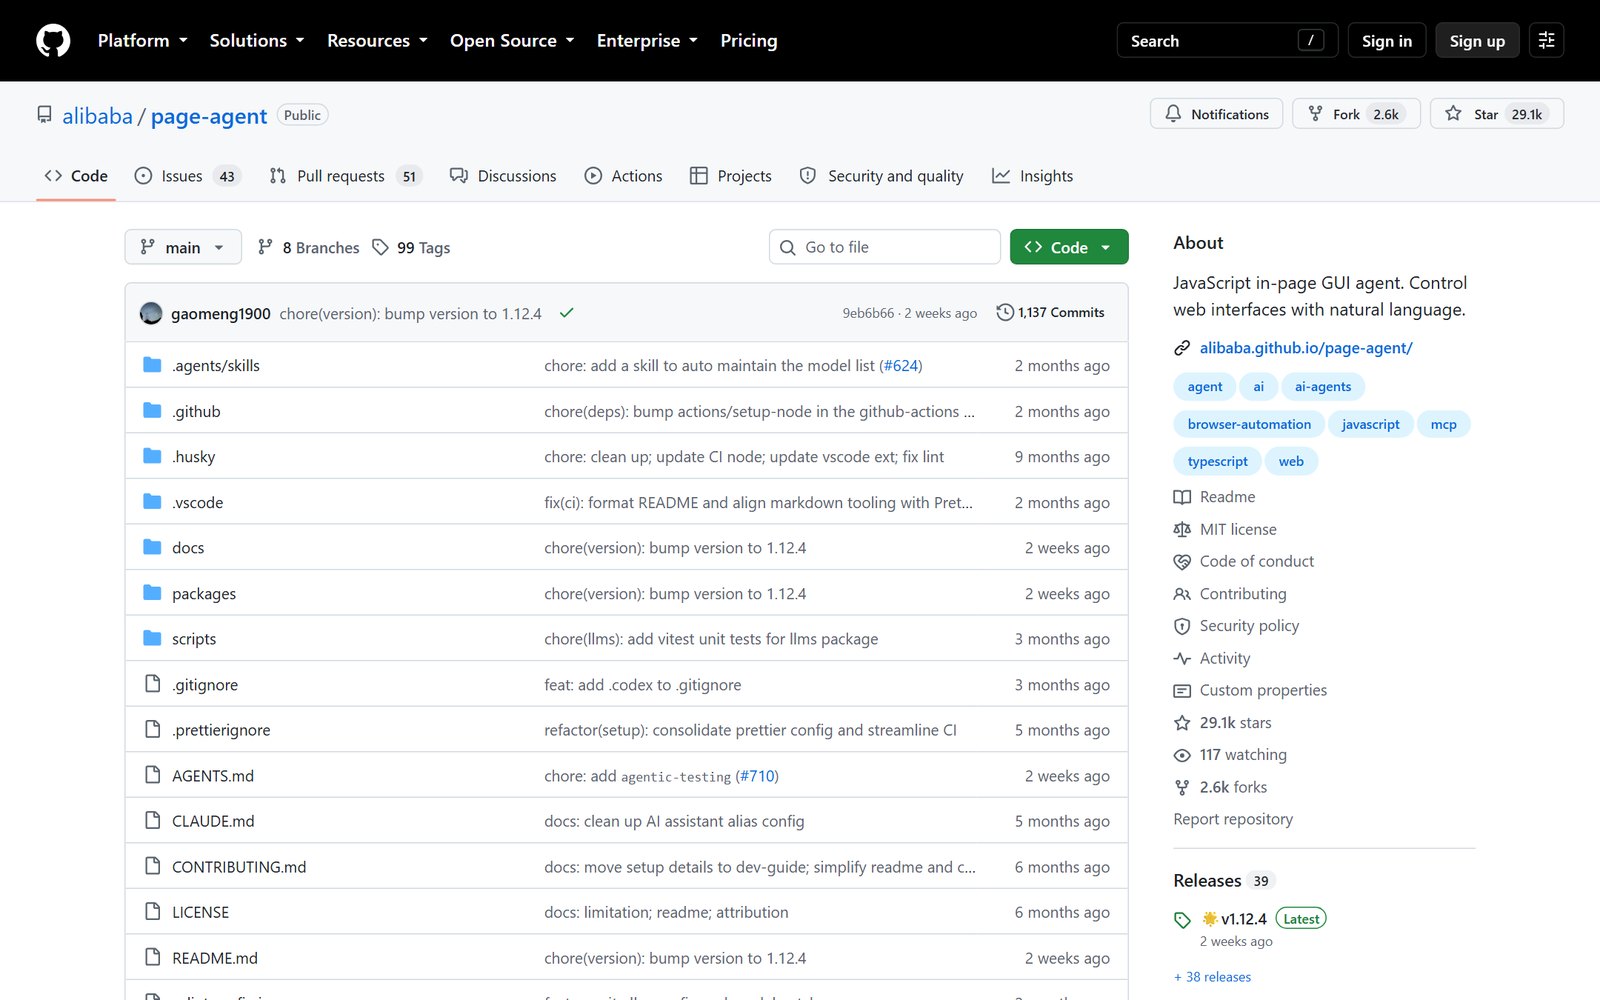
阿里巴巴开源的一个 JavaScript 库,MIT 协议,2.9 万 Star、2616 Fork,当前版本 v1.12.4,npm 上包名就叫 page-agent。它的定位一句话能说完:把 GUI Agent 嵌进网页里。
和常见方案相比,它少了三样东西——不装浏览器插件,不起无头浏览器,不需要 Python 环境。全部逻辑跑在页面自己的 JavaScript 里。还有一点值得单独拎出来:它读的是页面的 DOM 结构文本,不是截图。这意味着驱动它不需要多模态模型,普通文本模型就够。
核心优势
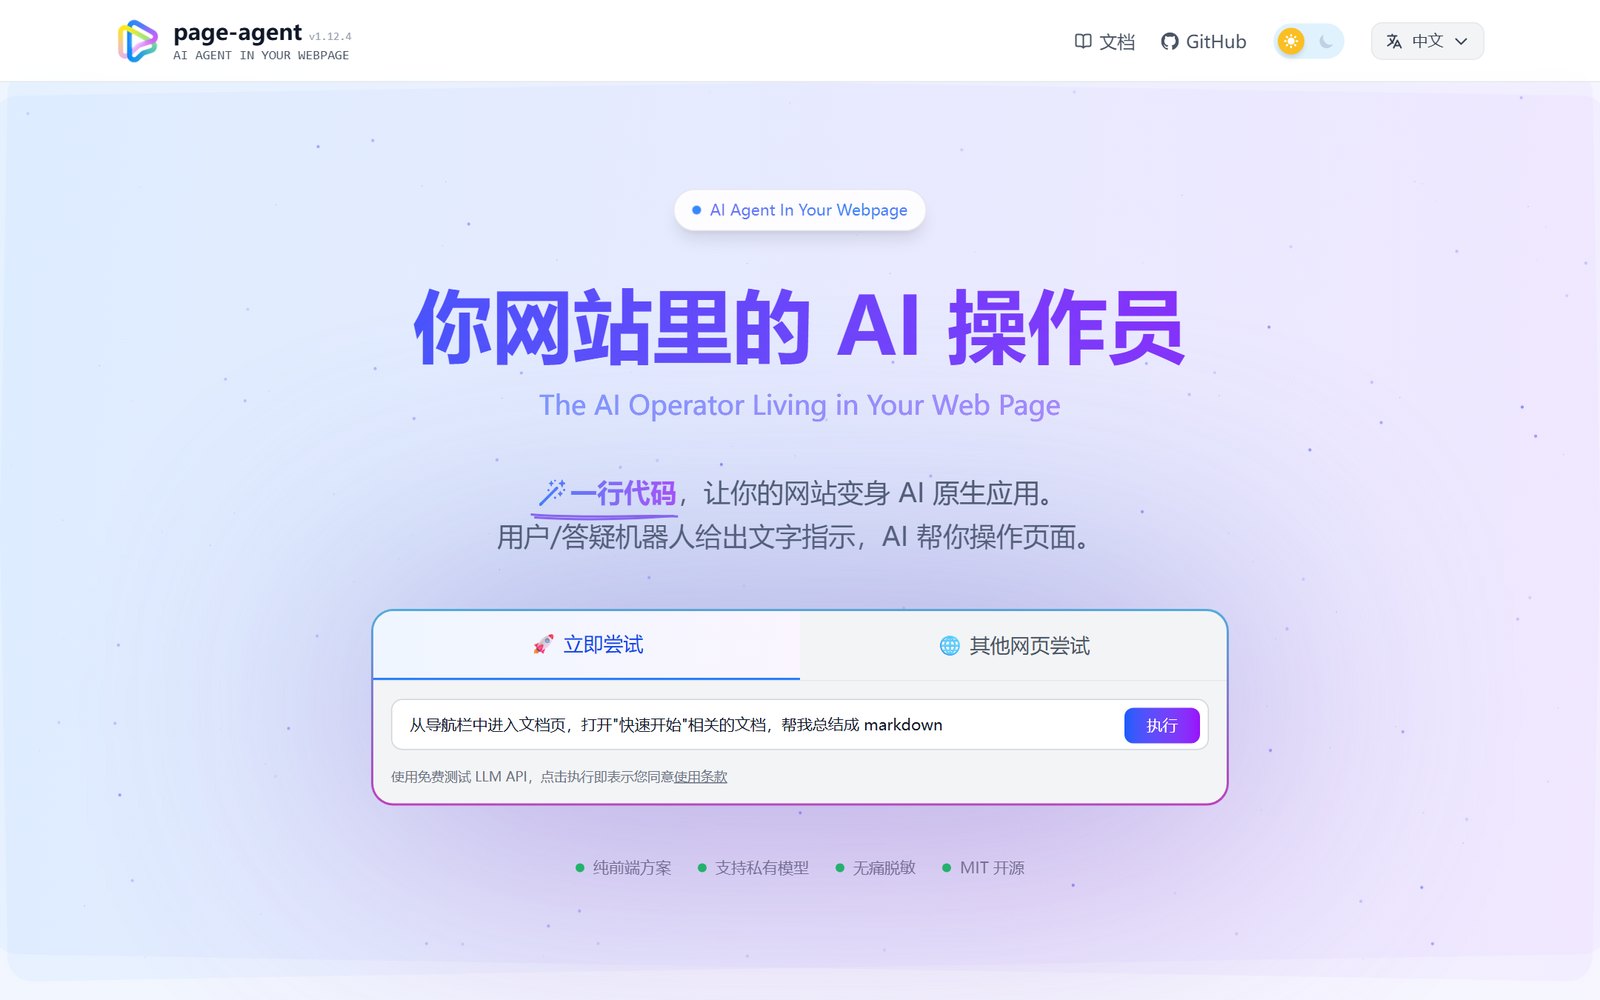
接入成本低到有点不真实。最快的方式是加一行脚本标签,页面右下角就长出一个能对话的操作助手,它自己会去读页面、找按钮、填表单。想做正规接入就 npm install page-agent,实例化之后调 agent.execute('点击登录按钮')。整个过程不需要碰后端,也不需要改构建流程——对已经上线、不敢大动的老系统来说,这一点很关键。
"读文字不读图"这个选择带来连锁好处。截图方案要传图、要让多模态模型看图、要设计坐标映射,成本高、时延高、权限链路还长。文本 DOM 方案把页面结构整理成模型能读的文本,输出的是对某个元素的动作指令。省下的是真金白银的 Token 和响应时间,也省掉了"截图里能不能看到敏感信息"这类隐私顾虑。
模型你自己带。它走 OpenAI 兼容接口,官方示例里用 Qwen 的兼容端点,也能接本地部署的模型。也就是说数据可以不出内网,模型可以自己换,不用被绑在某一家。它还带一个免费的测试模型 API,用来做技术验证很方便。
场景挑得比较准。官方列的几类正好是这架构最合适的:给自家 SaaS 产品加一个能直接操作界面的 Copilot;把二十次点击的填表流程压成一句话,ERP、CRM、后台管理系统都吃这一套;做新手引导,让 AI 带用户走完报销、配置、查询;还有无障碍访问——语音指令加屏幕阅读器配上它,复杂页面的使用门槛会明显降下来。
想扩也有路。单页面不够用,可以加官方那个浏览器扩展,把能力伸到多个标签页;再往上还有一个 Beta 阶段的 MCP 服务端,让外部的 Agent 客户端来驱动这个页面。这两条路子都不是主流程,需要时才装。
项目对来路讲得清楚。README 里明说 DOM 处理组件和提示词设计借鉴自 browser-use,也附了完整的 MIT 授权声明。这种把出处摊开写的做法,比含糊带过靠谱。
怎么用
想立刻看见效果,HTML 里加一段就行:
<script src="https://cdn.jsdelivr.net/npm/page-agent@1.12.4/dist/iife/page-agent.demo.js" crossorigin="anonymous"></script>
国内拉不动那个 CDN 就换镜像源。要注意这段脚本用的是官方免费的测试模型,只适合技术验证,别拿去上生产。
正式接入走 npm:
npm install page-agent,然后 new PageAgent({ model: 'qwen3.5-plus', baseURL: '你的兼容接口地址', apiKey: '你的密钥', language: 'zh-CN' }),再调 agent.execute('帮我把上个月的销售报表导出来')。
不是没有槽点
它只做浏览器里的活儿。README 把边界划得很清楚:这是客户端网页增强组件,服务端自动化、爬虫、绕过平台限制这些都不在它的射程里。如果你要找的是自动登录、批量跑任务的工具,方向就错了——那种需求该去看 Playwright 或者 browser-use。
准确率不是它单方面决定的。它依赖两样东西:页面的 DOM 质量,和你选的模型。页面动态、结构混乱、按钮只有图标没有文字,准确率都会掉。这不是它一个项目的毛病,是整条路线的固有约束。
它是个库,不是产品。没有管理后台、没有权限体系、没有现成的安全边界。要真用起来,团队得有前端能力去集成、配模型、做测试、划权限——尤其是"哪些操作允许 AI 自己点、哪些必须人工确认"这条线,得你自己设计。医疗、金融这类场景,这一层几乎必须做。
页面得先"可被代理"。这点容易被忽略。图标按钮要补可读的文案或者无障碍标签,输入框要有关联的标签或清晰的占位文字,列表和表格的行要有稳定的可读标识。好消息是这些改造本身就该做,做完顺便也提升了无障碍和自动化测试的可维护性。
复杂视觉界面它吃力。大量图标、Canvas 画布、复杂图表这类"视觉信息多、文字信息少"的页面,文本 DOM 路线先天不占优,那种场合截图式的多模态方案反而更强。
版本还在动。从生态里能看到的 v1.6 到现在的 v1.12.4 之间,API 和文档都在变,半年多前写的示例未必还能直接跑。依赖它之前先看一眼当前文档。
跟同类怎么比
对 browser-use。最容易被拿来比的一个。差别在落点:browser-use 是从外部驱动一个浏览器去完成自动化任务,Page Agent 是让你自己的产品长出会说人话的操作层,跑在用户自己的页面里。一个对外,一个对内。README 里那句"为客户端网页增强而设计,不是服务端自动化"就是这个意思。两者可以同时存在。
对截图式的多模态 GUI Agent。多模态方案在视觉丰富、语义缺失的页面上更强,代价是更贵、更慢、权限链路更长,还有"截图里带着用户数据"这件事要处理。选哪条路取决于你的页面长什么样:管理后台、表单、列表、工作台这类,文本 DOM 更划算;游戏、设计工具、重可视化应用,多模态更合适。
对 Playwright、Selenium 这类自动化框架。确定性任务上它们又快又稳,问题是脚本写死了——页面一改版就失效,而且要有人专门维护那些选择器。Page Agent 换来的是容错和自然语言输入,代价是每一步都要调一次模型,慢。批量冒烟测试这类场景,还是老老实实用 Playwright。
对自己写规则脚本。最省依赖,但用不了多久就会变成一坨谁也看不懂的 if-else,而且用户换一句说法就失灵。自然语言这条路解决的就是"输入不可穷举"的问题。
一句话:你在做面向用户的产品,想让界面能被一句话操作,Page Agent 是目前接入成本最低的选择;你要做的是从外部批量自动化,那它不合适。
项目地址:https://github.com/alibaba/page-agent
演示与文档:https://alibaba.github.io/page-agent/
标签:#PageAgent #AIAgent #前端开发 #自然语言交互 #JavaScript #开源工具
如果你负责的系统能加一个"说话就能操作"的入口,你最想先解决哪个流程?