同一块 GA102 核心,消费卡和专业卡的差距不在硬件,在英伟达写死的一行限速。10月18日,一个 Linux 内核模块把这个限速拧开了:RTX 3090 Ti 的 BF16 算力实测从 87.5 TFLOPS 冲到 157.4,涨幅八成。截至10月28日,这个叫 gpu-unlock 的仓库拿到 10891 颗星、1074 次派生,版本号刚发到 v1.1.0。
原理一句话能说清:它赶在英伟达官方驱动绑定显卡之前动手。这个 C 语言写的内核模块把 cmpunlocker 的 V67/PLM 技术和 UEFI 方案的驱动前时序拼在一起,写入两个速度选择器——SS0 写 0x88888888,选中满速 BF16 档;SS1 写 0x8——然后执行 FLR 重置,再让干干净净的原版驱动接管。
它不是 UEFI 程序,也不是魔改驱动。好处在升级:英伟达每次发新驱动,不用重新折腾一遍解锁。
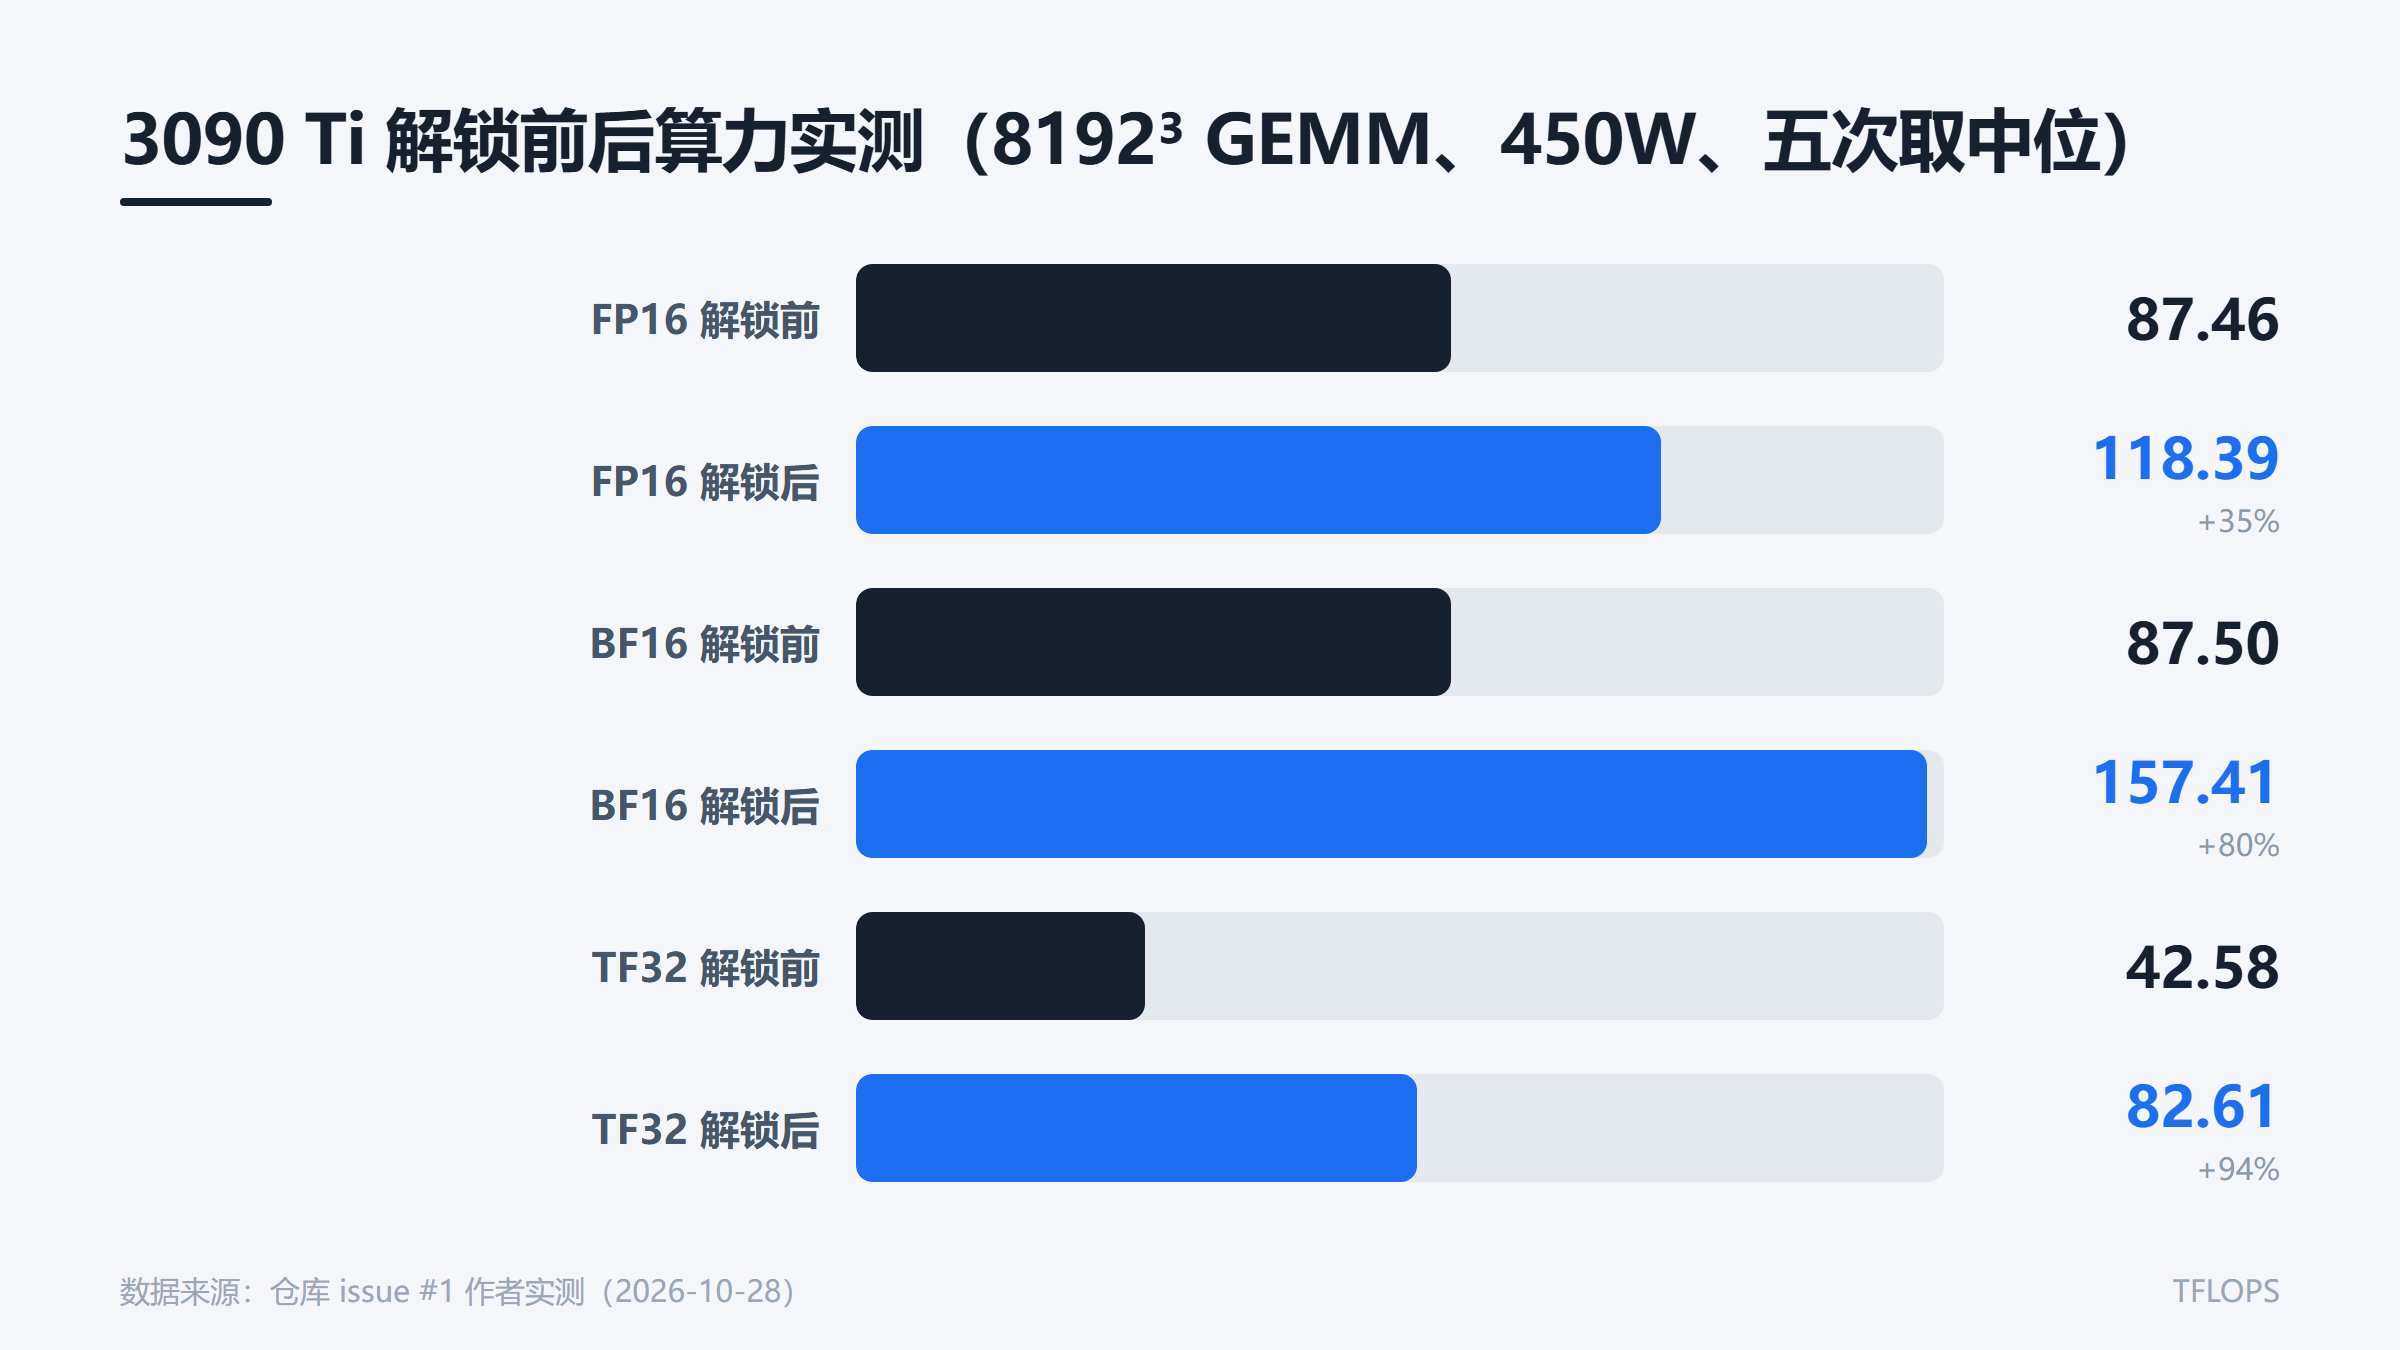
3090 Ti 解锁前后算力实测对比(450W、8192³ GEMM、五次取中位)(数据来源:公开数据整理)
受益的是 GA102、GA103、GA104、GA106 四款核心,对应 3080、3090 到 3060 这一整代 30 系卡。FP 和 BF16 的 FMA 到 FP32 运算,指令发射速度直接翻倍。作者的实测放在仓库 issue 里:450W 功耗下跑 8192 立方稠密矩阵乘,五次取中位——FP16 从 87.46 到 118.39 TFLOPS,BF16 从 87.50 到 157.41,TF32 从 42.58 到 82.61。
有三件事要看清。
第一件,锁的是指令发射率,不是流处理器数量。3060 和专业卡的核心硬件同源,差距是人为的定价分层。这行限速代码一解锁,几千块的消费卡摸到了专业卡的算力门槛,英伟达的产品线逻辑被绕过了。
第二件,这是 Linux 玩家的免费午餐。主线方案走内核模块,make install 一条命令装好,再往内核启动参数里加一行 gpu_unlock.targets=all。Windows 主线不维护,第三方移植版有,作者明说效果自负。
第三件,收益最大的是本地跑 AI 的人。BF16 是大模型训练和推理的主力精度,二手 3090 价格三千上下,解锁后 BF16 算力翻倍还多。风险也摆在这:这是对硬件行为的改动,作者口径称不伤卡、标准降频和功耗管理原封不动,但保修和稳定性风险自己掂量。20 系和 40 系主线还没支持,fork 里已有实现,作者说近期会合并。
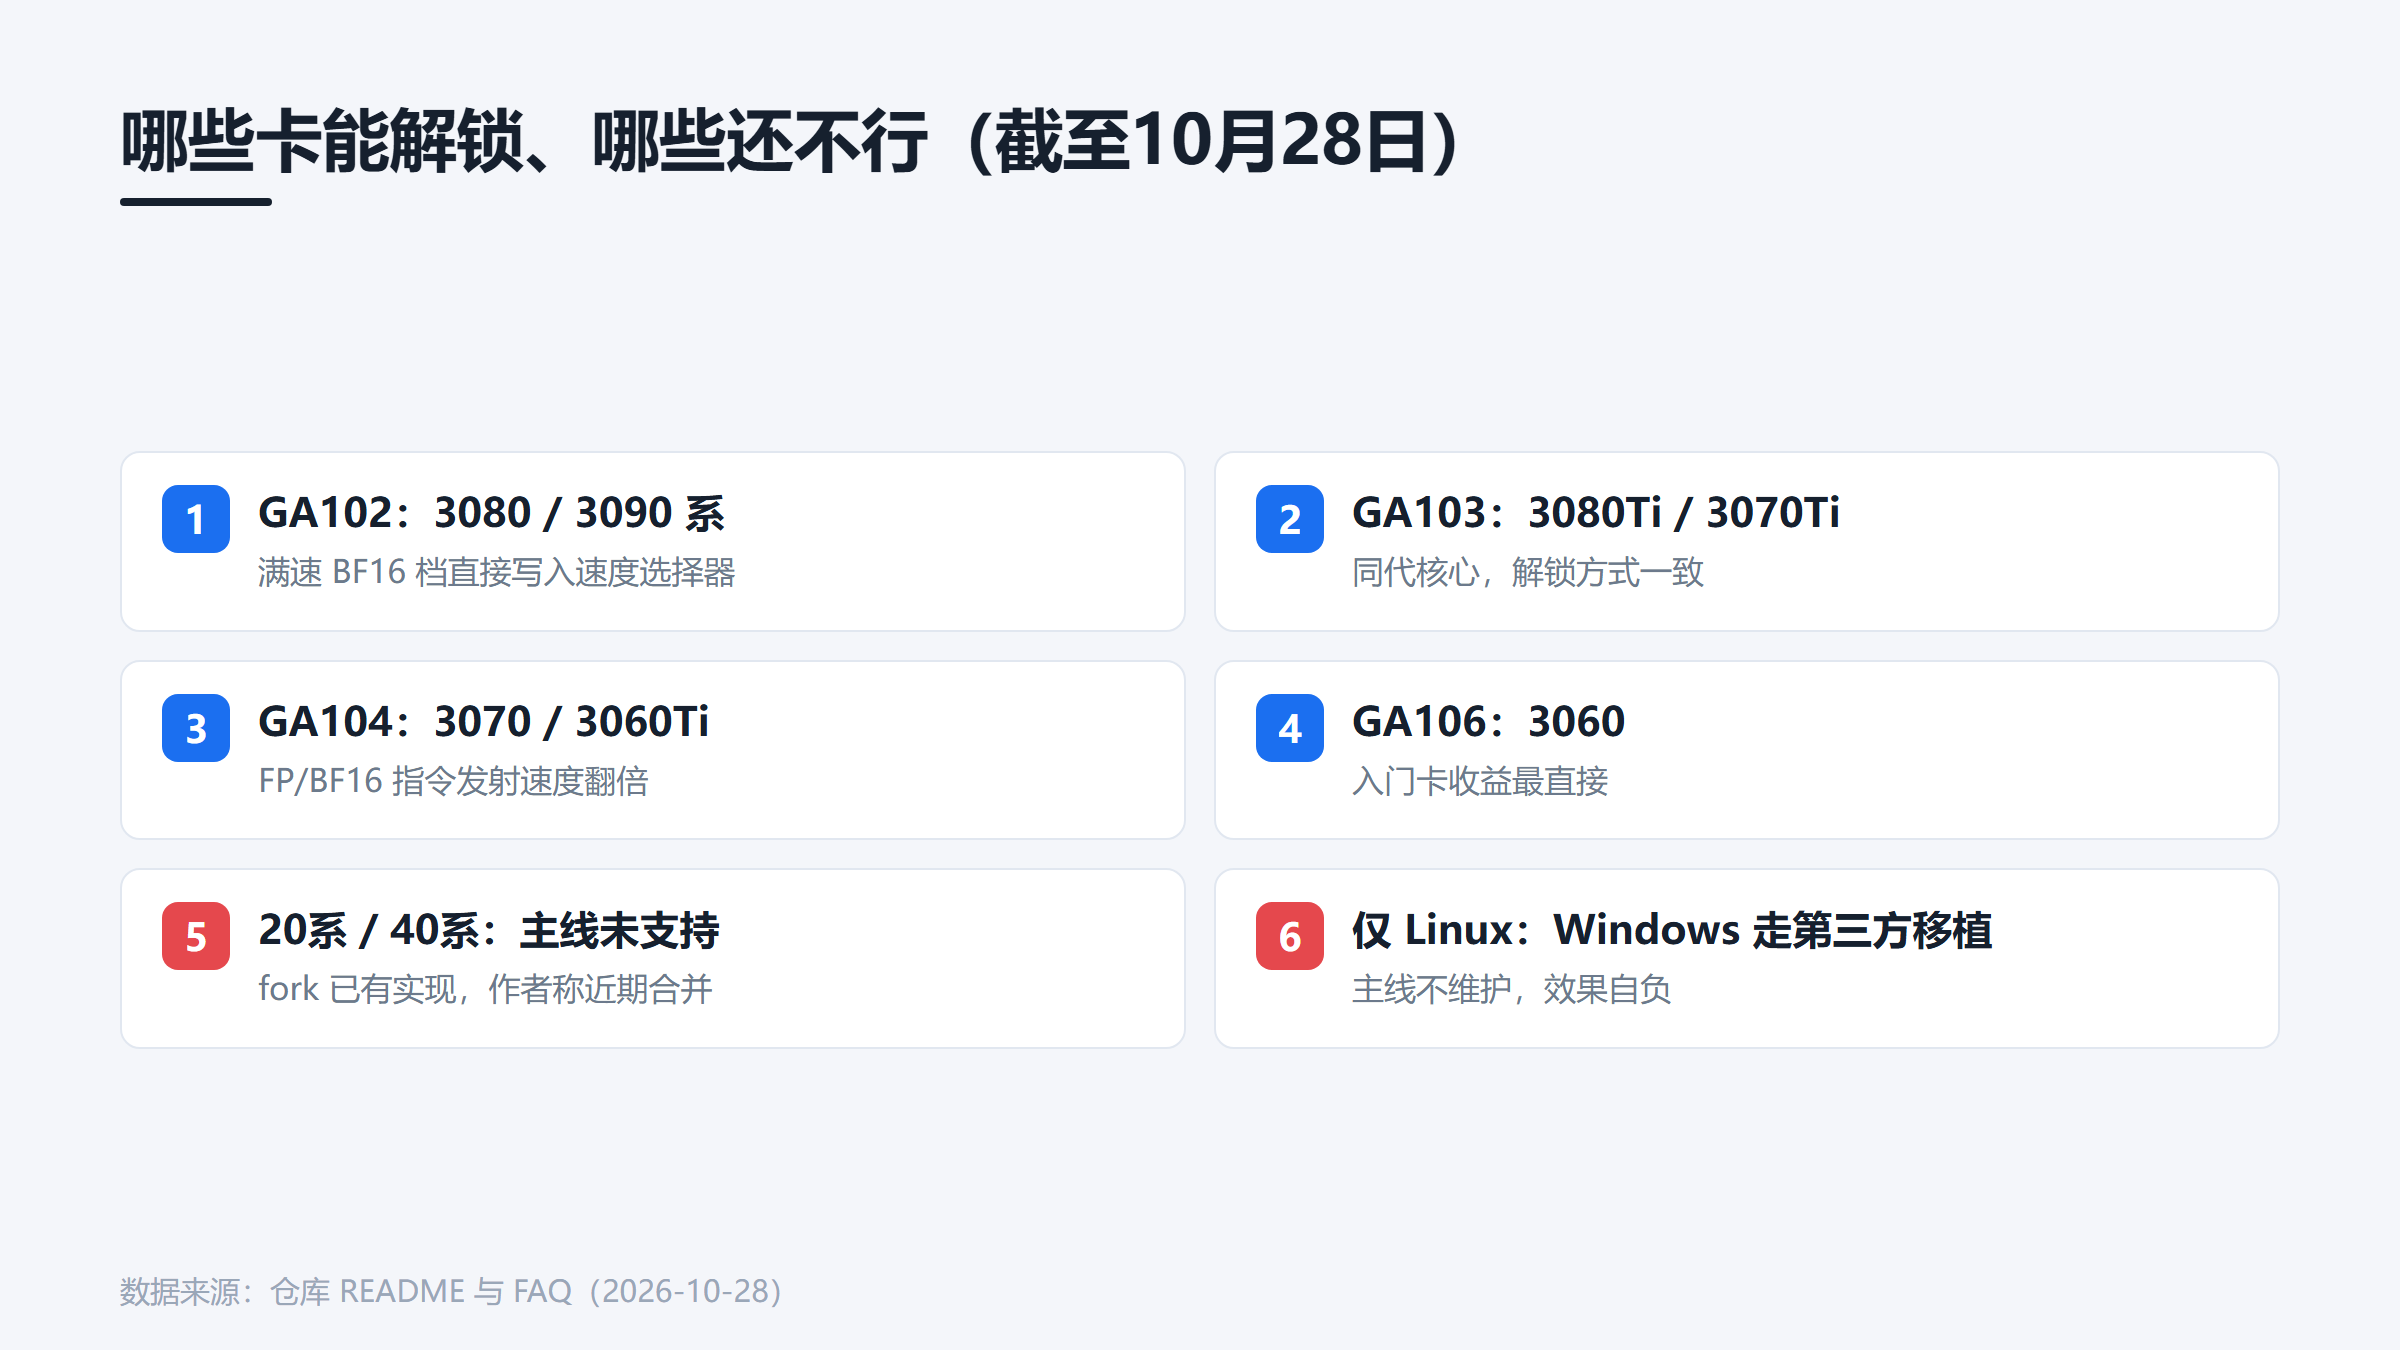
哪些卡能解锁、哪些还不行(截至10月28日)(数据来源:公开数据整理)
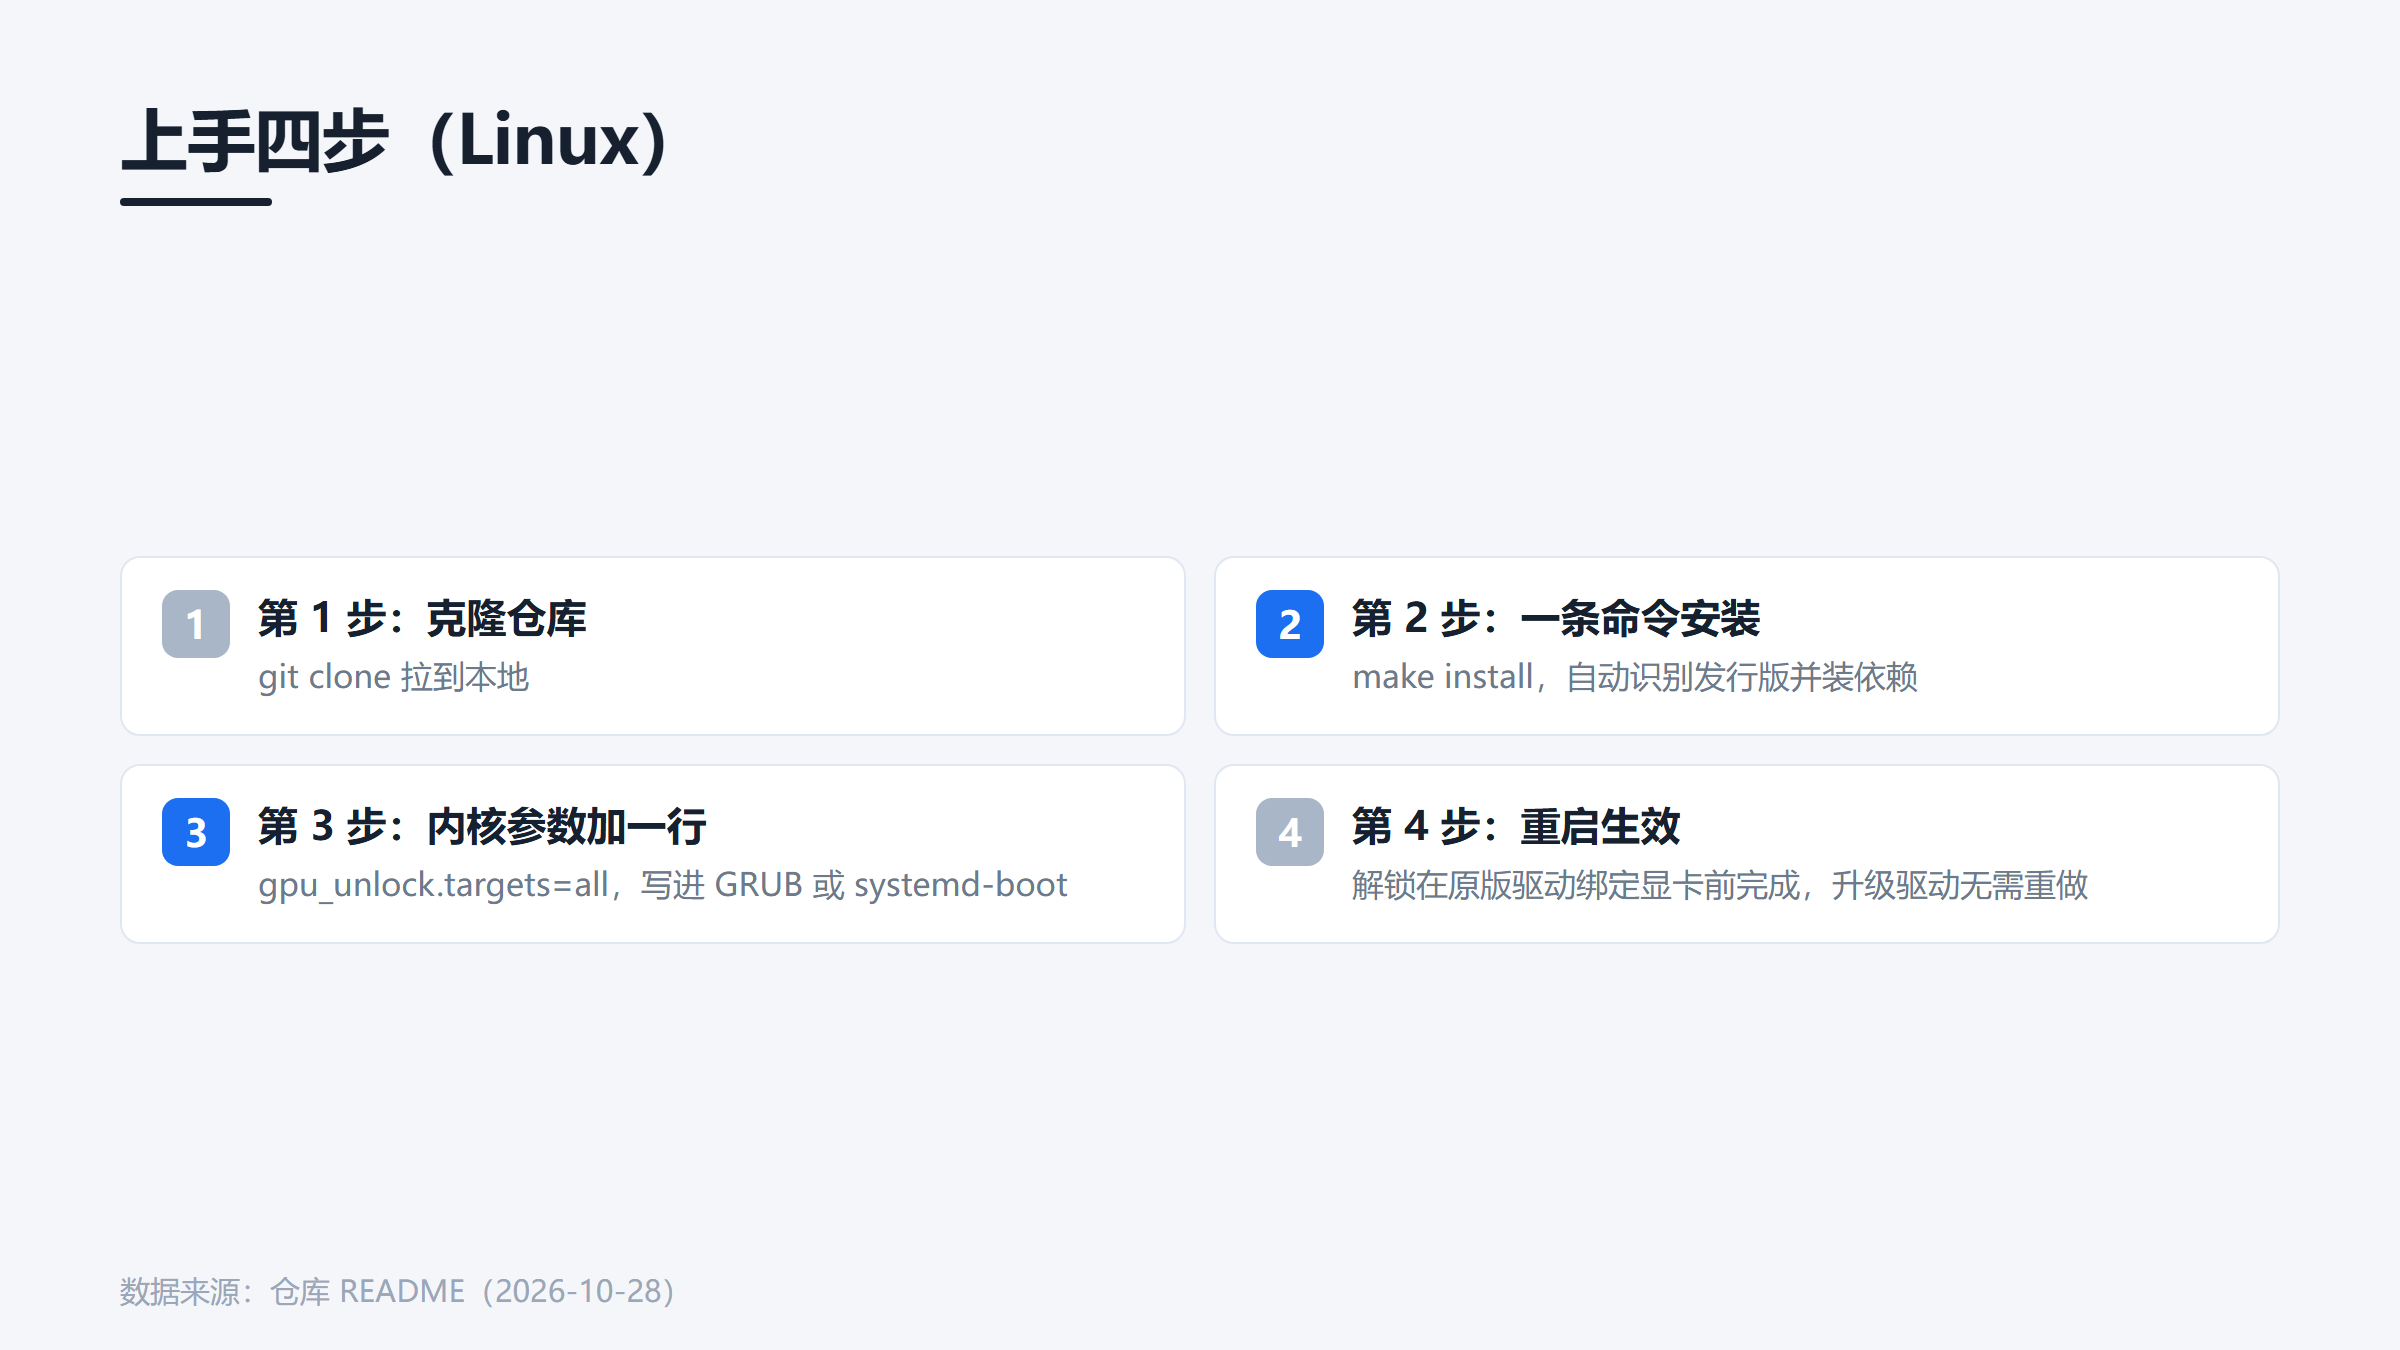
上手四步(Linux)(数据来源:公开数据整理)
参照系是专业卡的价格:一块 A6000 卖三万多,算力差距靠一行启动参数抹掉大半,这笔账怎么算都刺眼。
英伟达会不会在下个驱动里把这条路堵上?你会为多出来的算力冒这个险吗?评论区聊聊你的卡。