智能体跑长任务时,最烧钱的不是模型本身,而是上下文里越堆越多的历史。你每轮都得把前面几万字的日志、代码、报错再喂一遍。TencentDB Agent Memory 想的是另一套思路:别让 AI 啥都往脑子里塞,该记的记成结构,该甩的甩到外部。
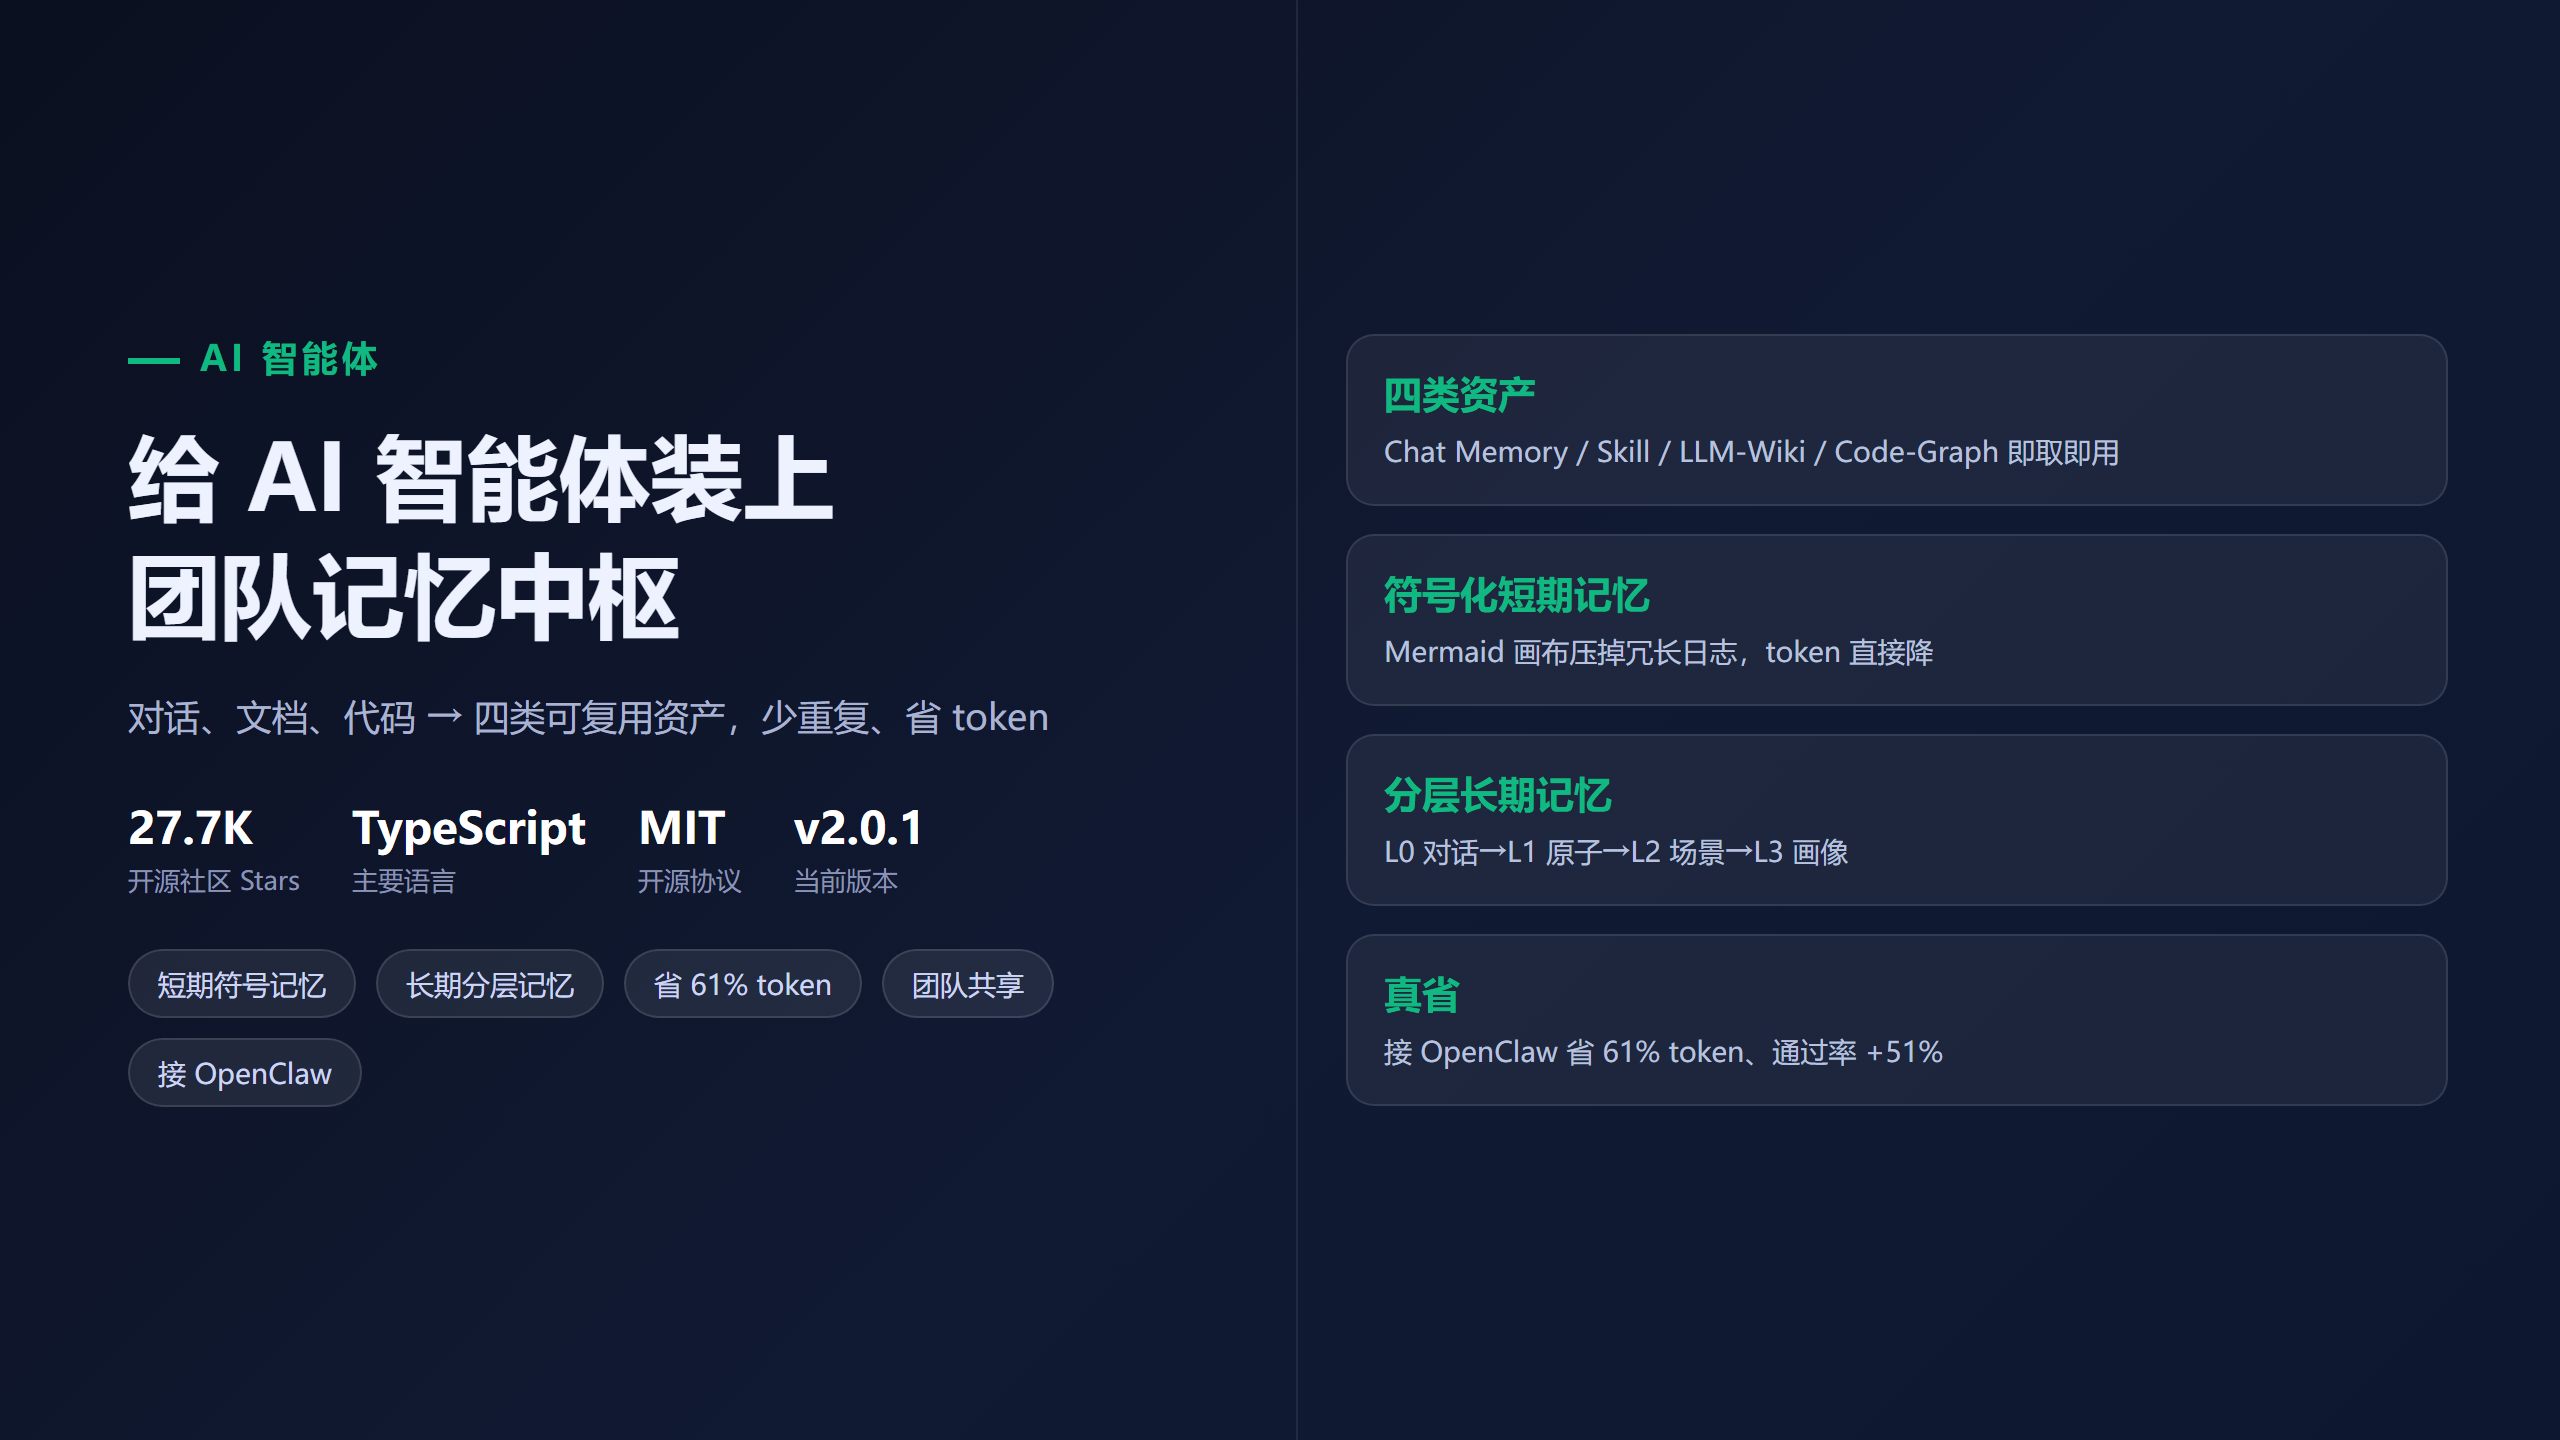
这是腾讯云出的一个面向 AI 智能体的团队级记忆中枢,GitHub 2.7 万 Star,TypeScript 写,MIT 协议,最新 v2.0.1。它把对话、文档、代码沉淀成四类可复用资产,主打一个「符号化短期记忆 + 分层长期记忆」。
是什么
它本质上是个记忆层,插在智能体和底层模型之间。你不用再每轮把完整历史灌进上下文,而是让 Agent 去记「该记的」:哪条是用户偏好、哪段是项目背景、哪个工具的输出该归档。记忆不再是平铺的向量堆,而是分层、可追溯的结构。
它沉淀四类资产:Chat Memory(对话记忆)、Skill(可复用技能)、LLM-Wiki(知识库)、Code-Graph(代码图谱)。对团队协作尤其有用——一个人踩过的坑、总结的 SOP,能直接变成别人能调用的记忆。
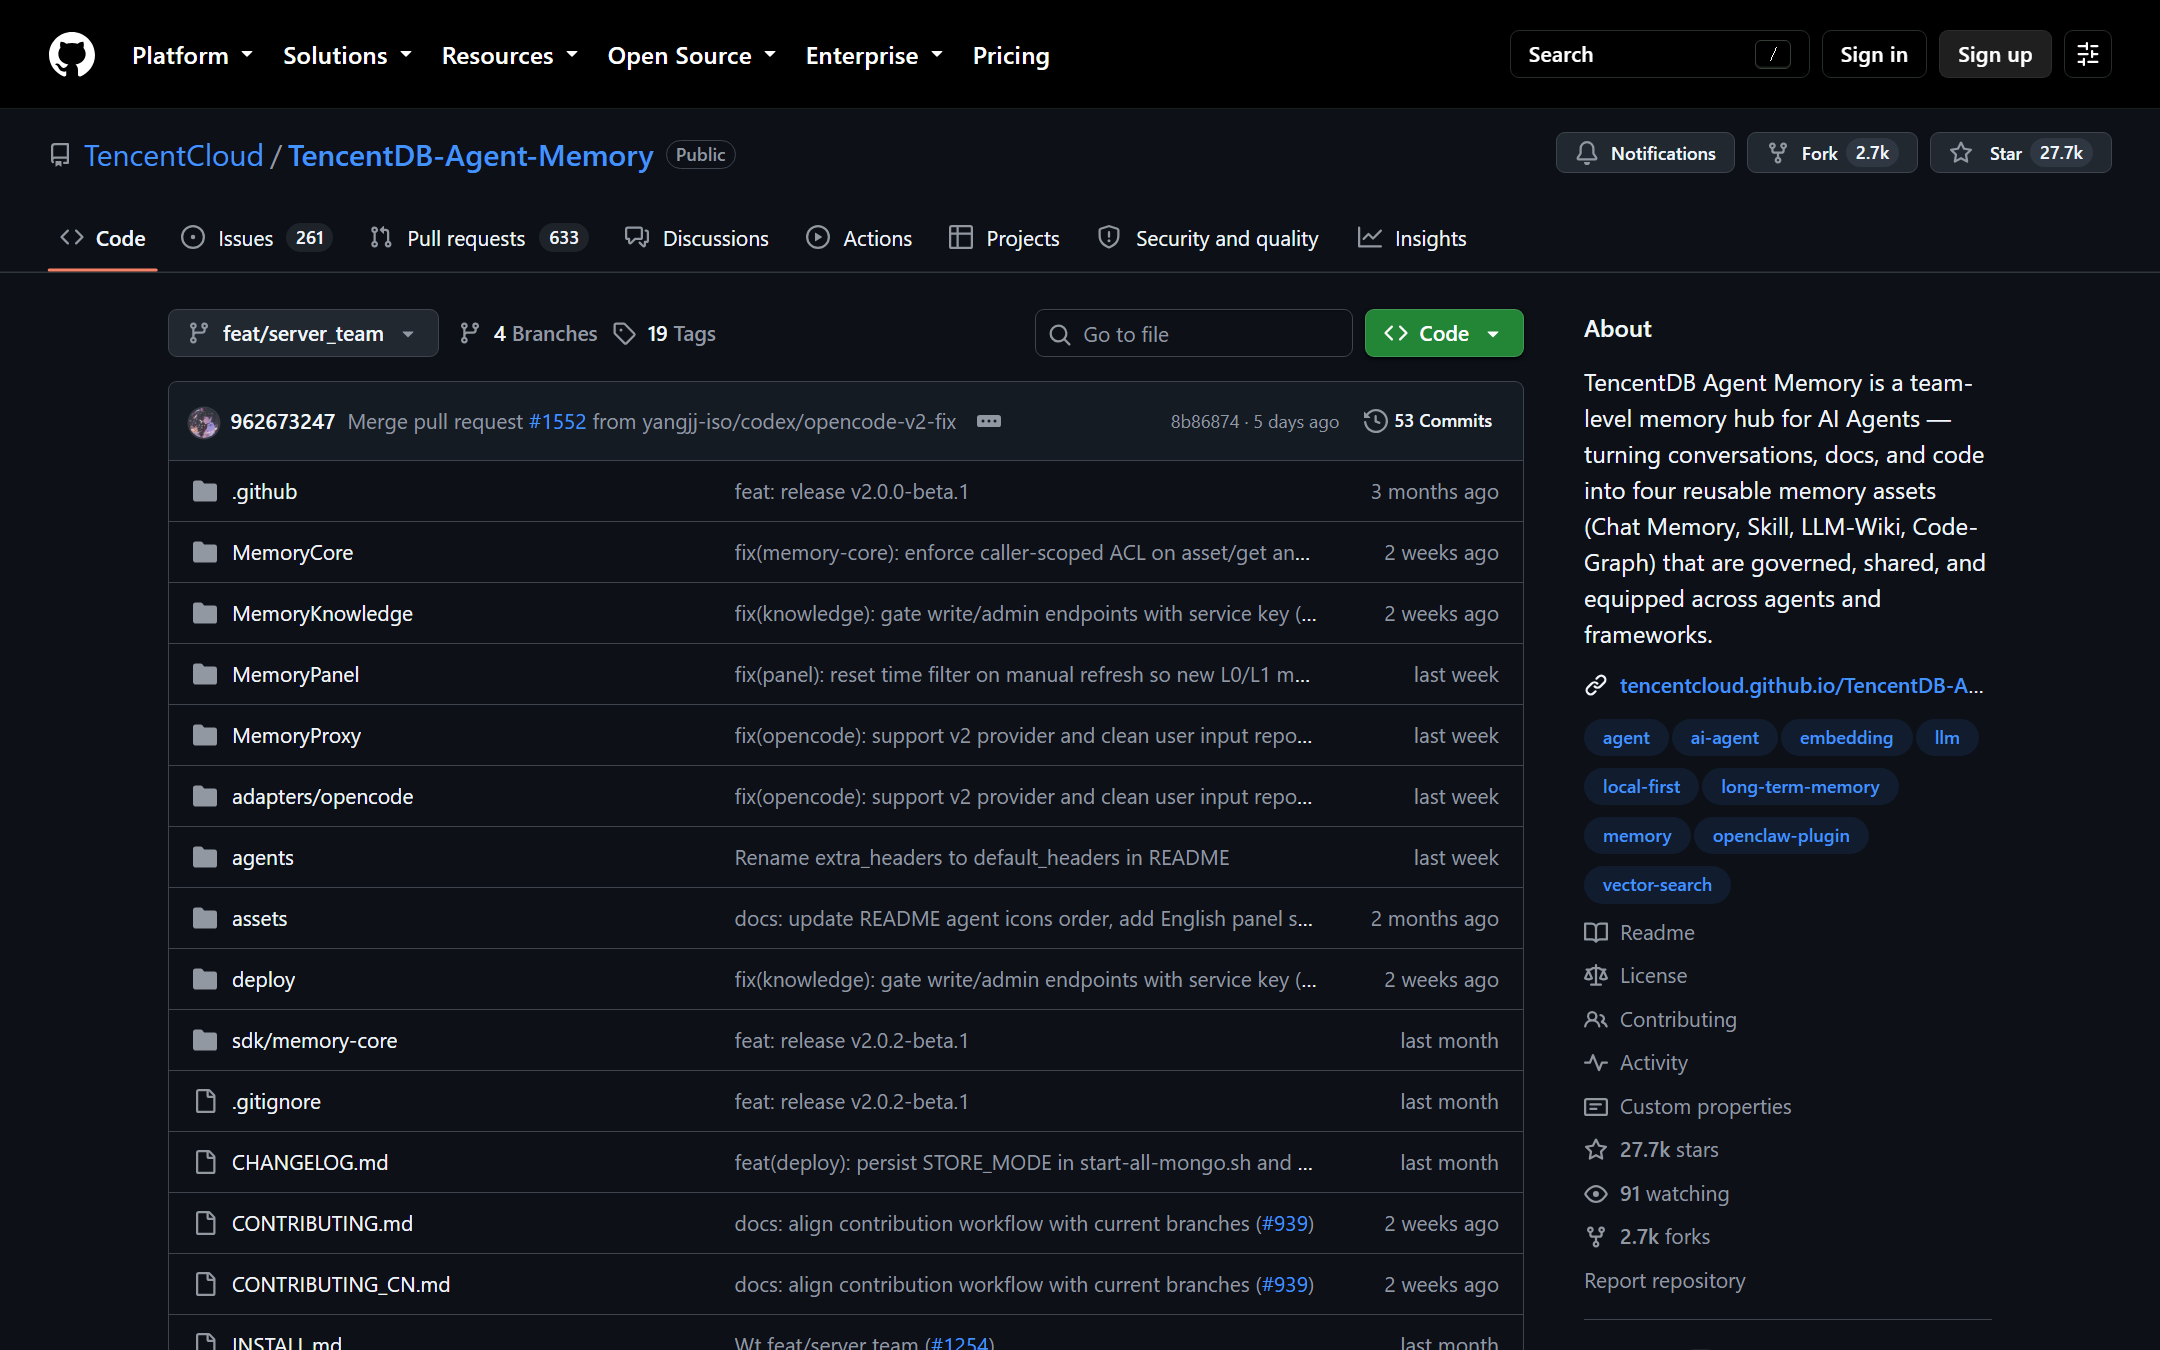
TencentDB Agent Memory 仓库主页:27.7K Star,最新 v2.0.1
核心优势
第一,符号化短期记忆。长任务里最费 token 的是那些冗长的中间日志。它把任务状态转成高密度的 Mermaid 图(带 node_id),只把这张轻量画布留在上下文里,原始日志甩到外部文件。要核对细节时,按 node_id 一查就回到底层原文。实测接 OpenClaw 能把 token 用量砍掉 61%。
第二,分层长期记忆。它拒绝「把所有对话拍平丢进向量库」那种做法,而是建一个语义金字塔:L0 原始对话 → L1 原子事实 → L2 场景块 → L3 用户画像。Agent 平时只看顶层画像,细节才往下钻。PersonaMem 准确率从 48% 拉到了 76%。
第三,全程可追溯、不丢证据。压缩最怕不可逆,它从顶层符号到原始文本有一条确定性的下钻路径。上层留结构、下层留证据,不会因为压缩把关键信息抹掉。
官方文档站:符号化短期记忆 + 分层长期记忆
怎么用
它目前主要作为插件形态存在,最顺的接入方式是 OpenClaw:
openclaw plugins install @tencentdb-agent-memory/memory-tencentdb
装完之后,Agent 在长任务里的上下文管理就交给它了。文档站里也给了 Hermes 等其它智能体的接入示例。底层数据分两层存:事实、日志、轨迹落数据库做全文检索;画像、场景、画布这些上层结构存成可读的 Markdown,方便白盒检查。Node 22.16 以上就能跑。
不是没有槽点
它对「接入方」有要求。价值在长任务、长周期会话里才明显,你如果只是偶尔问一句「帮我写个正则」,上这个记忆层纯属增加复杂度。它和 OpenClaw、Hermes 的整合最成熟,别的智能体要接,得自己看文档搭。
另外记忆本身需要治理。分层和符号化是它强,但也意味着你要相信它的蒸馏质量——万一某次摘要把关键前提丢了,下钻回去还能找,但 Agent 当场的判断可能已经偏了。团队共享记忆还有权限和一致性的问题,不是装上就万事大吉。
跟同类比,怎么选
和 Mem0、Zep 这类记忆框架比,TencentDB Agent Memory 的差异化在于「分层 + 符号化」而不是「扁平向量检索」。它更强调 token 压降和可追溯,给出的 benchmark 数字也挺实——不是孤立轮次,而是连续长周期会话下的累计效果。
一句话:如果你在跑长周期、多轮的智能体,且被上下文成本和「AI 老忘事」折磨,这个记忆中枢值得一试;短平快的小任务,先别急着上。
GitHub:TencentCloud/TencentDB-Agent-Memory
官方文档:tencentcloud.github.io/TencentDB-Agent-Memory
标签:#TencentDB #AgentMemory #AI智能体 #记忆中枢 #省token
你现在的智能体,是每次都把完整历史重新喂一遍,还是已经有一套自己的记忆机制了?