深度研究、写代码、出报告这种动辄几十分钟甚至几小时的长链路任务,普通 AI 助手干不了——它记不住前面聊过什么,也不会自己把活拆开并行干。字节开源的 DeerFlow 就是专门干这个的"超级智能体框架",2.0 彻底重写之后,用子智能体、记忆、沙箱和可扩展技能把长任务一层层编排起来。
是什么
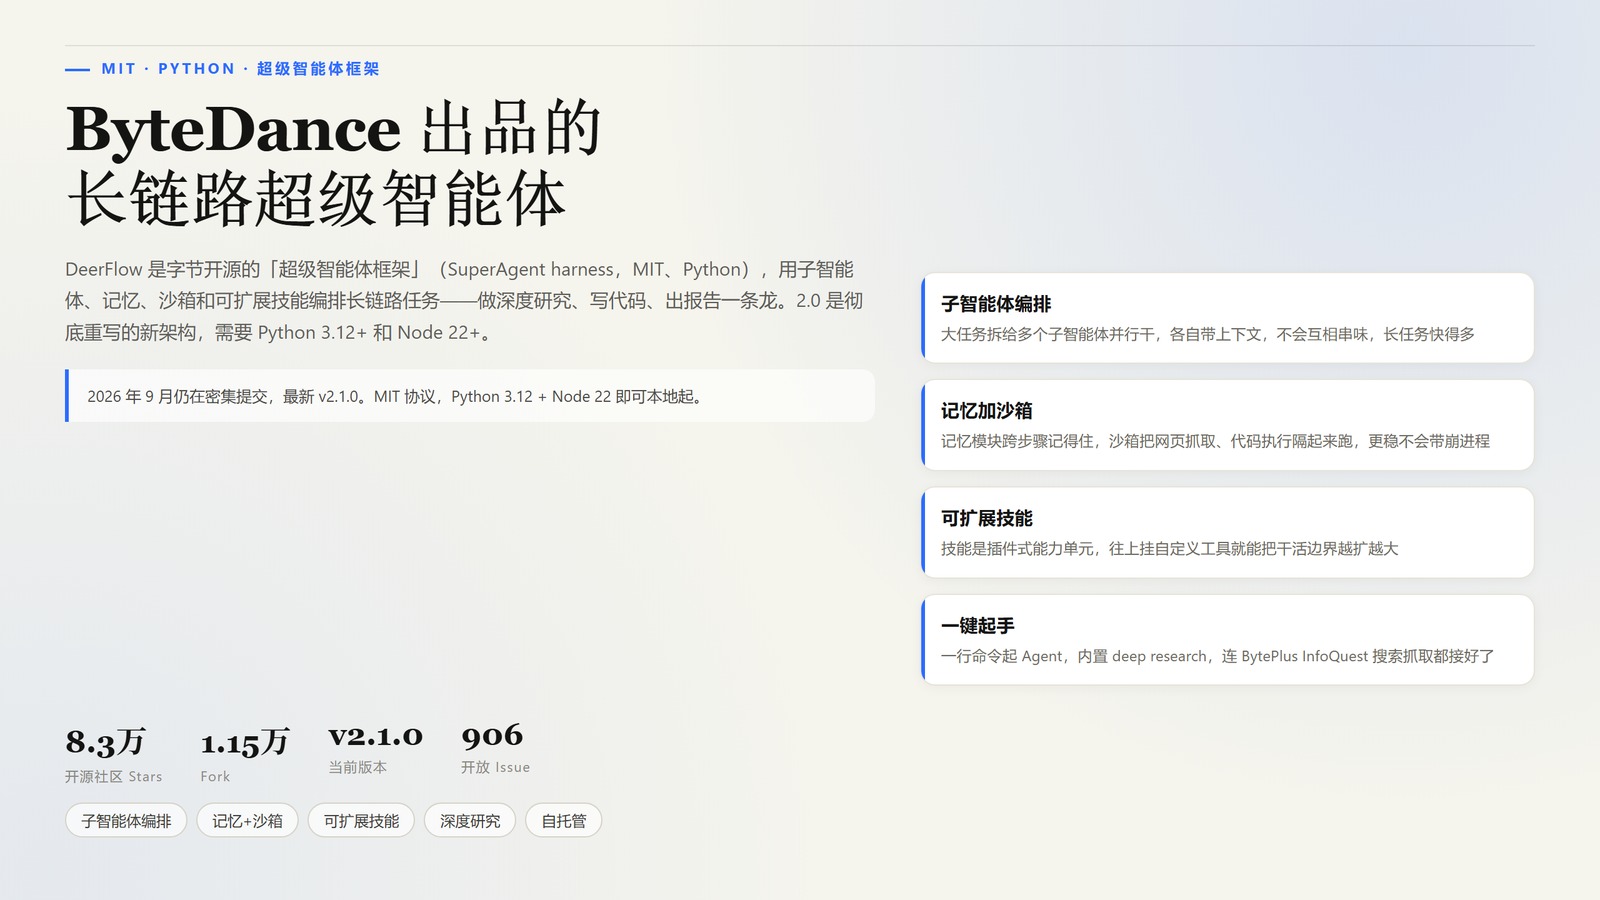
DeerFlow(Deep Exploration and Efficient Research Flow)是字节开源的 SuperAgent harness,MIT 协议、Python 写的。仓库当前 8.3 万个 Star、1.15 万个 Fork,最新版本 v2.1.0 发布于 2026 年 9 月,几乎每天都有提交。它把子智能体、记忆、沙箱和可扩展技能编排到一起,做研究、写代码、出东西一条龙。值得一提的是 2.0 是一次 ground-up 重写,和 1.x 完全不共享代码,官方把老框架留在 1.x 分支继续维护。本地起它需要 Python 3.12+ 和 Node 22+。
它能干的事很"长":给一个大目标,它自己拆解成子任务,派给多个子智能体并行做,过程中用记忆模块跨步骤记住上下文,用沙箱把网页抓取、代码执行这类危险操作隔起来跑,最后把结果拼成报告。2026 年 2 月底 2.0 发布后,它一度冲到 GitHub Trending 第一。
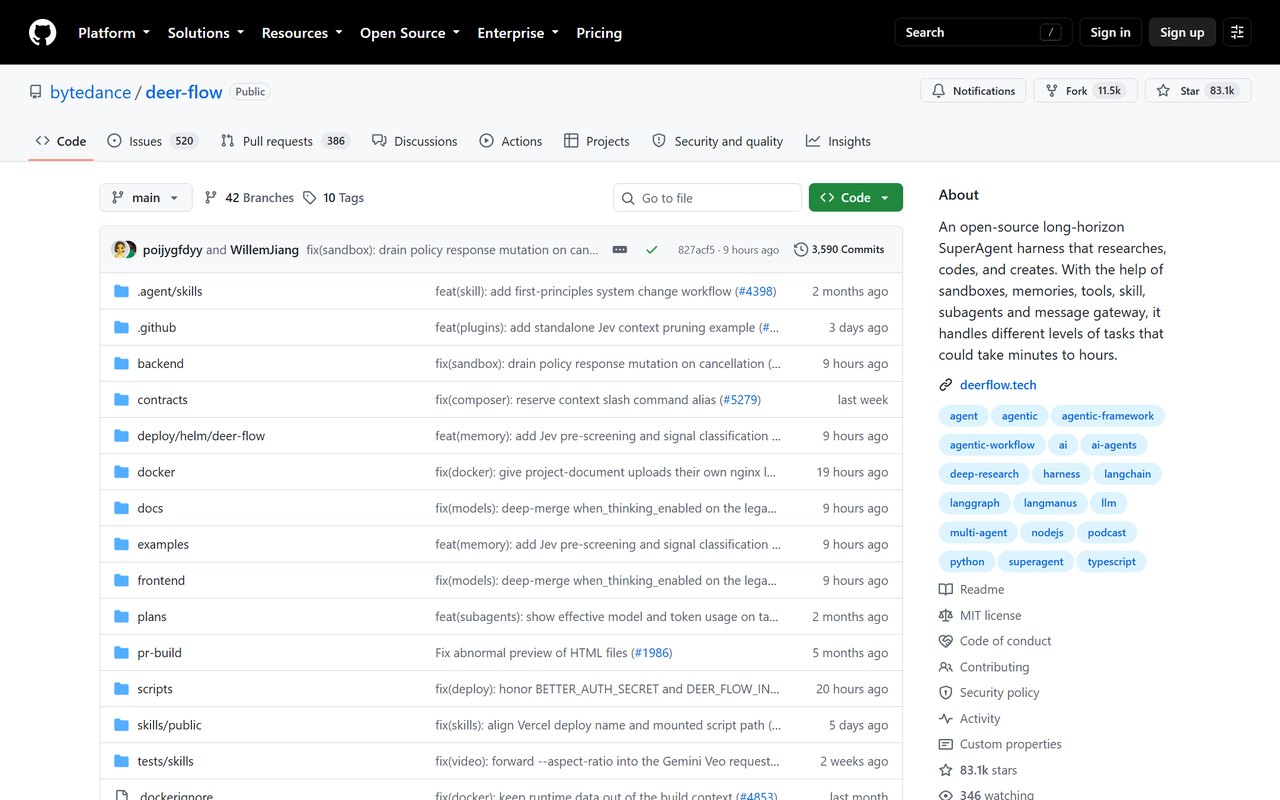
DeerFlow 的仓库首页。Python 主仓、MIT 协议,最近一次提交就在今天
它到底好用在哪儿
第一是子智能体编排。大任务能拆给多个子智能体并行干,各自带自己的上下文,不会互相串味。对一个要研究半天的任务来说,这种分头推进比单 Agent 一条线硬撑快得多。
第二是记忆加沙箱。记忆模块让它跨步骤记得住前面查到的东西;沙箱把危险操作隔离在受控环境里跑,做网页抓取、跑代码片段时更稳,不会因为一个坏链接把整个进程带崩。
第三是可扩展技能。技能(skill)是插件式的能力单元,你可以往上挂自定义工具,把它的干活边界越扩越大。需要什么能力就接什么,不用改核心。
第四是一键起手加深度研究。官方给了"一行命令起 Agent"和 Quick Start,内置 deep research 能力,连 BytePlus 的 InfoQuest 搜索/抓取工具都接了进来,联网查证这一环开箱就有。
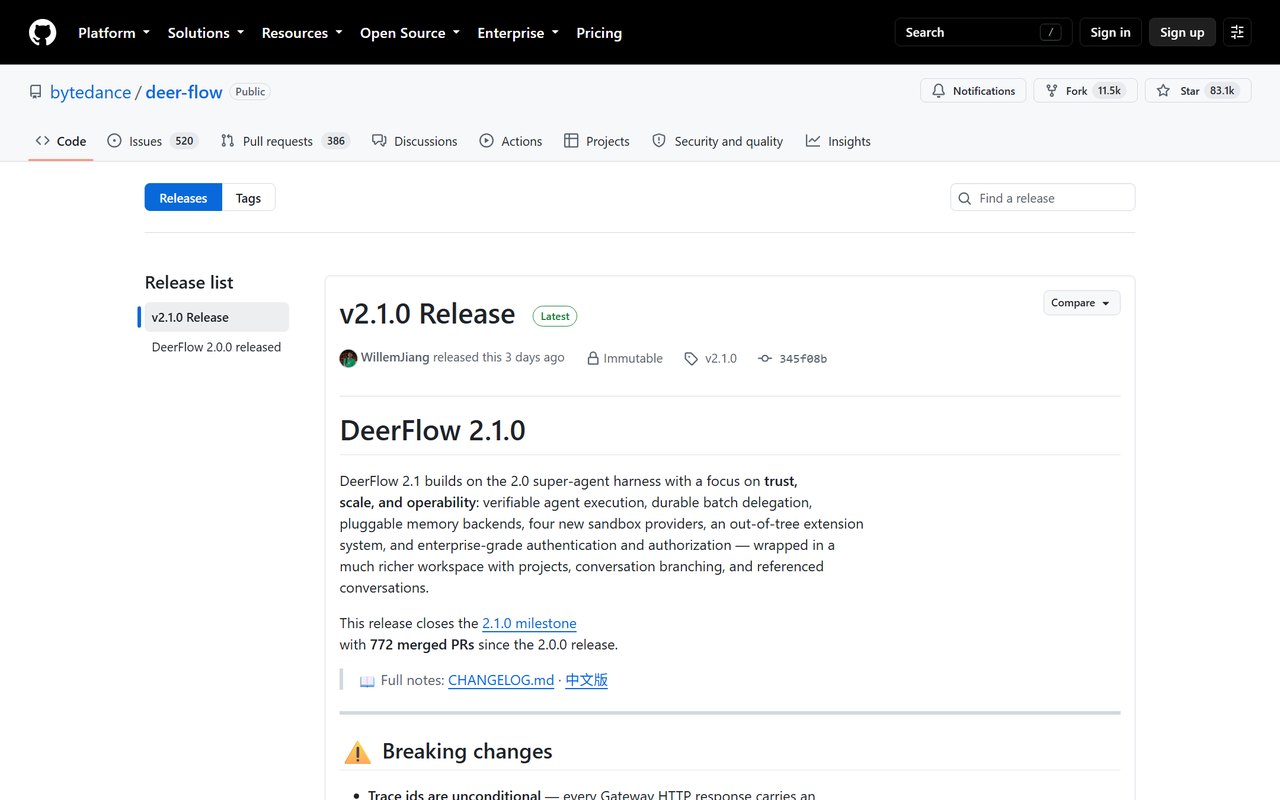
v2.1.0 的发布记录。2.0 重写后迭代很密
怎么用
官方有一键 Agent setup 和 Quick Start,最简路径是 clone 仓库后按 README 起 backend + frontend 两套服务,Python 3.12+ / Node 22+ 是硬要求。不想搭环境的,也可以去 deerflow.tech 看只读的 demo 案例,不用登录就能看到真实跑出来的效果。
它面向的是"甩一个目标,让它自己研究半天再交活"的场景,所以第一次跑建议先给它一个明确的、可验证的小目标,看它拆任务和出报告的方式是否符合预期,再往上加复杂度。
不足也得说清楚
906 个开放 Issue,加上 2.0 刚重写完,生态还在剧烈变动,踩坑概率不低。很多文档和示例仍在追着新架构跑,遇到老教程对不上是常态。
依赖偏重:Python + Node 双栈一起上,本地起一套对新手不太友好;记忆、沙箱、技能三个概念同时砸过来,理解成本不低。深度研究类任务很吃模型和时间,跑一次几十分钟很正常,成本和耐心都得提前备好。
跟同类怎么比
对照 AutoGen、LangGraph、CrewAI。DeerFlow 的卖点是"字节出品 + 开箱式深度研究 + 技能可扩展",最偏"研究→代码→产出"这条长链路;AutoGen 偏多 Agent 对话,LangGraph 偏状态图控制流,CrewAI 偏角色分工。要把一个模糊目标一路推到可交付成果,DeerFlow 目前是开源里打通得最顺的几个之一。
我的判断:如果你要做的是那种"给个方向,让它自己研究几小时再交活"的长链路任务,DeerFlow 值得认真关注。8.3 万 Star、v2.1.0、刚重写完,势头是有的。但先想清楚你愿不愿意为这套双栈环境和一个仍在变动的 2.0 付学习成本。
GitHub:https://github.com/bytedance/deer-flow
官方网站:https://deerflow.tech
标签:#DeerFlow #AI智能体 #超级智能体 #深度研究 #字节 #开源 #多智能体
你手头有没有那种"要研究几小时才能出结果"的活,特别想交给智能体自己跑的?