让一个大模型直接看 K 线图给你结论,多半不靠谱——它会把「长期看好」和「短期有压力」混在一段话里,说完你还是不知道该怎么办。真在投研机构里,这个活儿不是一个人干的:基本面分析师看财报,情绪分析师看社媒和新闻,技术分析师看指标,然后多空两方研究员吵一架,交易员拟方案,风控团队审风险,最后组合经理拍板。分工的意义就在于让不同立场互相牵制。
TradingAgents 干的事,是把这套分工用大模型智能体复刻一遍,跑在你的本机上。
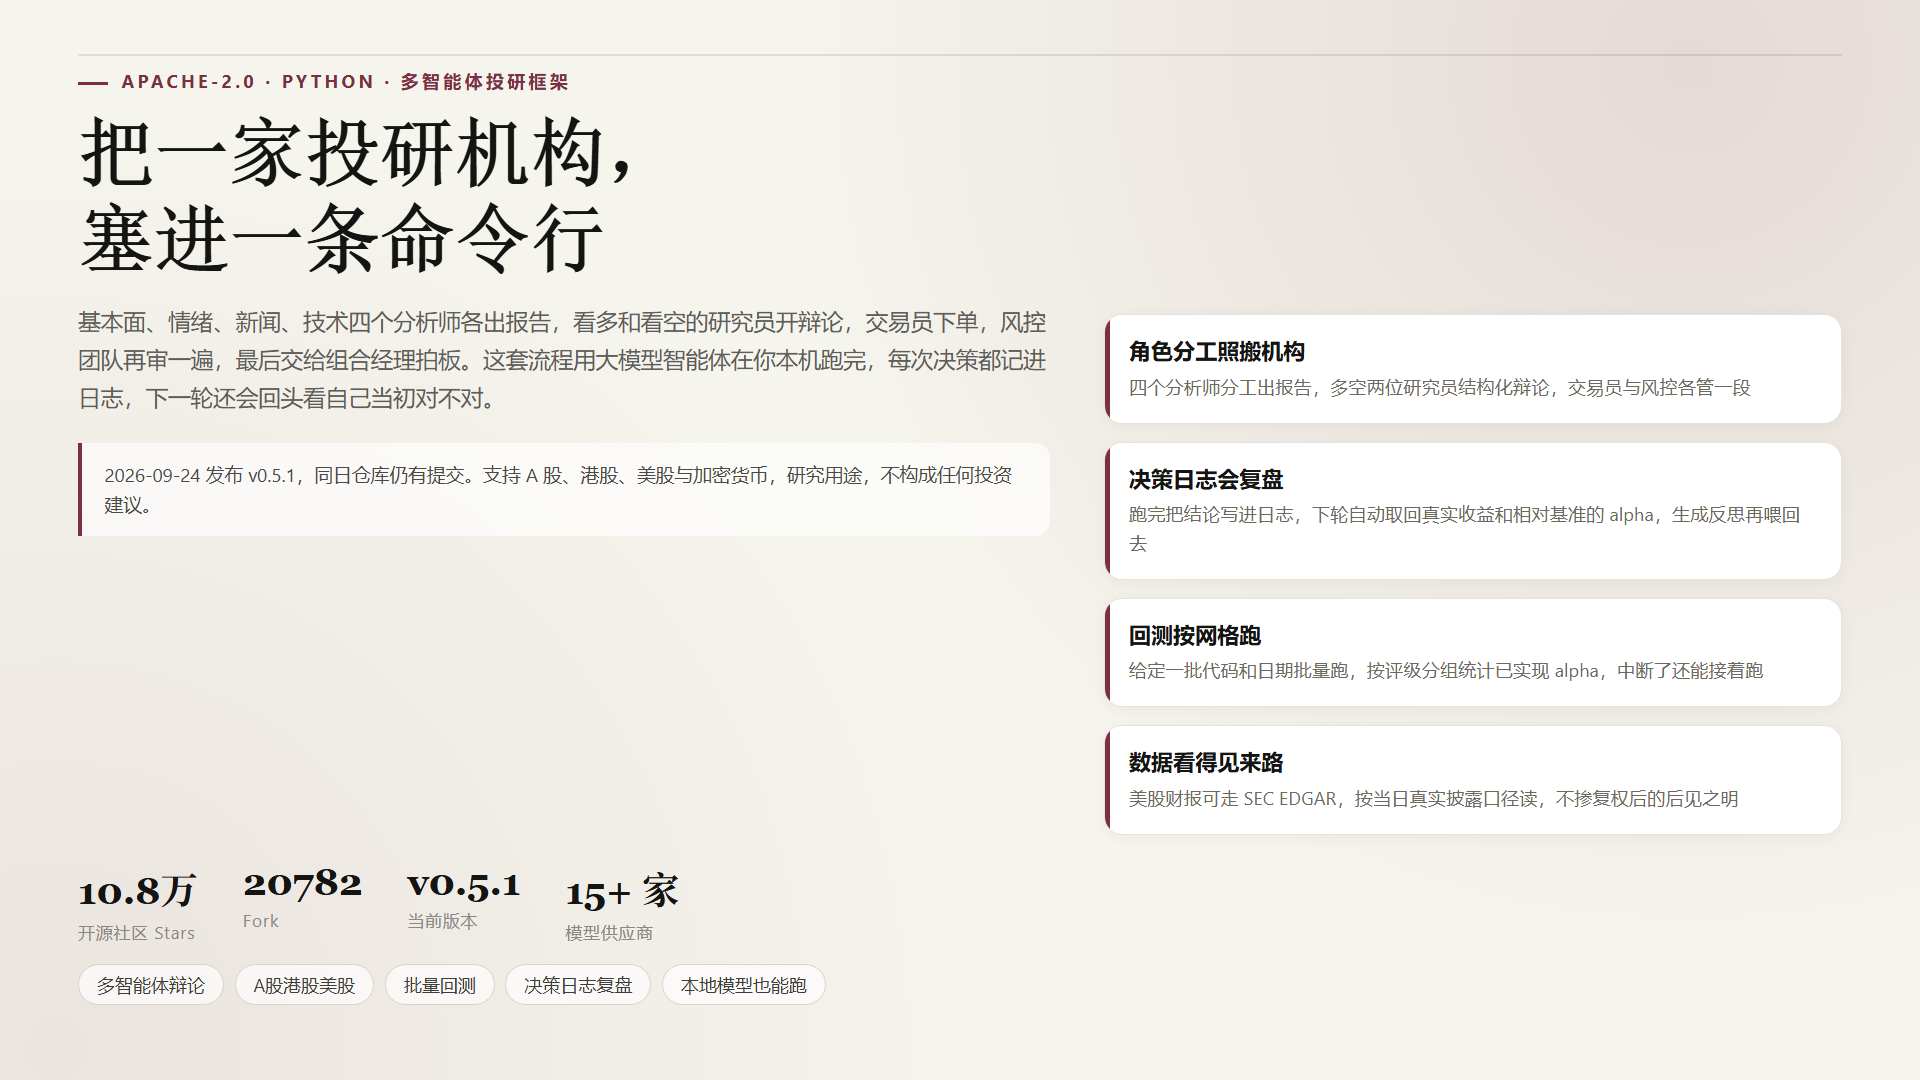
是什么
TradingAgents 是 TauricResearch 开源的多智能体金融交易研究框架,Apache-2.0 协议,Python 写的,底层用 LangGraph 编排。仓库当前 108,463 个 Star、20,782 个 Fork,393 次提交,最新版本 v0.5.1 发布于 2026 年 9 月 24 日,同一天仓库还有提交。项目有配套论文,arXiv 编号 2412.20138。
必须先把一句话摆在前面:作者明确写了这是研究用途框架,不构成财务、投资或交易建议。它的价值在于「研究多智能体分析这套机制」,不在于给出一份可以照做的买卖清单。后面讲优点的时候也请按这个前提理解。
它的角色分工基本照搬真实机构。分析师团队四个人:基本面分析师看财务和业绩指标,找内在价值和风险信号;情绪分析师把新闻标题、StockTwits 和 Reddit 的讨论汇总成一个情绪读数;新闻分析师盯全球新闻和宏观指标;技术分析师用 MACD、RSI 这类指标找形态。然后是研究员团队,一位看多、一位看空,围绕分析师的结论做结构化辩论,把潜在收益和风险摆开。再往下是交易员,把前面所有报告汇成一个交易决定,包括时点和仓位。最后是风控团队和组合经理——风控评估波动、流动性等风险因素并给出评估报告,组合经理决定批准还是否掉这笔提案。
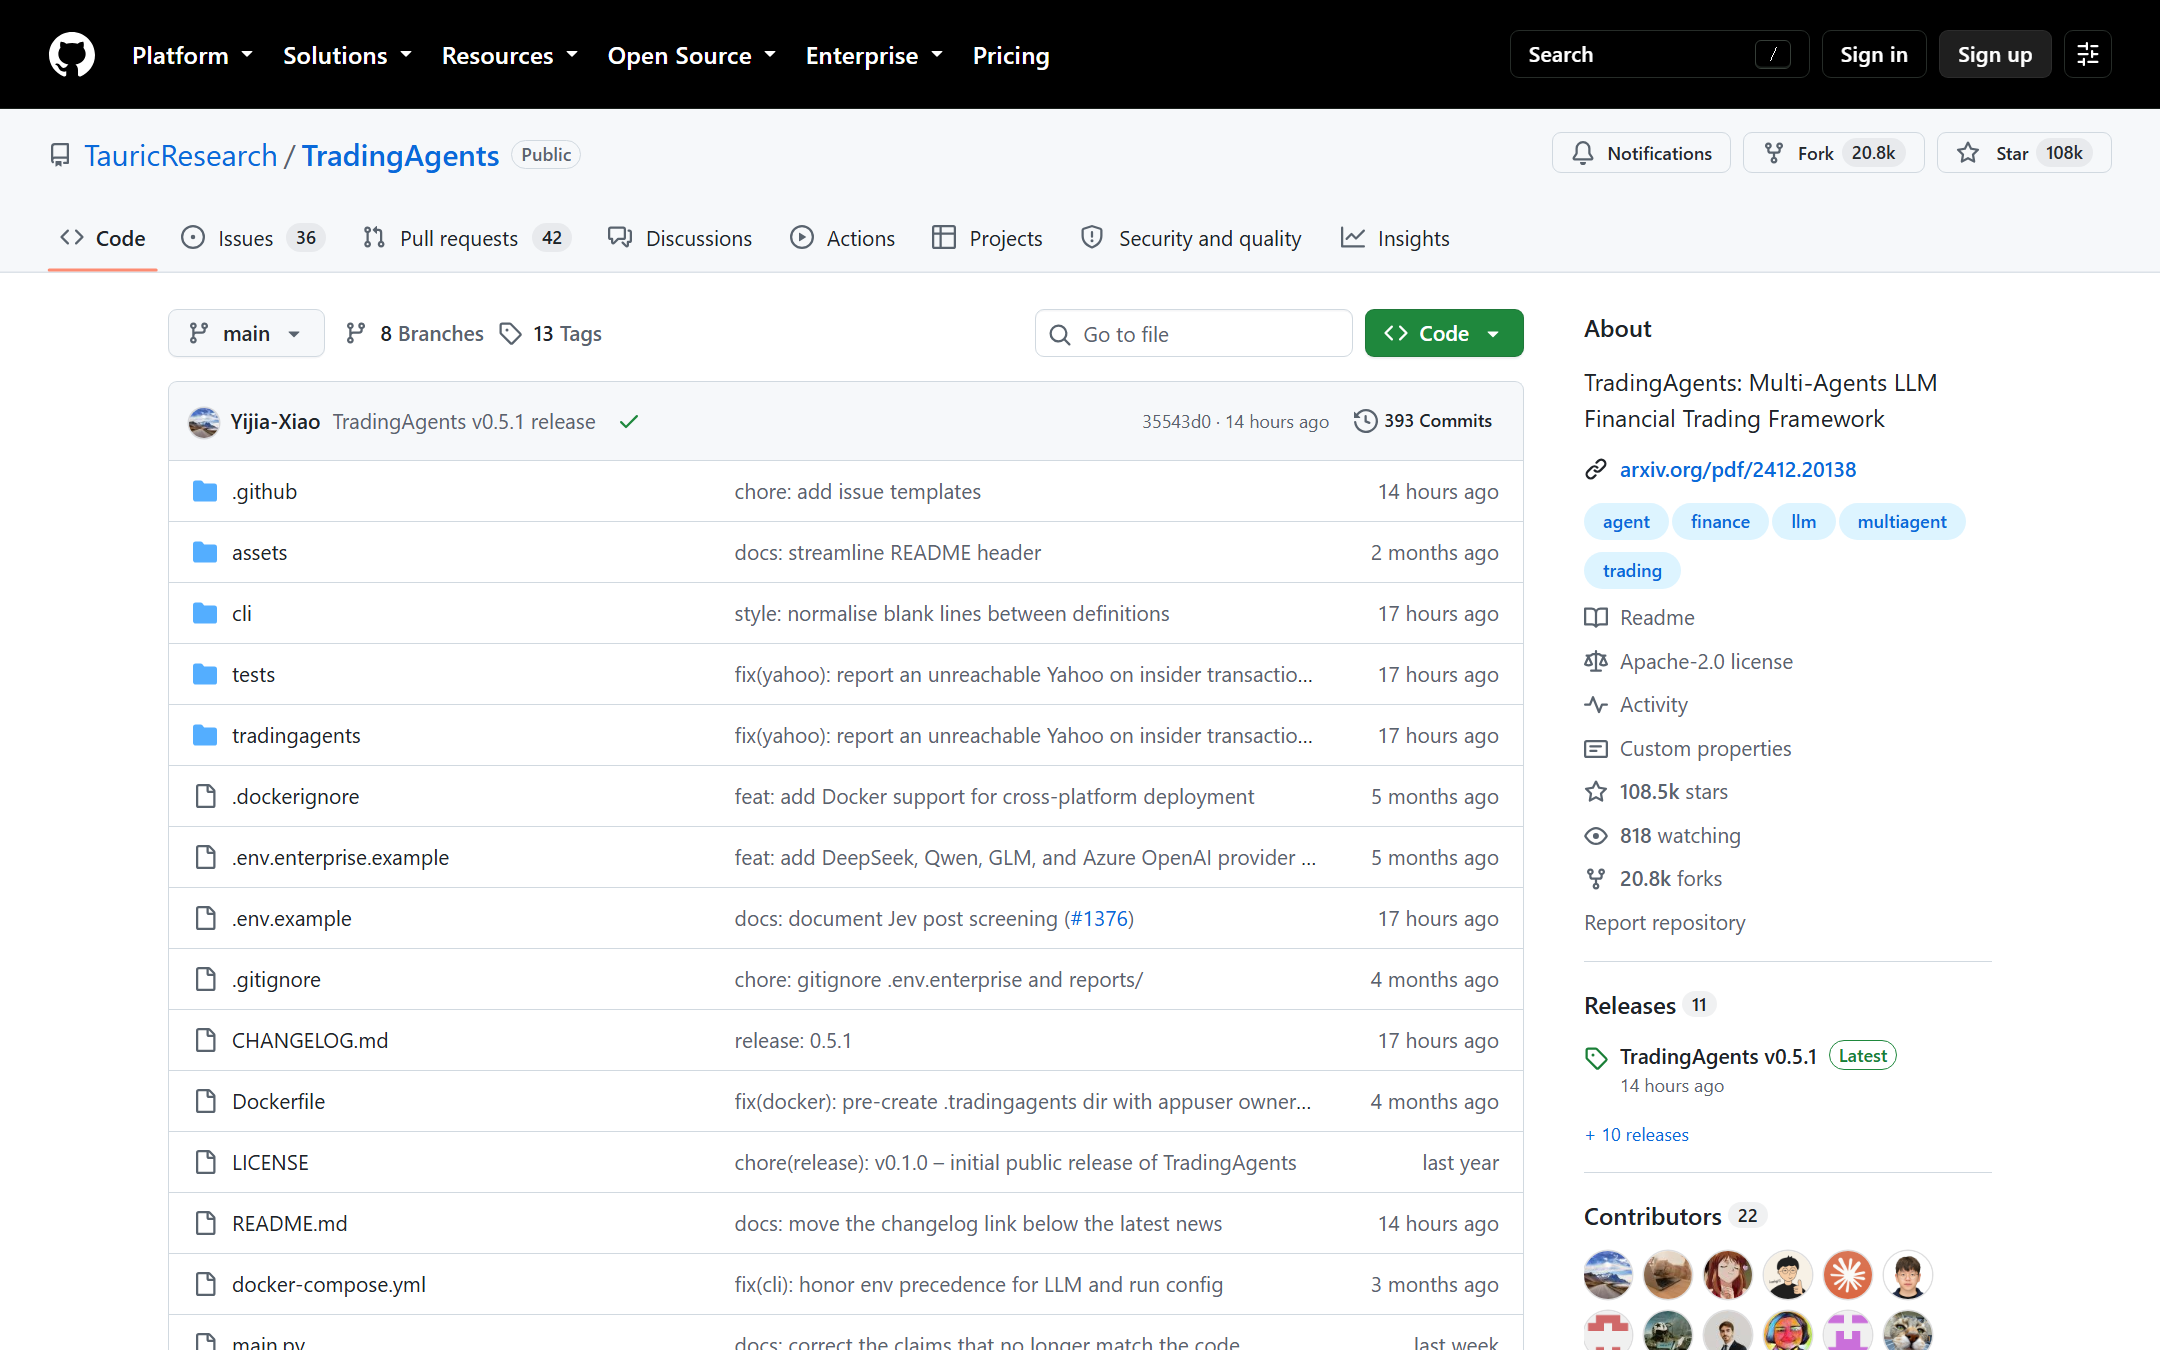
仓库首页。目录按模块拆得很清楚,侧栏显示最新版本 v0.5.1,发布至今十几个小时
它到底好用在哪儿
第一是决策日志会自我复盘,这是我觉得整套设计里最有意思的一块。日志默认开启,每次跑完把结论追加到 ~/.tradingagents/memory/trading_memory.md。下一次分析同一只标的时,它会先把上次决策的真实收益取回来——原始收益,以及相对该标的所在地区基准的 alpha——生成一段反思,再把「同标的历史决策」和「跨标的的经验教训」注入组合经理的提示词里。也就是说,它的分析会带着「上次这么判断结果如何」往前走,而不是每次从零开始。
第二是回测是按网格批量跑的,不是单次复盘。给它一批代码和一段日期区间,它会在这张网格上把同一套流水线跑一遍,把关键窗口内已经交易过的决策按评级分组打分,评分口径是相对地区基准的已实现 alpha。这个设计比「挑一只股票、挑一段好行情、跑出漂亮曲线」要诚实得多。还有两个细节做得挺到位:它不会写你个人的决策日志,跑完只写自己的;同一个 run_id 重跑会跳过已完成的格子,中断的批量任务能接着跑。
第三是美国财报走 SEC EDGAR 的「按申报时点」口径,这块比想象中重要。EDGAR 记录了每个数字的申报日期,所以一次标注为过去某天的分析,读到的财报就是那天的截面:财年已结束但还没申报的财报不会给它,后来被重述过的数字仍然按首次申报的口径出现。文档里举了个具体例子——苹果 2008 年的总资产当年申报为 396 亿美元,2010 年被重述为 362 亿,那么落在这中间时段的分析读到的是 396 亿。这解决的是量化研究里最经典的「后见之明」问题:用今天修正过的数据去评价当年的判断,结论必然虚高。EDGAR 不需要账号也不需要 key,接进数据链就能用。
第四是可组合性。模型供应商这块覆盖得很宽,OpenAI、Google、Anthropic、xAI、DeepSeek、通义千问、智谱 GLM、MiniMax、OpenRouter、Mistral、Kimi、Groq、NVIDIA NIM 都在列,跑不动云端还能接 Ollama 本地模型,或者用 openai_compatible 接任意兼容端点。市场和标的覆盖也宽:美股、港股、东京、伦敦、印度、加拿大、澳大利亚、A 股、加密货币都能跑,A 股用 .SS 和 .SZ 后缀,比如贵州茅台写 600519.SS。
还有一个持仓感知的设计值得单说。默认情况下智能体不知道你手里有什么,所以它的建议是写给「你自己去套」的通用版本。你可以传一份持仓进去,交易员、风控分析师和组合经理就会针对你的实际组合工作。文档里有句话很精确:传空的持仓列表表示空仓,这和「什么都不传」是两件不同的事,不传持仓的跑法永远不会被当成空仓处理。
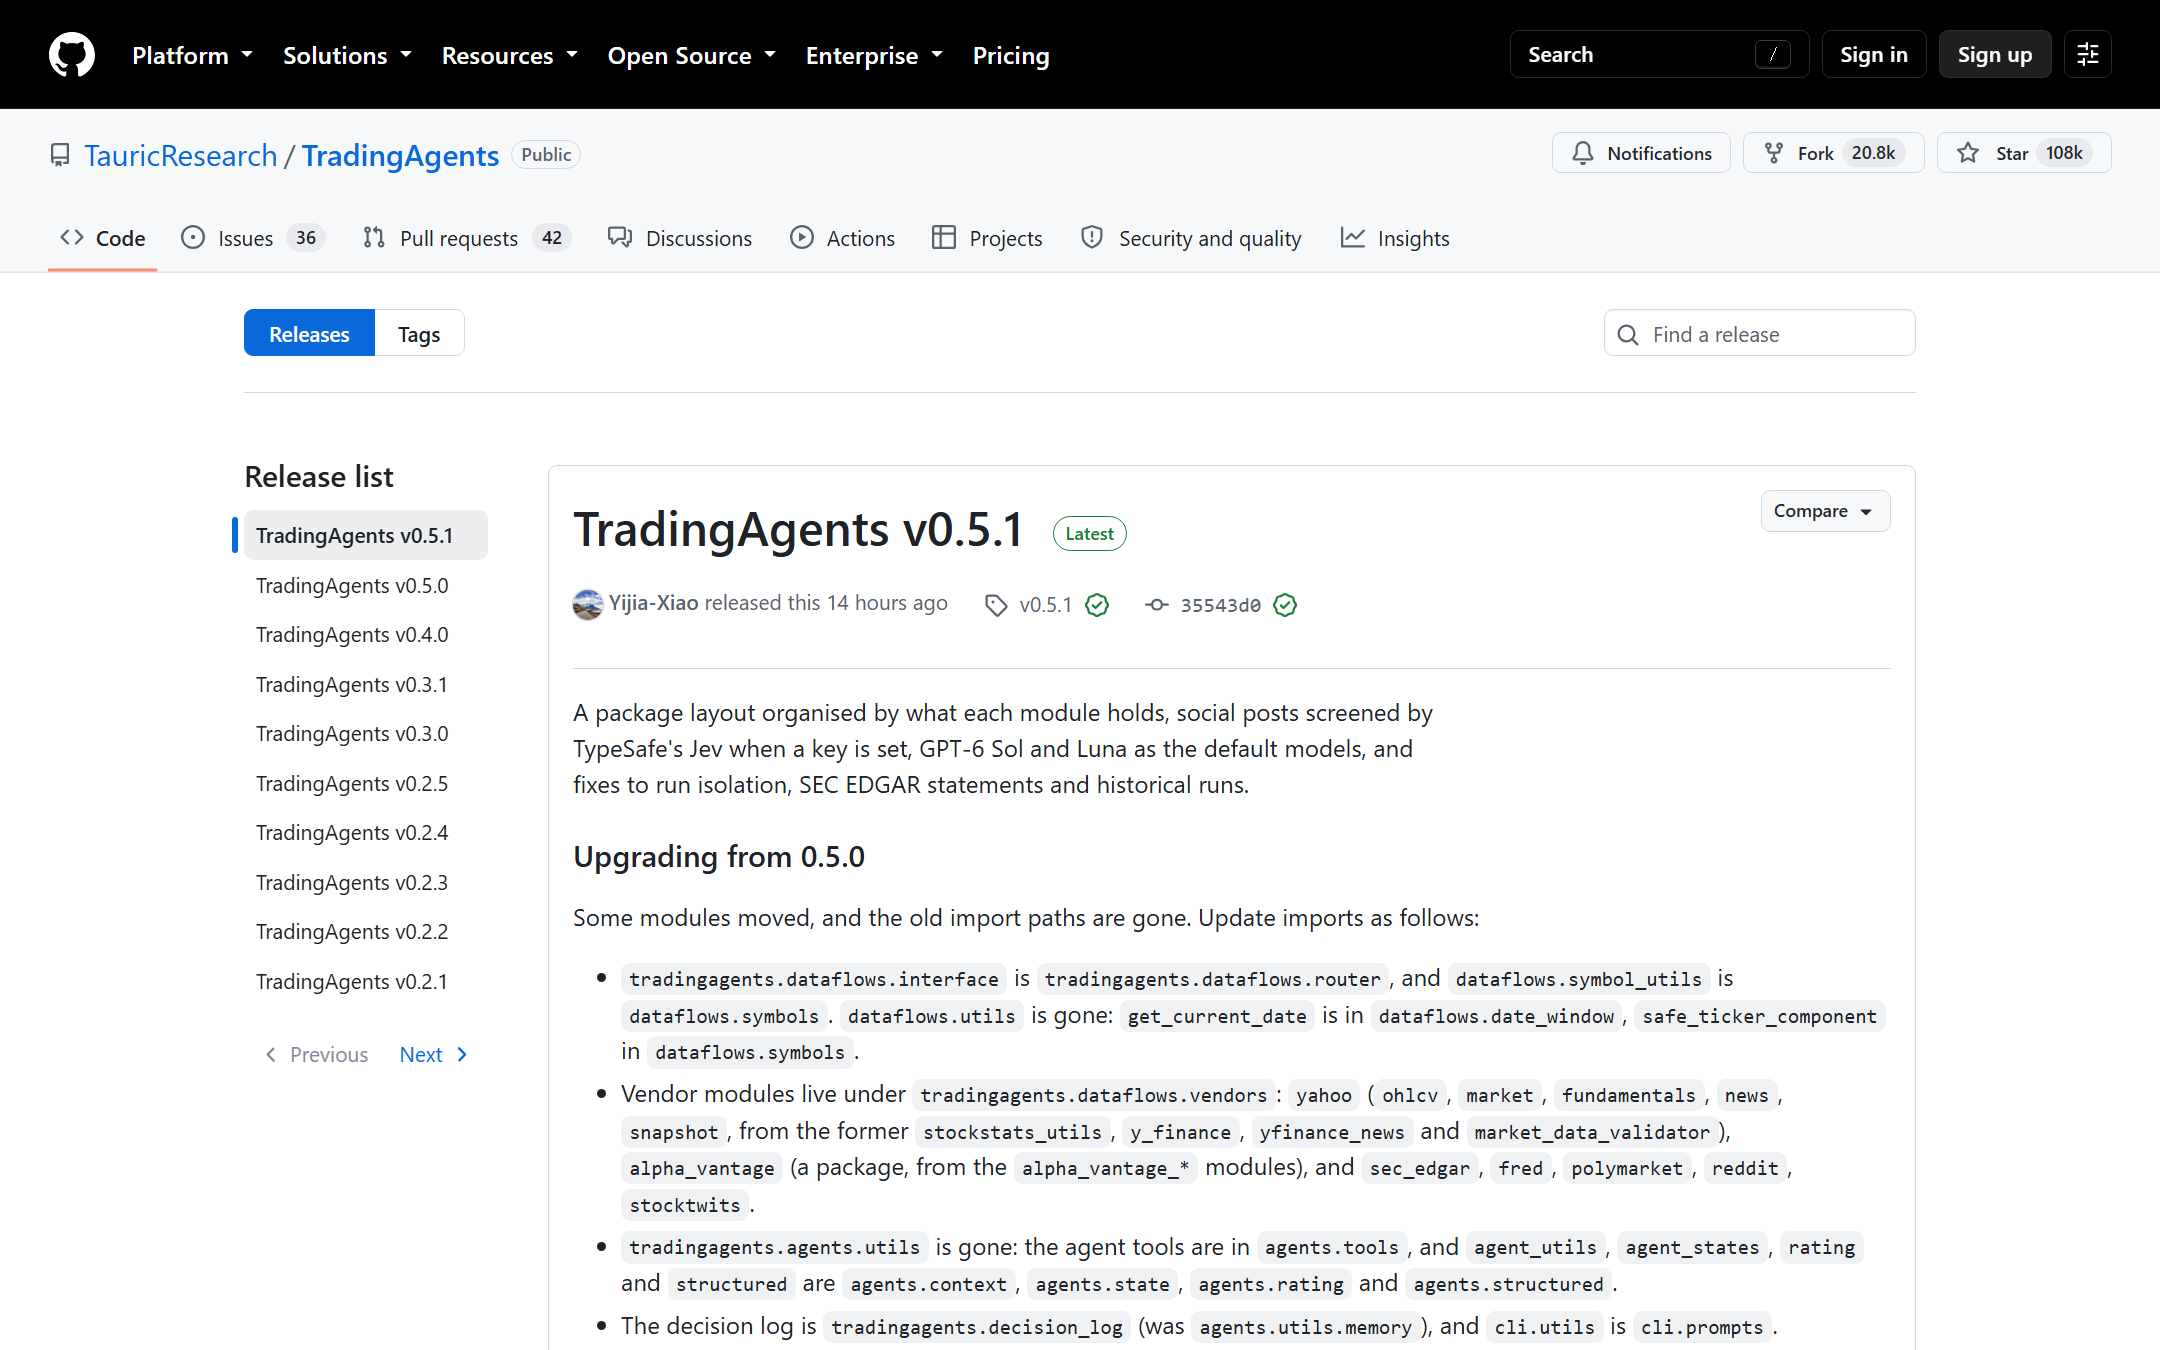
v0.5.1 发布记录。这一版重排了包结构,默认模型换成 GPT-6 Sol 与 Luna,并修了运行隔离和 EDGAR 数据
怎么用
克隆下来装依赖就行,Python 3.12:
git clone https://github.com/TauricResearch/TradingAgents.git
cd TradingAgents
uv venv --python 3.12
source .venv/bin/activate
pip install .
不想配本地环境就用 Docker,记得先把 .env.example 复制成 .env 填上 key:
cp .env.example .env
docker compose run --rm tradingagents
然后启动交互式命令行:
tradingagents
界面上会让你选标的、分析日期、模型供应商、研究深度这些参数。有个顺手的设计是,上一次跑的参数会作为默认值回填,直接回车就是沿用。写在 .env 里的 TRADINGAGENTS_* 变量会直接跳过对应的选择步骤。
写进代码里也很短:
from tradingagents.graph.trading_graph import TradingAgentsGraph
from tradingagents.default_config import DEFAULT_CONFIG

config = DEFAULT_CONFIG.copy()
config["llm_provider"] = "openai"
config["deep_think_llm"] = "gpt-6-sol"    # 负责复杂推理
config["quick_think_llm"] = "gpt-6-luna"  # 负责轻量任务
config["max_debate_rounds"] = 2

ta = TradingAgentsGraph(debug=True, config=config)
_, decision = ta.propagate("NVDA", "2026-09-01")
print(decision)
批量回测走命令行:
tradingagents backtest NVDA,AAPL --start 2026-06-01 --end 2026-08-01 --every 7
tradingagents --checkpoint        # 开断点续跑
tradingagents --clear-checkpoints # 跑之前清掉旧的
tradingagents --portfolio my_book.json
SEC EDGAR 那条链默认会带一个联系地址去发请求,官方的提醒是把它换成你自己的,别让 SEC 找上项目作者——环境变量名是 SEC_EDGAR_USER_AGENT,值里要能看出你是谁、怎么联系到你。EDGAR 只覆盖向 SEC 申报的公司,港股和 A 股会继续往数据链的下一个供应商走;它的机器可读申报从 2009 年才开始,第四季度会直接标成不可用而不是推算出来——因为申报方只把 Q4 数字放在年报里。
不足也得说清楚
最大的问题是可复现性,而且作者自己承认了。两个同样标的、同样日期的跑,结果可能不一样。原因分两类:一是语言模型采样本身不确定,即便固定温度,各家也不保证跨调用输出完全一致,而推理型模型(默认的 GPT-6 系列就是)波动最厉害,因为它的内部推理也是采样的;二是实时数据在动,新闻、StockTwits、Reddit 的内容随时间变化,所以你今天跑「上个月某个交易日」的分析,看到的价格和指标窗口是固定的,但社交和新闻源反映的是「现在」。想压低波动可以调低温度,但当前兜底模型是推理优先的,基本忽略温度,真要稳定得换成非推理模型。max_debate_rounds 调高会让结论更充分,同时也更贵更慢。
由此带来的第二个问题是:回测结果不保证能对上任何公开数字。收益取决于模型、温度、日期区间、数据质量,所以它自己说得很直白:把这框架当成研究多智能体分析的脚手架,别当成一个收益固定的策略。这个态度值得尊重,但也意味着你不能拿它跑出来的曲线去说服任何人,包括你自己。
第三条是依赖不轻。LangGraph 编排、多个数据源、每家一个 API key,想跑完整版得准备一串环境变量。虽然大部分是可选的,但功能完整度跟 key 的数量正相关。好消息是 Ollama 和兼容端点这条路是通的,全部走本地模型也能跑起来,只是速度和结论质量要自己权衡。
第四条是它的定位边界。未关闭 Issue 不多,只有 36 个,但 Pull Request 有 42 个,说明社区提交挺活跃而合并节奏相对稳。文档以英文为主,中文资料基本靠社区翻译;v0.5.1 重排了包结构,import 路径挪了位置,意味着照抄旧教程大概率会报错——升级前最好把 CHANGELOG.md 里那段「Upgrading from 0.5.0」读一遍。它的策略和风险规则是针对美股语境设计的,直接套到 A 股或港股的流动性结构上,需要自己判断哪些前提不成立。
跟同类怎么比
如果你只是想让 AI 帮忙读财报,其实不需要这套东西。单个大模型配上检索,成本低得多,也够用。TradingAgents 的价值在于「多角色互相牵制」和「决策可追溯」这两点,如果你的问题落在「多方观点冲突时该怎么权衡」这一层,它的结构才对得上。
跟传统的量化回测框架比,差别在信号来源。Backtrader、VectorBT 这类工具是规则驱动,输入是明确的指标条件,输出可精确复现;TradingAgents 是语言模型驱动,输入是新闻、财报和讨论,输出带一定随机性。两者解决的层次不同,前者是执行层,后者更像研究层。比较合理的用法是把它的结论当成一个可追溯的参考视角,而不是可直接下单的信号。
跟那些闭源的「AI 选股」服务比,它最大的好处是全透明:角色怎么分工、辩论几轮、数据从哪儿来、历史决策怎么复盘,全都写在代码和文档里,你甚至可以换掉默认模型重新验证。代价是你得自己搭环境、自己付模型和数据的钱。
我的判断是:把它当成一个研究工具和教学材料来看,它的完成度相当高——尤其是「决策日志会取回真实收益做反思」和「财报按申报时点读」这两个设计,说明作者是真的在想怎么避免自欺。但请务必记住作者那句话,它不是投资建议;20,782 个 Fork 和 10.8 万 Star 说明关注度很高,关注度高不等于策略有效。真想拿它做点什么,先用回测网格在自己的标的池上跑一轮,看清楚它在什么行情下判断得准、什么行情下会乱,再谈别的。
GitHub:https://github.com/TauricResearch/TradingAgents
论文:https://arxiv.org/abs/2412.20138
标签:#TradingAgents #多智能体 #LLM #量化研究 #LangGraph #金融科技 #回测 #开源框架
你觉得让多个 AI 分工辩论得出的结论,会比单个模型的分析更靠谱吗?