AI Agent 这件事,很多人已经卡在一个很具体的阶段:手上不止一个。Claude Code 装了一个,Codex 挂着一个,OpenClaw 也试过,Manus 偶尔用。单个都挺能干,但每次派活还是得自己打开窗口、把上下文复制过去、等它跑完、再把结果转交给下一个。工具越多,人反而成了那个最慢的中间件。
LobeHub 这一版想解决的就是这个问题。它没打算造一个更聪明的 Agent,而是去做那个站在所有 Agent 上面派活的人。
是什么
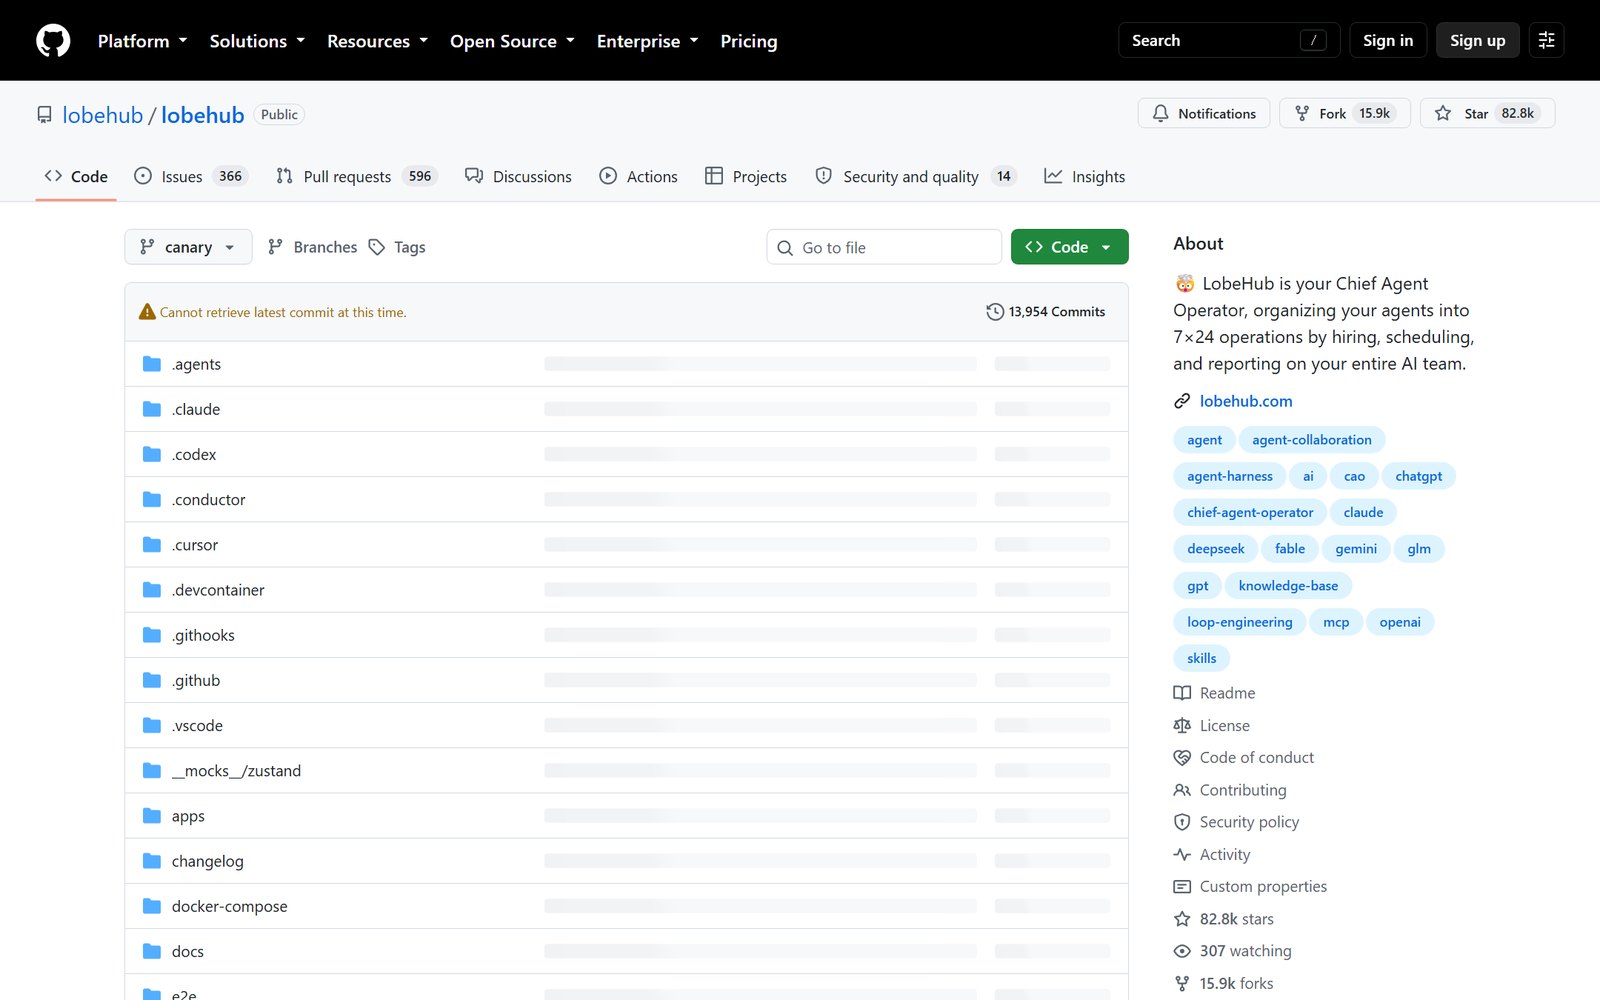
lobehub/lobehub,TypeScript 写的开源 AI Agent 平台,8.3 万 Star、15911 Fork,当前版本 v2.2.18(2026 年 9 月 20 日发布),9 月 22 日仓库仍有提交,待处理 Issue 366 个、待合并 PR 105 个。项目 2023 年 5 月开源,最初叫 Lobe Chat,2026 年 1 月 27 日正式升级为 LobeHub。
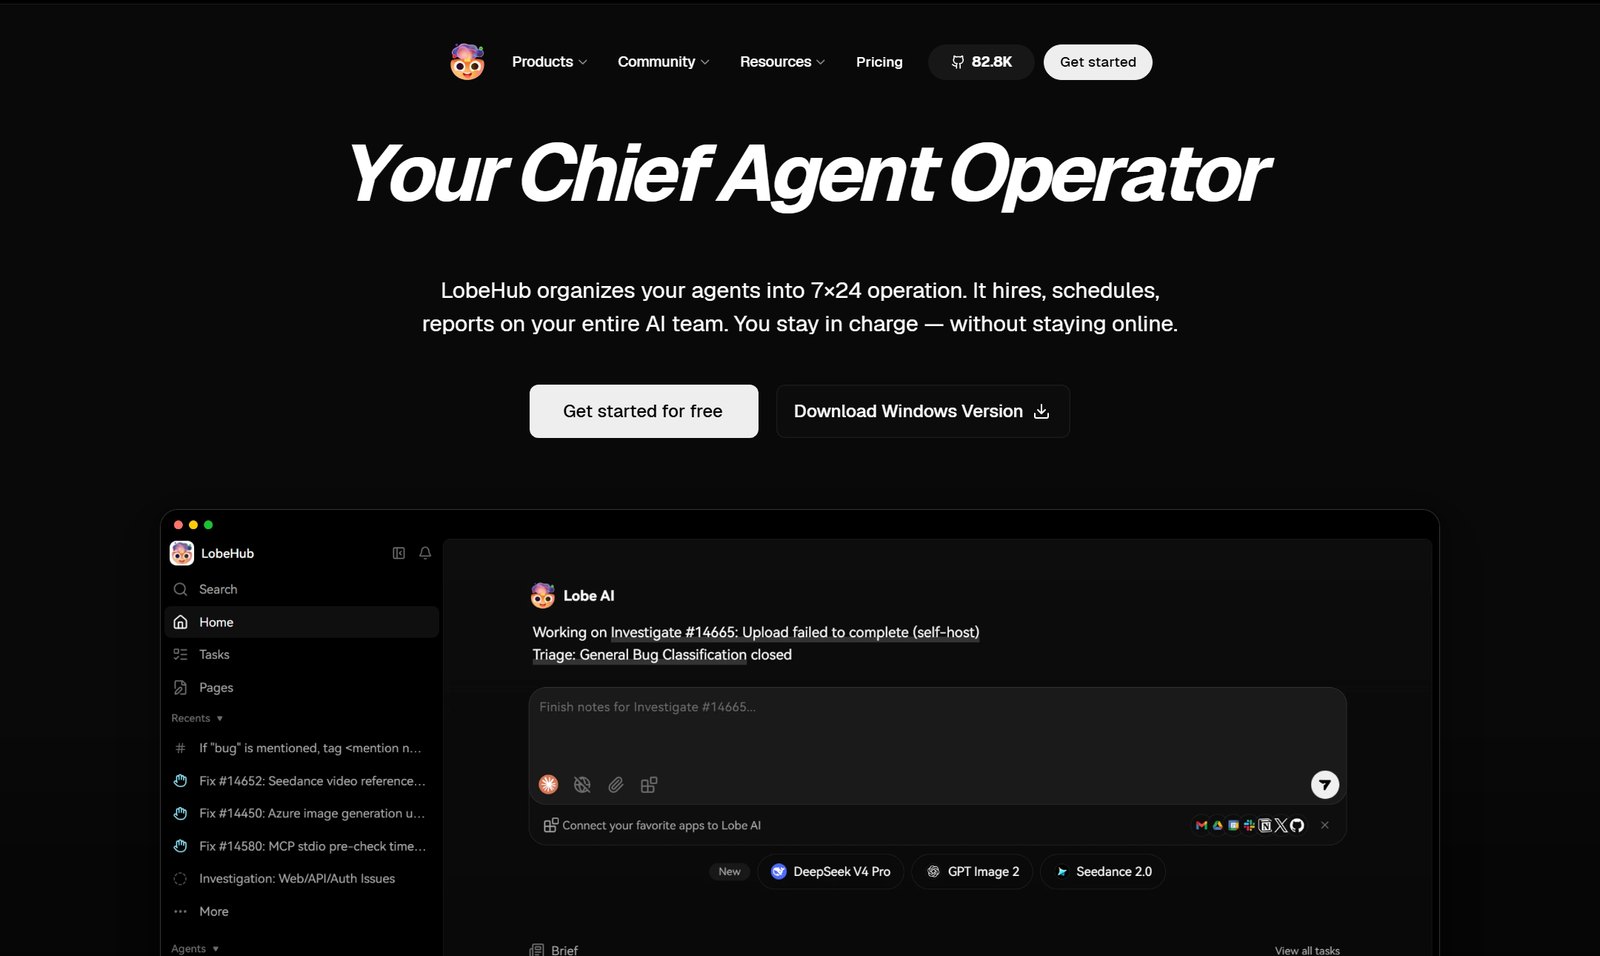
这次升级不是改个名。它的定位从"多模型聊天界面"换成了 Chief Agent Operator——首席 Agent 运营官。官方在 2.2 的发布说明里把用户反馈原样写了出来:不少人已经有 Claude Code、Codex、Manus、OpenClaw 了,缺的不是另一个更聪明的 Agent,而是一个能把这些管起来的入口。所以它把自己放在了所有 Agent 之上:你给目标,它拆任务、选人、排期、执行、汇总结果。
核心优势
入口是一句话,不是一张编排图。你把要做的事描述出来,它自己拆成子任务,从技能市场里挑合适的 Agent 组队——官方公布的市场规模是 27.3 万条 Skills、5.1 万个 MCP 服务——然后在云上并行跑。不用写 YAML,不用碰 Docker,也不用守着看。这件事看起来只是省了几步操作,但它改变的是使用前提:以前你得先学会怎么编排,现在你只需要说清楚要什么。
它不挑 Agent 的出身。这是我觉得整个方案里最有意思的一处设计。Claude Code、Codex、OpenClaw、Manus、Cursor 都以一等公民的身份接进来,可以同时跑十个 Claude Code 会话,OpenClaw 的记忆能一键迁过来。它不去争"谁家的 Agent 更强",而是在上面做跨厂商的调度。对已经在特定工具上积累了很多上下文的人来说,这一点比任何单个功能都实在——你不用为了用它而推倒重来。
交互从"追着问"变成"等它报"。v2.2 的 Daily Brief 是一份日报:夜里跑了什么、哪几件等你拍板、今天排了什么活。打开就是一份汇总,觉得行就回一句"approve"。这个改动方向是对的——Agent 数量一多,真正的瓶颈从来不是执行速度,而是人每天要花多少时间去做状态同步。
它住进你已经在用的聊天软件。IM 网关原生接 Slack、Discord、Telegram、微信、飞书、Lark、LINE、QQ、iMessage。不用再开一个新的收件箱,@ 一下它就能派活,有重要进展它自己来找你。工具最大的摩擦往往不是功能不够,而是"要切过去";把入口搬到日常聊天里,摩擦就没了。
架构上按操作系统来设计。它内部把 Agent 运行环境定义成 Agent Harness,类比很直白:模型是 CPU,上下文窗口是 RAM,Harness 是操作系统,Agent 是跑在上面的应用。Harness 分四层——适配不同服务商协议的模型运行时、管工具调用和错误恢复的 Agent 运行时、决定什么信息在什么时刻送给模型的上下文引擎,以及提供 Page、Task、Group、IM 多种运行表面的环境层。模型能力正在趋同,Harness 的质量越来越像决定产品上限的那个变量,这个判断我认同。
它会自己变好一点。官方提到通过 Agent Operation Tracing 自动捕获错误模式,已经自己发现并修掉了 20 多个 Harness 级的问题,Agent 任务成功率从 75% 提到 95%。这类数字来自官方,实际效果要自己跑过才算数,但"能从失败里归纳出模式"这件事本身,比单纯堆功能更值得关注。
团队场景是一等公民。知识库、项目管理、定时任务、协同编辑、团队空间都在,支持 100 多个模型、40 多家服务商,也能接 Ollama 跑本地模型。一个团队把 API Key 和模型访问统一管起来,比每个人各自开一堆账号要清爽得多。
怎么用
想先看看长什么样,直接用官方云版本最快,注册就能建 Agent、拉技能、接 IM。想把数据放在自己这边,Docker 一条命令起来,或者按文档部署到 Vercel、Zeabur 这类平台上,也能装桌面版。
上手路径建议倒着来:先不要碰"编排"这个词。第一天只做两件事——建一个 Agent,把它的角色和技能配好,自己聊几轮确认它能干活;再去市场里加两三个真正用得上的 MCP 服务。等你确认单个 Agent 靠谱了,再试着把一整件事描述给它,让它自己去拆。上来就设计"多 Agent 协作流程"的人,大概率会在配置界面里消耗掉一天的耐心。
第二步是接 IM。把它接进 Slack 或飞书之后,使用习惯会明显改变——以前是"我想起来要用 AI",之后是"顺手 @ 一下"。定时任务也值得早点配,日报、数据巡检、代码 Review 这类固定动作交给它按点自己跑,比手动触发省心。
不是没有槽点
协议从 MIT 换掉了,这是最需要提前确认的一条。仓库现在的许可不是 MIT,而是自定义的社区许可,商业使用受限。这件事影响很大:企业内部自部署、拿它做对外产品、需要信创合规的场景,都要先把条款逐条读完再决定。开源项目改协议是它的权利,但对使用者来说,这条是硬约束,不是小字。
自托管版和云版的功能差距在拉大。云上跑的能力(比如某些编排和调度特性)落地到自托管需要时间。你要是冲着"完整功能 + 数据自己管"去的,先确认想要的那几个特性在自托管版本里到底有没有。
它依赖外部 Agent,也就继承了外部的脾气。把 Claude Code、Codex 这类工具接进来,意味着你的成功率、额度、稳定性都同时取决于别人的服务状态和定价。调度层再稳,底层接口一变,你的流程就得跟着调。这是这种架构的固有代价。
能力和复杂度是绑在一起的。Agent 群组、白盒记忆、技能市场、IM 网关、定时调度——功能铺得很开,配置项自然也多。个人用户想找个"打开就能用"的聊天界面,会发现它比想象中重;它的价值要在你手上确实有一堆 Agent 和一堆重复任务的时候才显出来。
自演化的效果需要自己验证。成功率从 75% 到 95% 是官方数据,你的任务类型、你接的模型、你所在的网络环境都会影响最终表现。别把宣传数字当成自己的预期值。
跟同类怎么比
对 Open WebUI。Open WebUI 是本地模型用户的首选,RAG 和权限治理这块做得很扎实,团队 OAuth、角色控制、移动端都比较成熟,协议也更宽松。LobeHub 赢在 Agent 生态和编排:技能市场、Agent 群组、调度、IM 网关这一整套它跑得更靠前。一句话区分——你要是主要想给团队一个能接本地模型的好用聊天入口,Open WebUI 更稳;你要是想让一堆 Agent 替你干活并汇报,LobeHub 才是对的方向。
对 Dify。Dify 面向的是"我要搭一个 AI 应用",工作流画布、发布渠道、后端集成都在它那边做得更完整。LobeHub 面向的是"我要管一支 AI 队伍"。前者是造产品,后者是管生产。做业务系统选 Dify,做个人或团队的自动化选 LobeHub。
对 Cherry Studio 这类桌面客户端。Cherry Studio 开箱即用、零配置,预制助手一大堆,装完立刻能干活,这是它的优势。但它没有 Agent 群组协作、没有调度、没有 IM 网关,本质还是一个更强的本地客户端。要的是省事选它,要的是系统选 LobeHub。
对 Manus 这类浏览器操作型 Agent。Manus 强在执行——真的去点网页、填表单、走流程。LobeHub 强在协作和持续记忆,自己不一定是最能干的那个,但知道该让谁干、什么时候干、干完跟谁汇报。两者不是替代关系,是上下游:你完全可以把操作型 Agent 当成被调度的一员。
对"自己拿框架硬搭"。用通用 Agent 框架当然自由,但调度、记忆、权限、IM 接入、技能分发这些全部要自己写,最后做出来的东西通常离 LobeHub 还差好几轮迭代。除非你有非常特殊的合规或架构要求,否则不值当。
一句话:你手上已经有好几个 Agent、每天在它们之间手动搬上下文、还想让固定的事自己按点跑完并给你汇报,那 LobeHub 是目前这条路上做得最完整的一个;你要是只想找个漂亮的聊天界面,那它给的绝大部分东西你都用不上,还得替协议条款操一次心。
项目地址:https://github.com/lobehub/lobehub
官网:https://lobehub.com/
标签:#AI智能体 #多智能体编排 #Agent平台 #开源工具 #自托管 #效率工具
你现在电脑里装着几个 AI Agent,又是怎么在它们之间来回搬活的?