DeepSeek 官方应用为什么能卖到全网最低价,答案之一一直锁在它自己的机房里。10月16日,这把锁打开了:驱动 DeepSeek 大规模线上服务的推理框架 DeepInfer 开源,Apache-2.0 协议。截至10月28日,仓库拿到 23324 颗星、2722 次派生,上线11天。
README 第一句写得很直白:这是支撑 DeepSeek 大规模生产服务的高性能推理框架,这次开源提供离线推理,附带规模化服务所需的核心功能。当前适配的模型是 DeepSeek-V4.1-Flash。计算内核复用自家整套积木:FlashMLA、DeepGEMM、DeepEP,加上自研 TileLang 内核。
调度层面的东西是这次的重头。注意力并行、均衡上下文并行、MoE 专家并行加 EPLB 负载均衡;DSpark 置信度调度验证,用草稿 token 加速解码;SWA 有界重放,只重放有界后缀来削减预填充开销;异步调度默认开启,CPU 批调度和设备执行重叠跑。
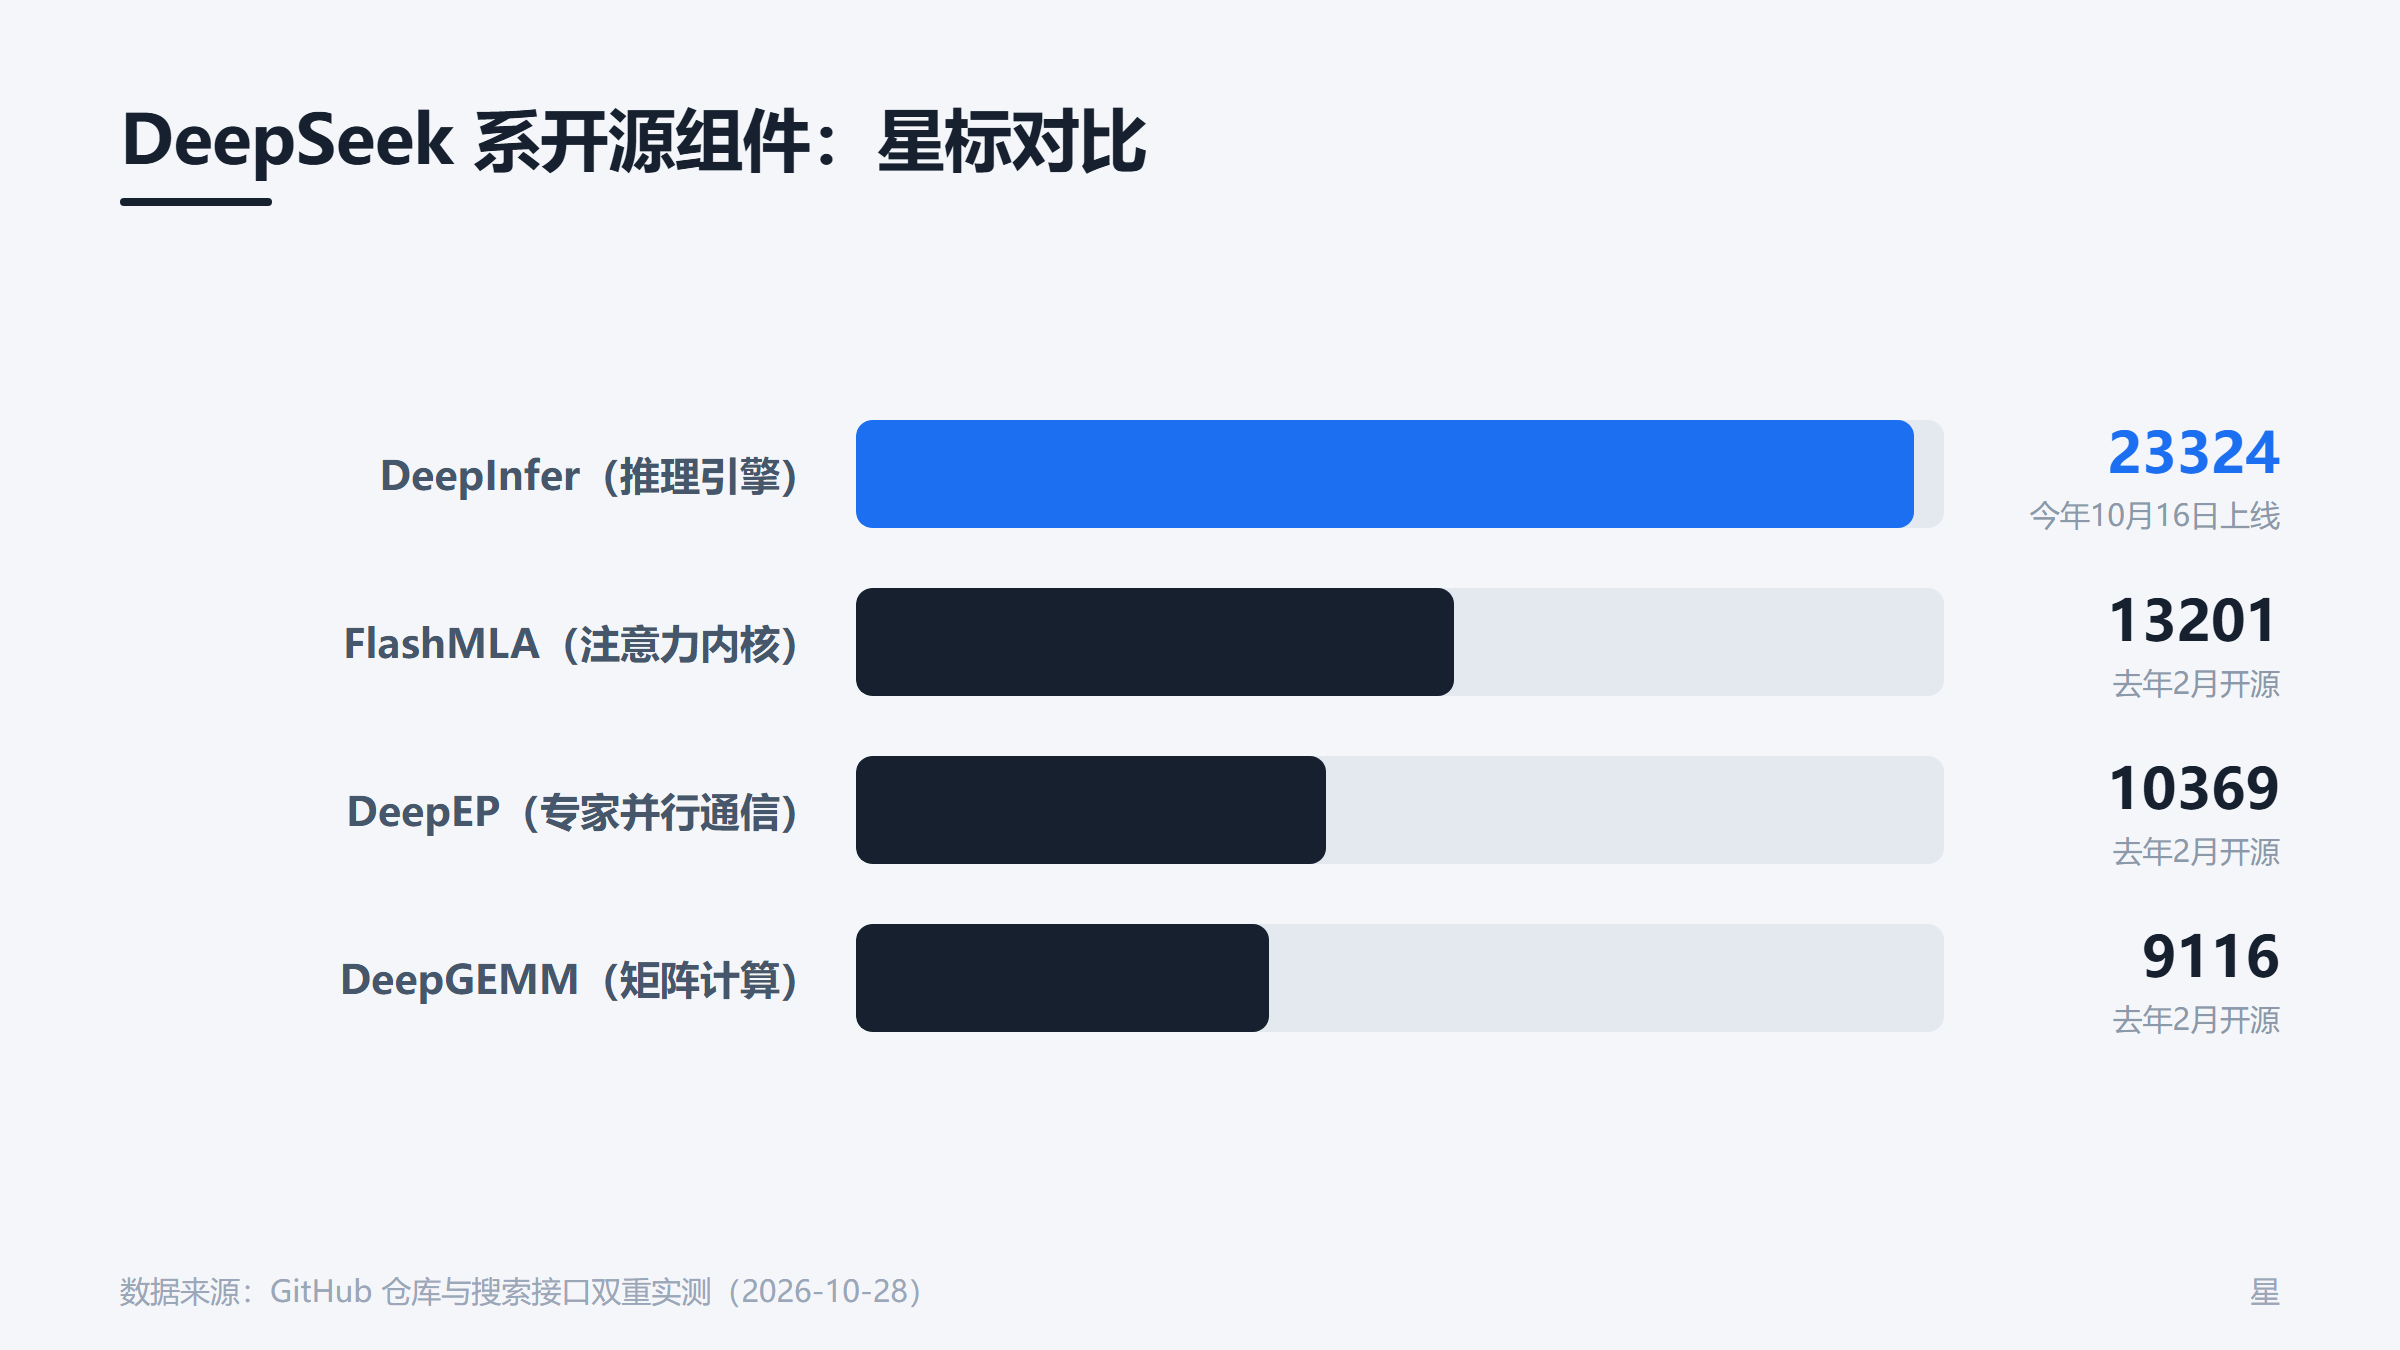
DeepSeek 系开源组件星标对比(截至10月28日)(数据来源:公开数据整理)
两个特性平时少见,值得单独说。一是批不变推理和确定性采样:同一段输入、同一组参数,跨不同批次组合输出完全一致,跑对账、审计类业务的人知道这有多值钱。二是结构化输出:生成结果直接被正则、JSON Schema 或语法规则约束,喂给下游程序不用再修边幅。
硬件支持名单里藏了个大新闻:NVIDIA SM100 之外,华为昇腾 950 NPU 写在第一批支持里。运行要求也是双轨并列——NVIDIA 走 CUDA 13,昇腾走 CANN 9.2,都要 Linux、Python 3.12。
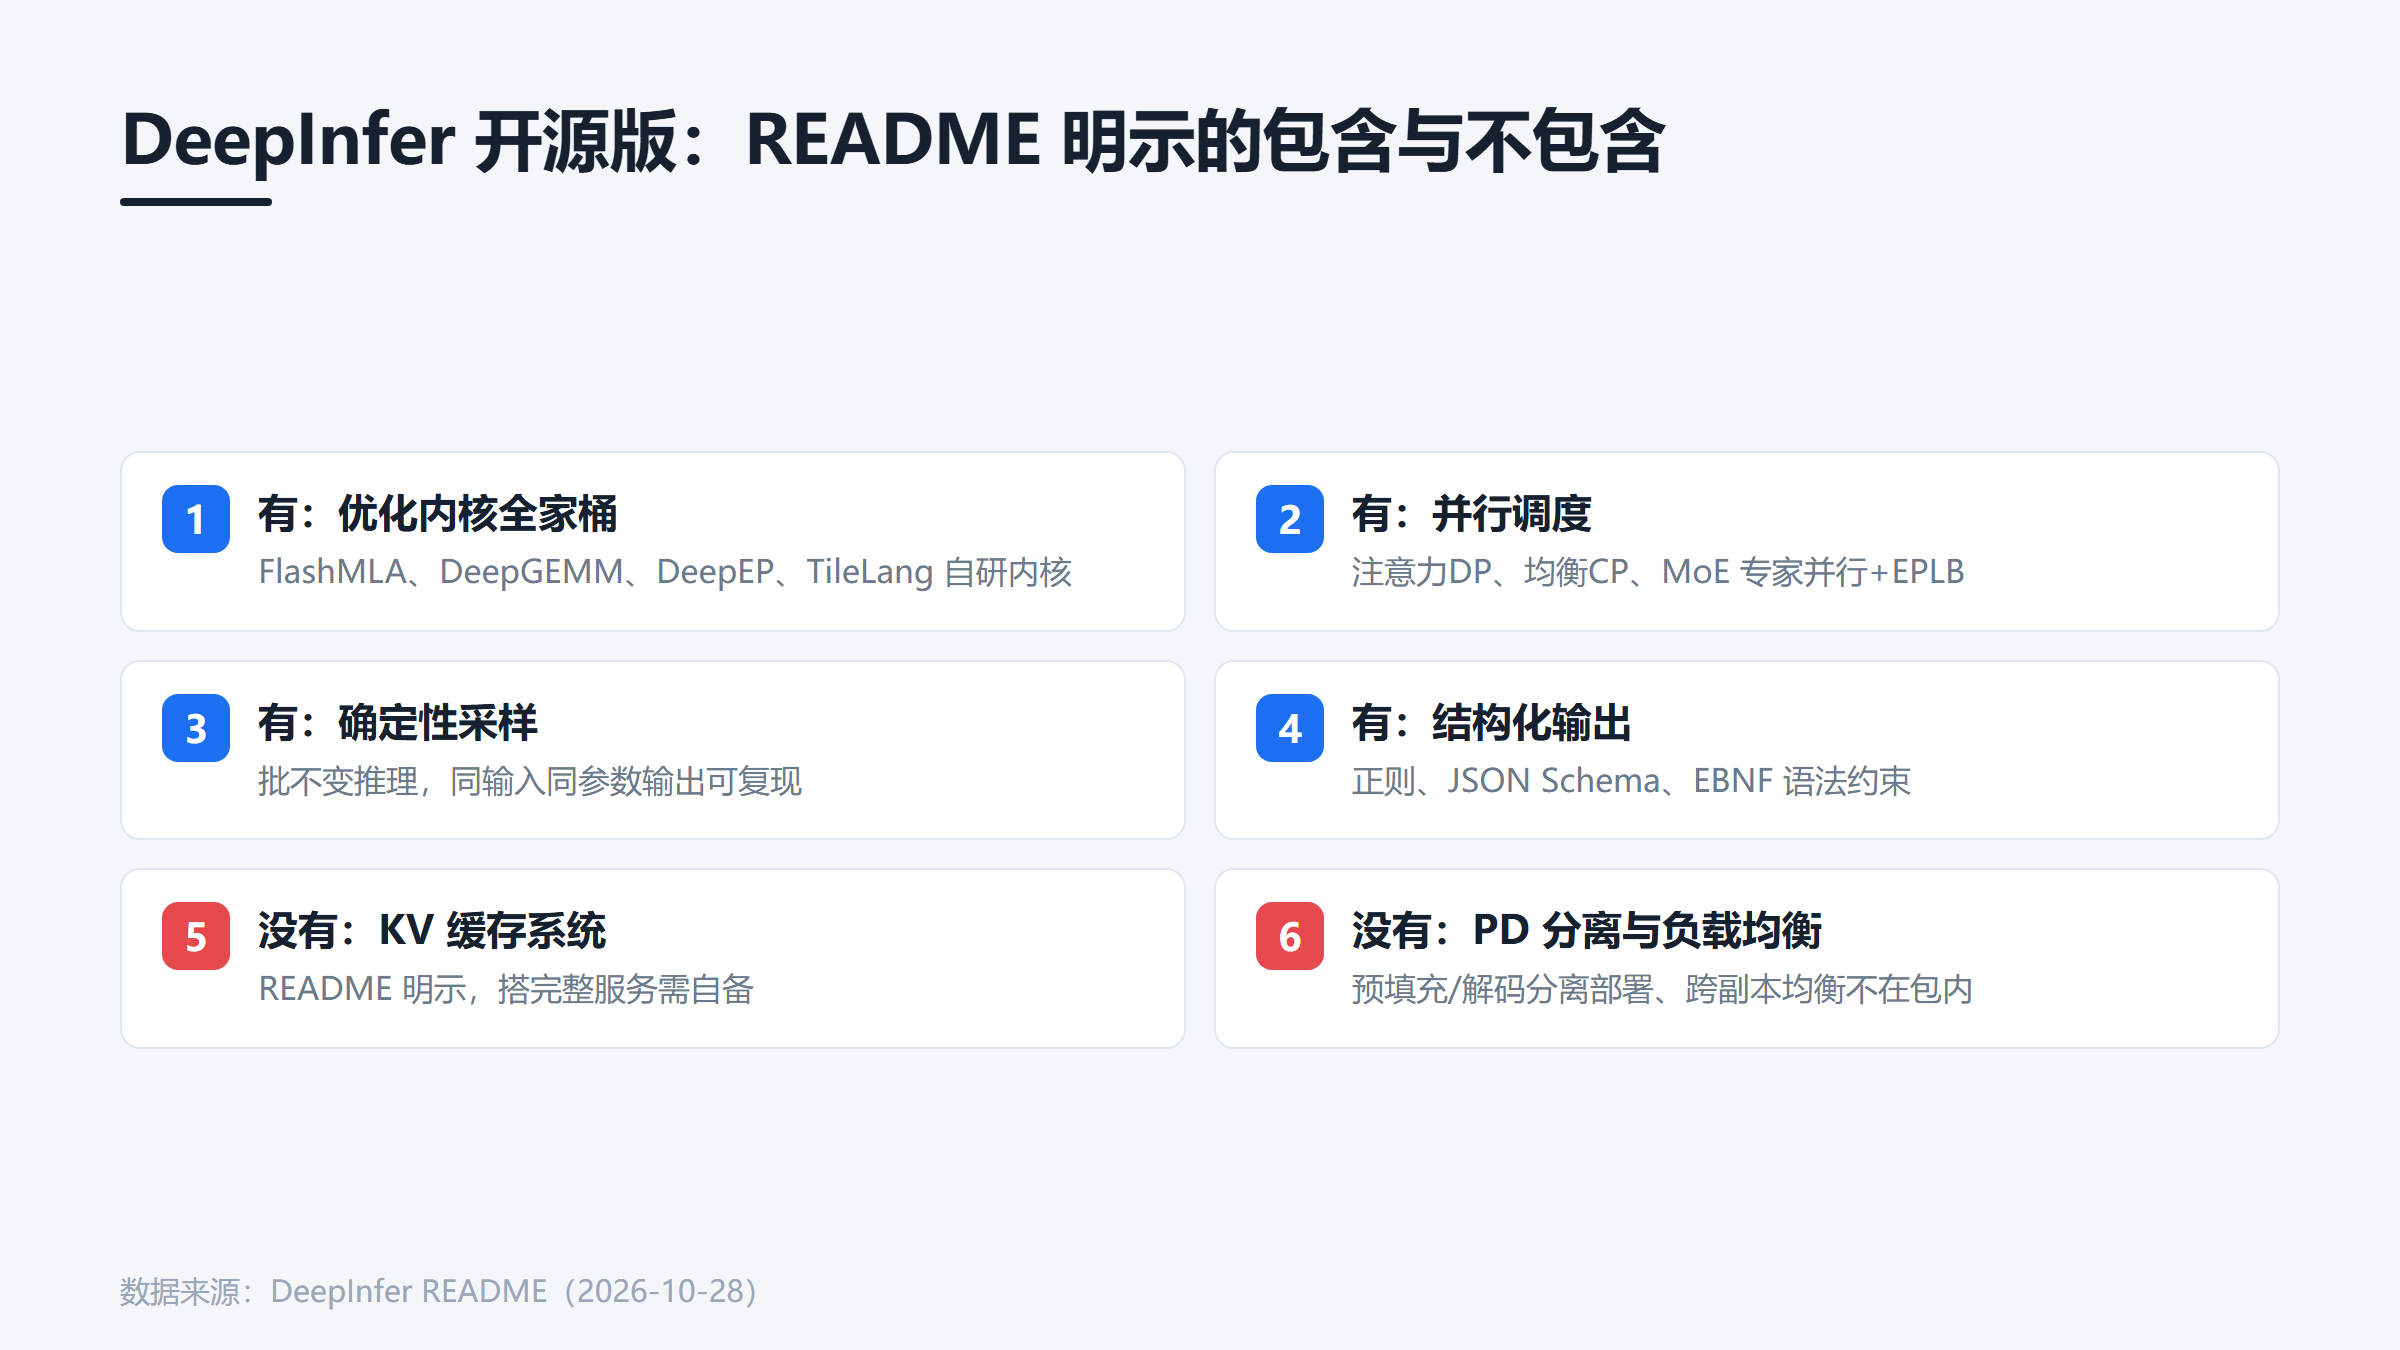
开源版里有什么、没什么(README 明示)(数据来源:公开数据整理)
有三件事要看清。
第一件,开源的是引擎,不是整套服务。README 明说 KV 缓存系统、预填充与解码分离部署、跨副本负载均衡都不在这次包里——想搭完整服务还得自己补。官方留了一手,也留了路标。
第二件,昇腾 950 进了官方工具链第一梯队。国产芯片和大模型官方框架的适配,过去多是社区行为,这次直接写进 DeepSeek 自家仓库的运行要求,规格和 CUDA 并排。这个信号比星标数字大。
第三件,11天超过自家内核三件套八个月的积累。FlashMLA、DeepGEMM、DeepEP 去年2月开源,至今星标在一万上下;DeepInfer 十一天到了 23324。框架层的开源比内核层更能带动下游生态,星标速度只是这个差别的影子。
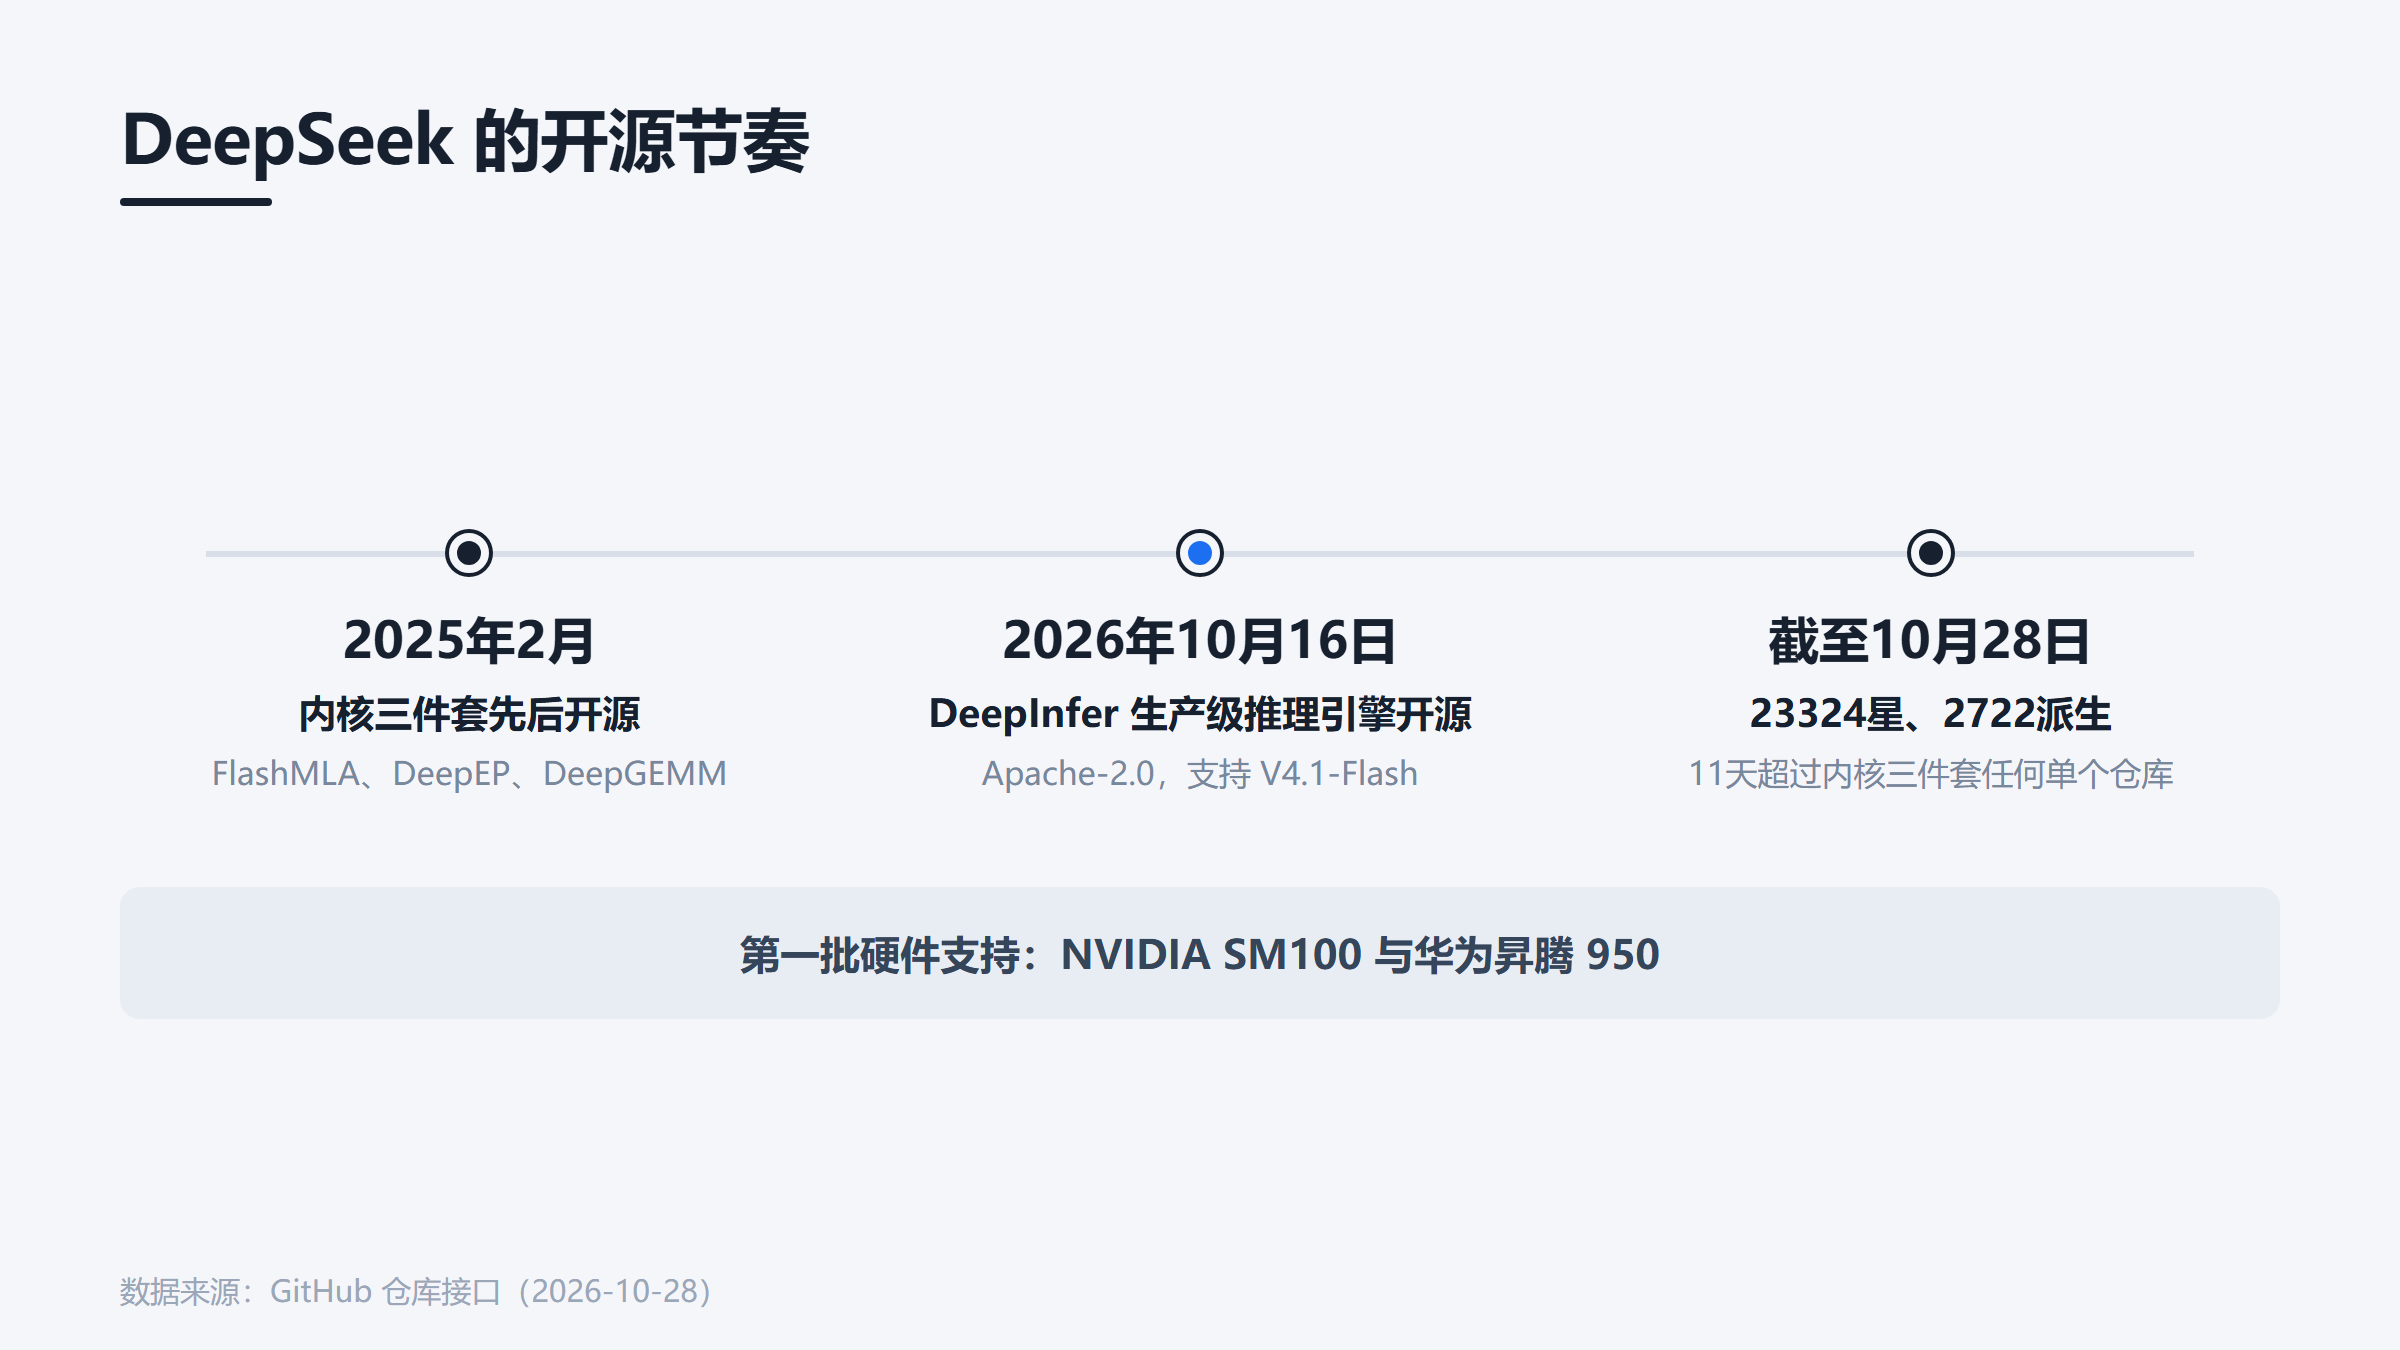
DeepSeek 开源节奏时间线(数据来源:公开数据整理)
参照系是社区里现成的方案:vLLM、SGLang 都能跑 DeepSeek 模型,但官方引擎带着生产环境验证过的调度器和确定性保证进场,定位不一样。
你会把手头的推理框架换成官方版吗?说说你现在的部署方案,评论区比一比。