把扫描件、随手拍的文档丢给 OCR,出来的文字看着都对,可表格里少了一行、公式里错了一个下标,等你发现时已经贴进报告里了。问题在于,OCR 从来不告诉你它哪里没把握。
MiniCPM-OCR 是 OpenBMB 开源的一套文档解析模型,10 月 27 日上线,Apache-2.0 协议,764 个 star。它其实打包了两件事:一个 1.3B 参数的 MiniCPM-OCR 1.0 负责把文档转成文字、表格、公式、图表和印章,另一个 2B 参数的 MiniCPM-OCR Jev 专职判断这段结果可不可信。
MiniCPM-OCR 仓库首页,1.0 与 Jev 两个模型挂在一起
Jev 的用法很直接:给它图片和对应的 OCR 结果,它返回一个 0 到 1 的质量分。在 JevOCRBench 上它的 AUROC 达到 93.6,比 35B 的 JEV-35B-A3B(90.1)还高,接近 397B 的 Qwen3.5-397B-A17B(93.8)。而且它不是只认自家的输出:对 MiniCPM-OCR 1.0、GLM-OCR、PaddleOCR-VL-1.6、Xiaomi-OCR-0 四种解析结果,AUROC 落在 91.9 到 93.4 之间。
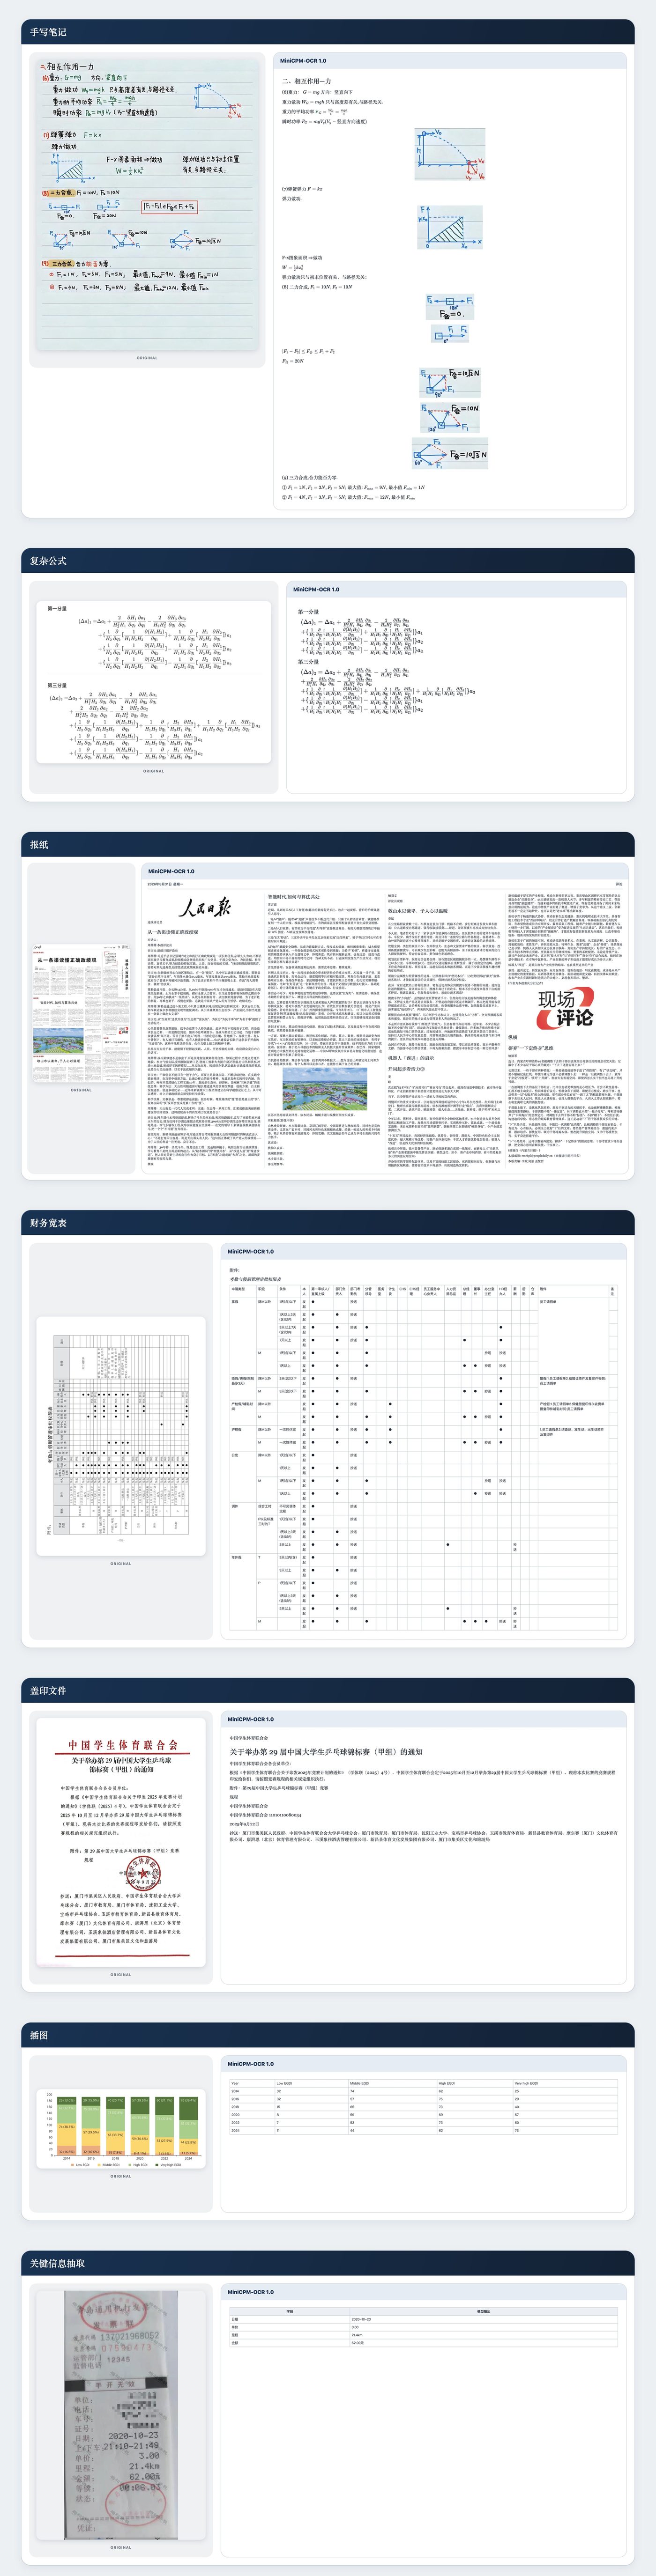
中文文档解析示例,手写笔记、复杂公式、报纸、票据与盖章件
这条路上值得记的有三点。
第一,有了质量分,全量人工复核可以变成只复核可疑块。项目画了法律文书、财务票据、复杂文档三类在不同免复核率下的准确率曲线,但阈值要先拿你自己场景的一小批数据试出来,别照抄。
第二,全面不等于慢。1.0 在 Real5-OmniDocBench 上拿到 93.68,OCRBench v2 得 54.7;配合 DSpark 解码加速,端到端效率提升 55%,吞吐大约 1.2 页每秒,是 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍。
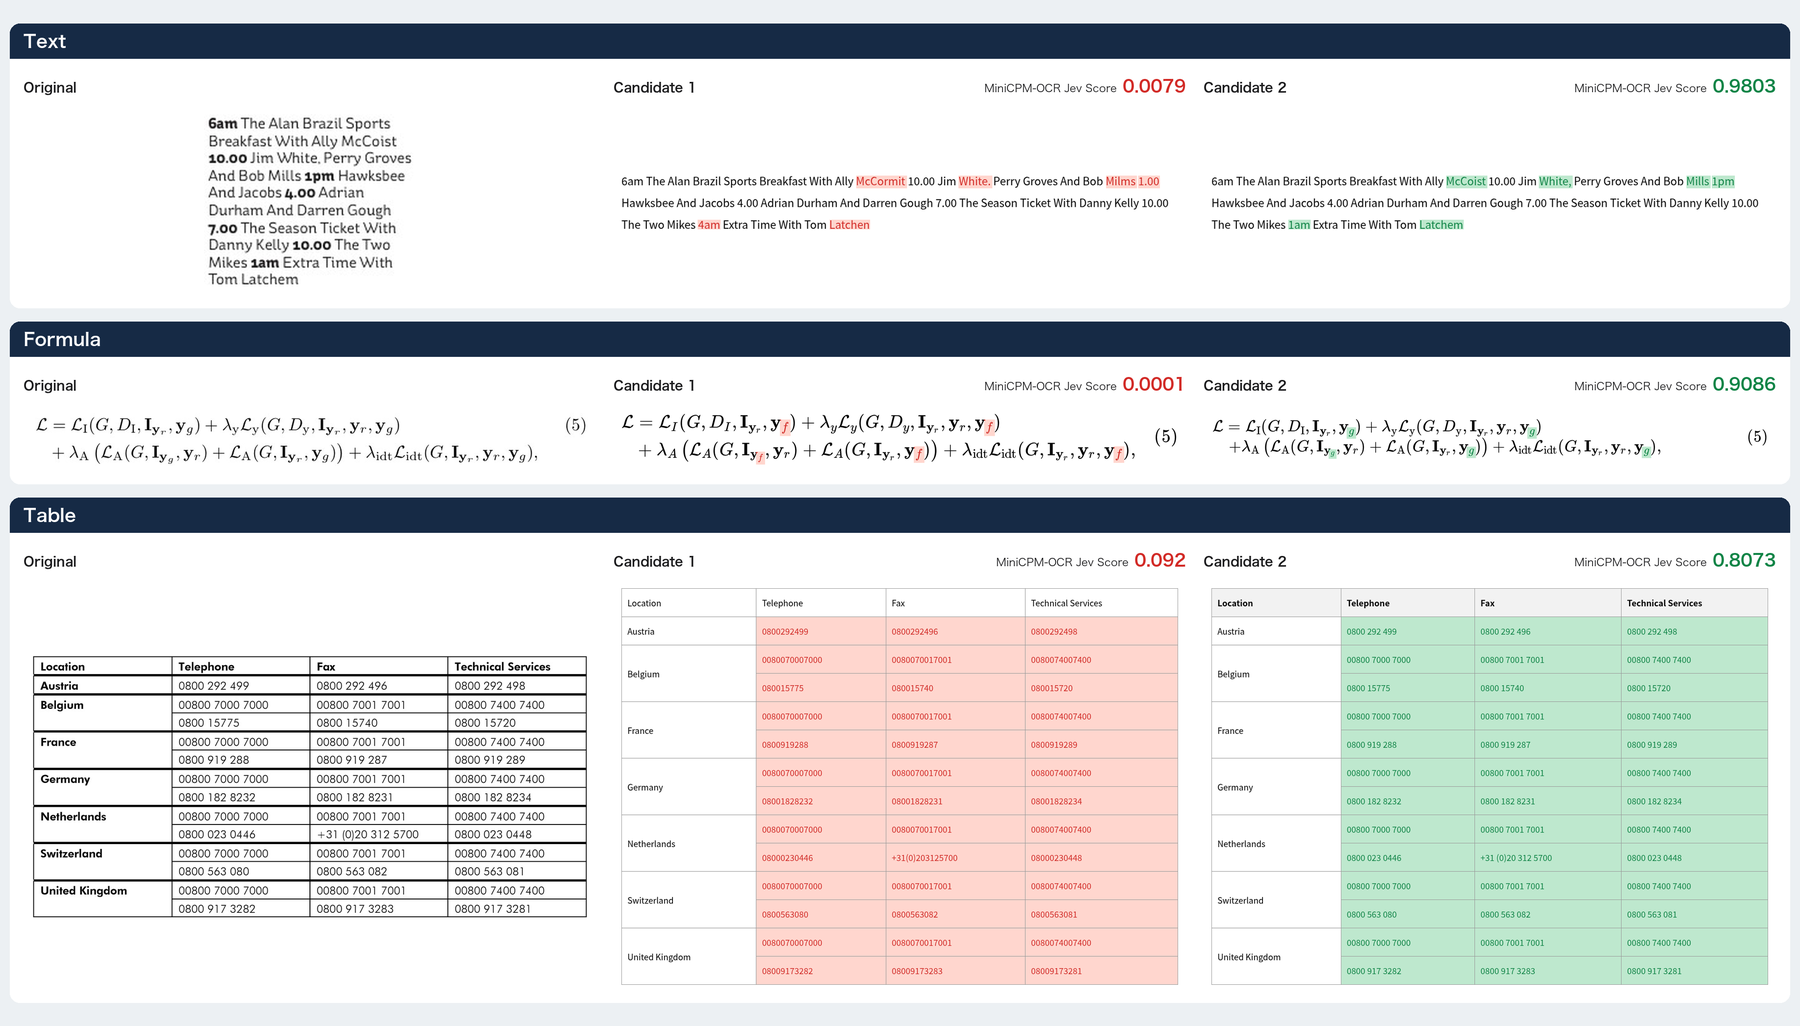
Jev 给文本、公式、表格分别打分,可疑处被点出来
第三,落地路径是现成的。vLLM、SGLang、llama.cpp、Ollama 在发布当天就支持,另有 pip 包 minicpm-ocr 和一整套 API;权重在 HuggingFace 和 ModelScope 都有,国内拉 ModelScope 更稳。不想先折腾环境,可以直接用在线体验平台传一张图看效果。
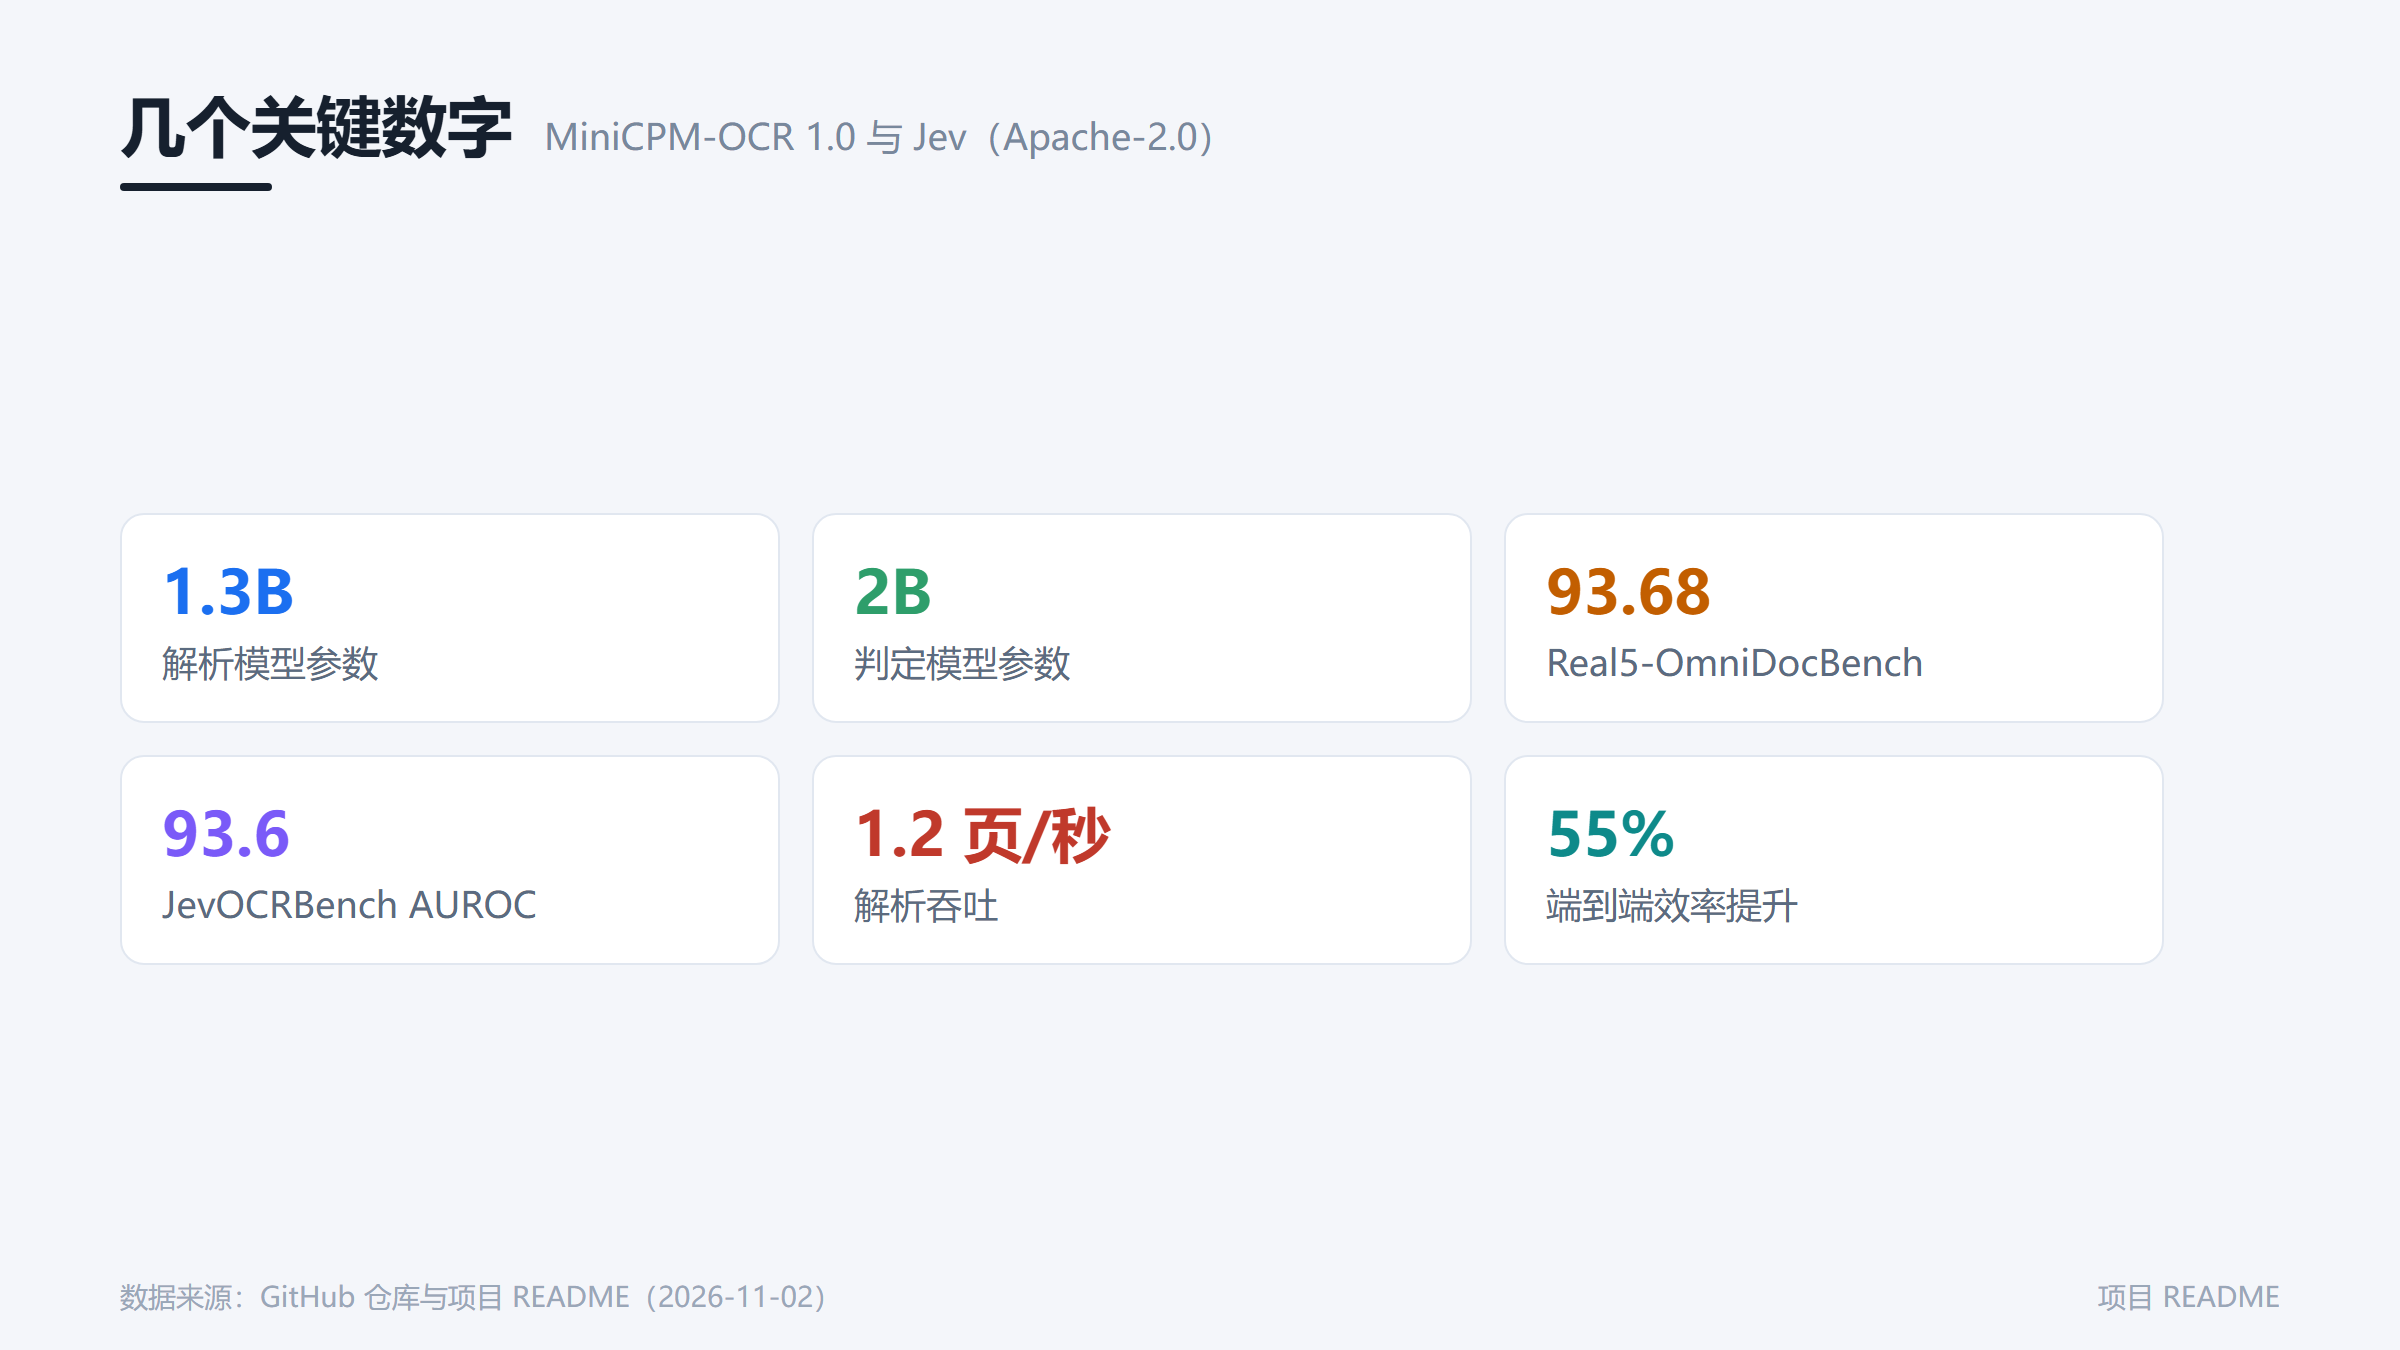
几个关键数字:1.3B、2B、93.68、93.6、1.2 页每秒
需要说明的是,它擅长的是扫描件、拍照、弯曲页面、倾斜和翻拍这类难搞的输入,本地部署要有一张跑得动 1.3B 模型的显卡;只是想试效果,先用在线体验平台更省事。也别指望它救得回本来就糊掉的老扫描件——判分模型能告诉你哪里不可信,但补不回已经丢失的信息。
你平时最想把哪类文档交给 OCR?票据、合同,还是孩子手写的作业?