把整台电脑都拉来跑大模型:8GB笔记本也能每秒近百token
家里那台吃灰的游戏本,显卡只有 8GB 显存,能跑得动 350 亿参数的大模型吗?答案可能让你意外——最近这个叫 PolyStrata 的开源项目,让一张笔记本显卡配合 CPU 和内存,把 Qwen3.6-35B-A3B 跑出了**每秒 94–100 个 token** 的写入速度,读提示词更是冲到 1300+ token/s,比云端同款还快好几倍。
PolyStrata 是 Strata 引擎的一个 fork,作者把它扩展到支持更多混合专家(MoE)模型:Qwen3.8-Flash-Next、GLM 5.3 Flash、DeepSeek V4 Flash、LFM2.5、Qwen3.6、Ornith 1.5、Gemma 4、Tiel Coder、MiniCPM-V。它的核心思路很巧:MoE 模型每生成一个 token 只激活少数几个专家,所以没必要把整个模型塞进显存。PolyStrata 把最常用的专家放在显卡上,其余专家由 CPU 从 GGUF 映射文件里算,必要时连固态硬盘都分担一层,再用缓存和“先猜 token”来加速——整台电脑的显卡、CPU、内存、SSD 一起给推理打工。
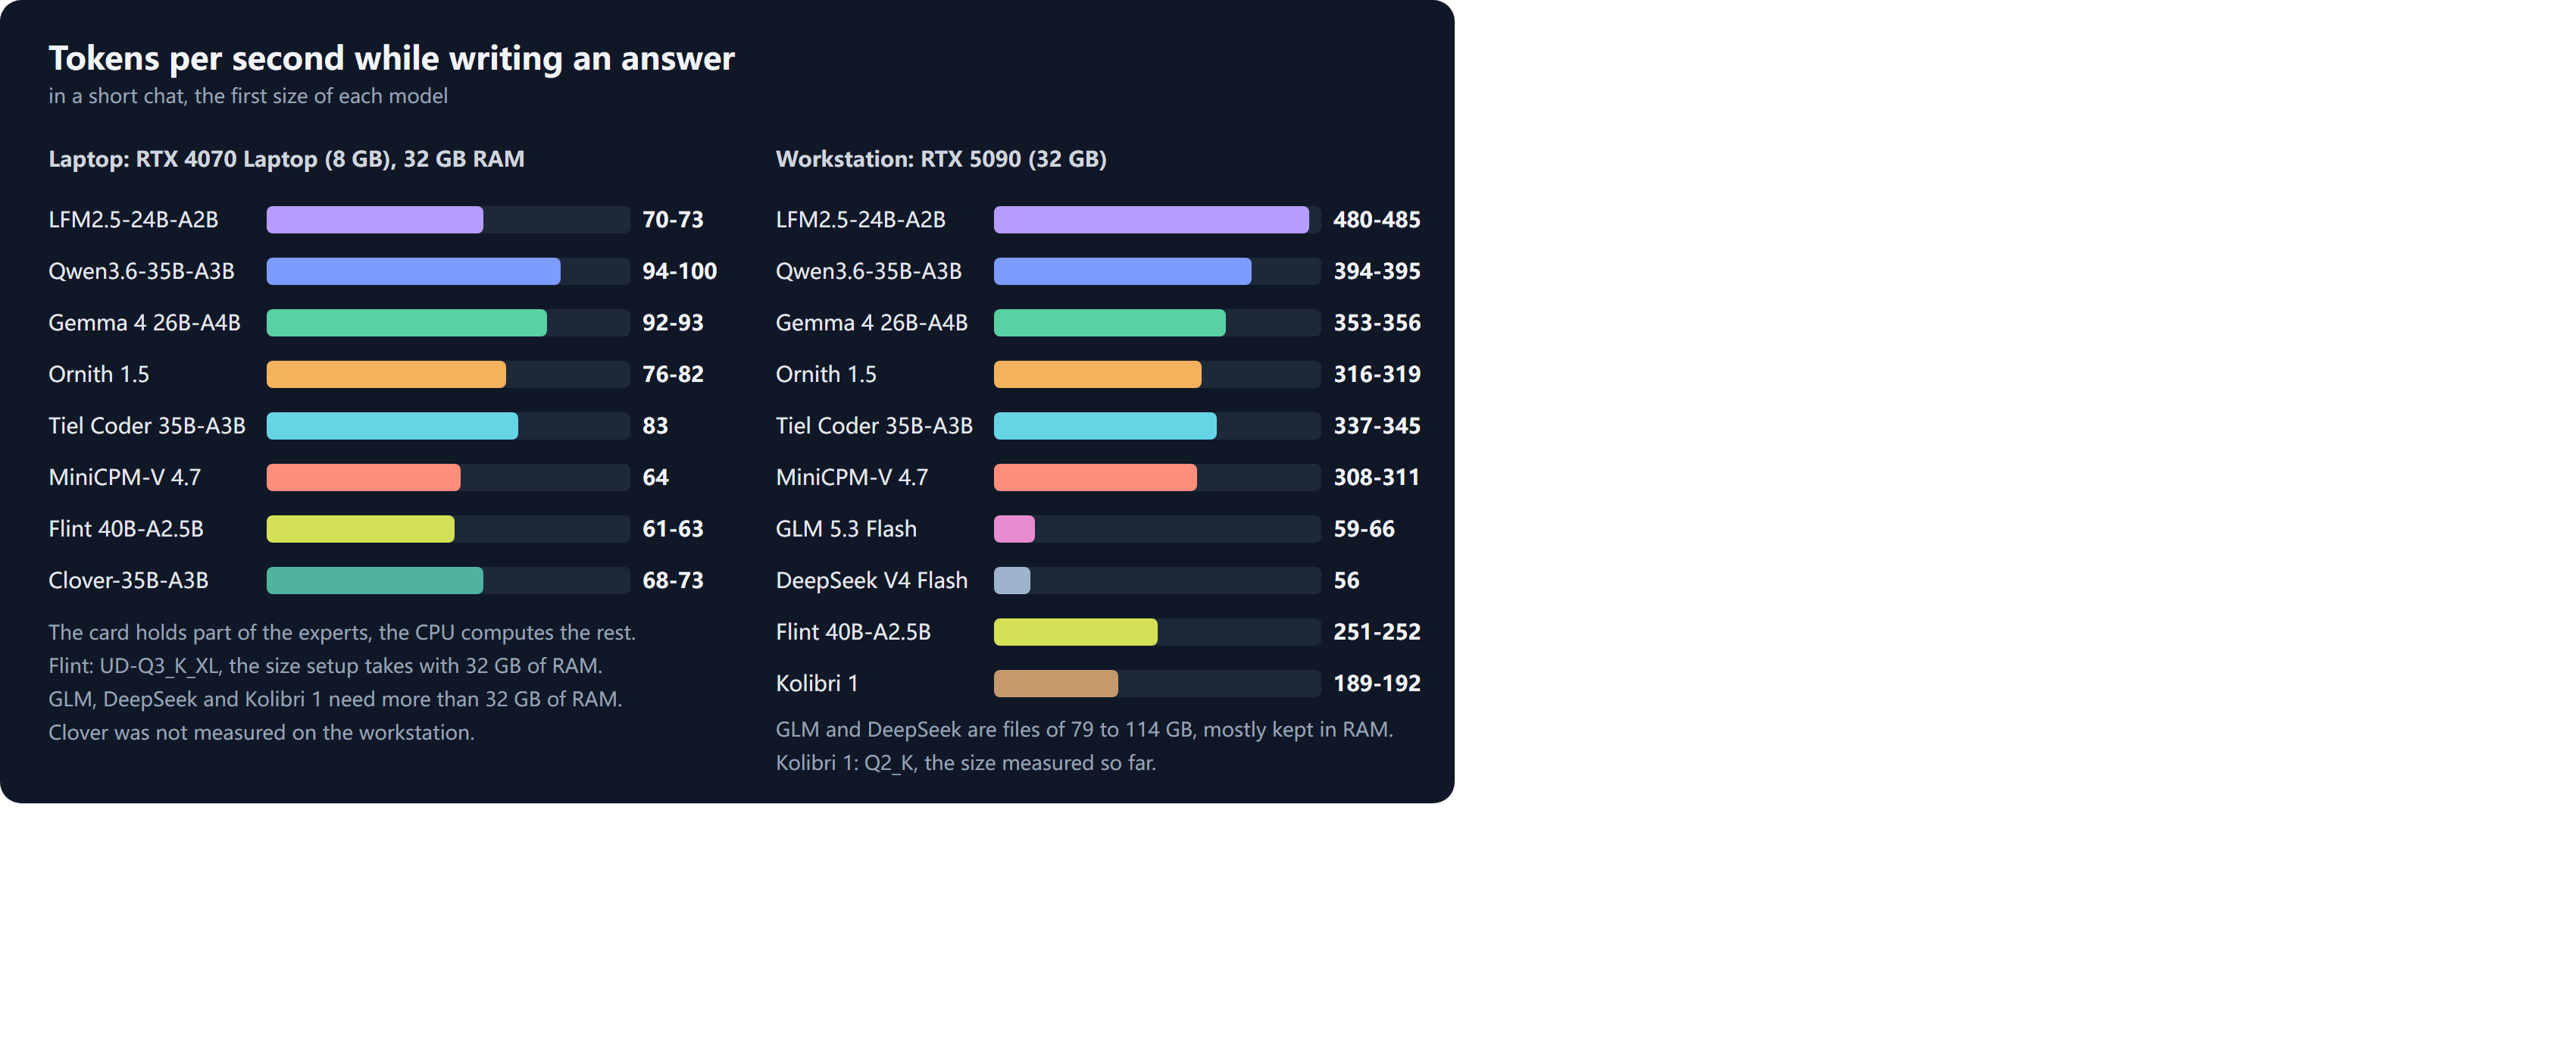
PolyStrata 在笔记本 RTX 4070(8GB) 与工作站 RTX 5090(32GB) 上的 tokens/s 速度对比图
实测数据相当亮眼。在笔记本 RTX 4070(8GB)+ 32GB 内存上,Qwen3.6-35B-A3B 的 UD-Q3_K_M 量化能写 73–75 token/s、读 1390 token/s,UD-Q2_K_XL 更是写到 91 token/s;Gemma 4 26B-A4B 也稳定在 67–87 token/s 区间。换算一下,一个 token 大约四分之三个词,60 token/s 已经比人阅读还快。工作站上的 GLM 5.3 Flash(32GB 卡 + 120GB 内存)则把大部分模型文件留在系统内存里跑。
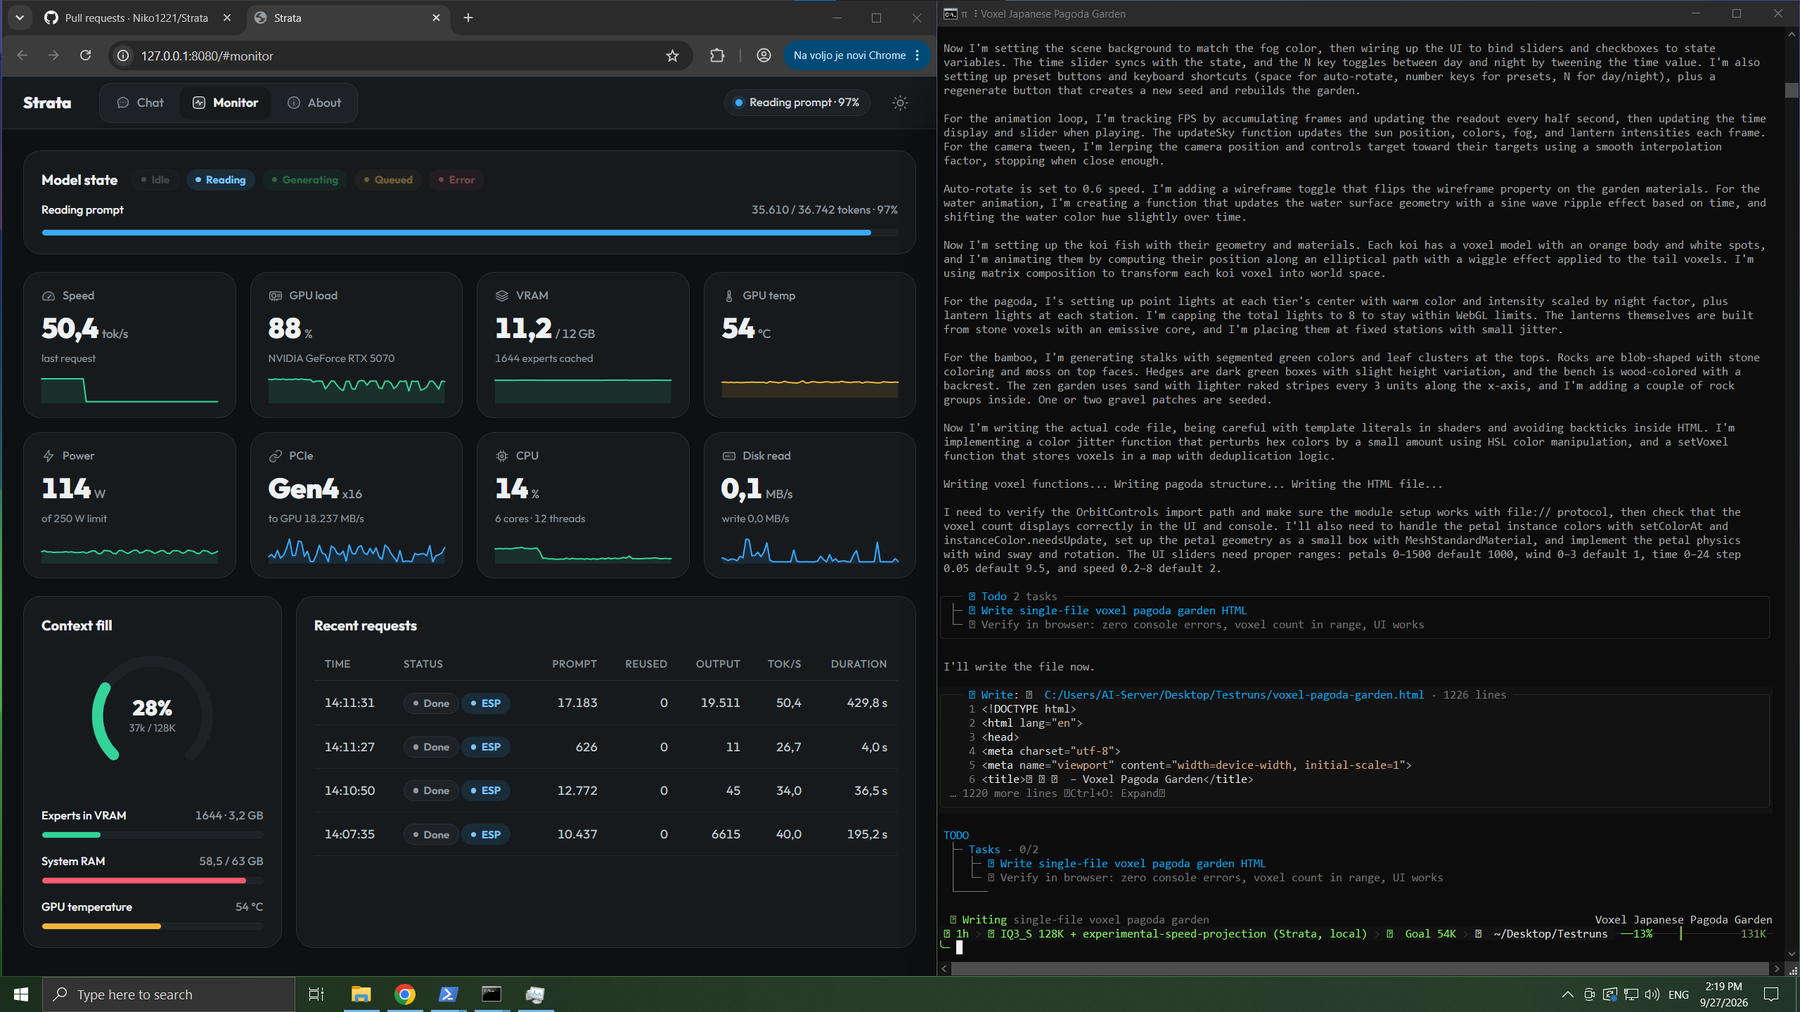
PolyStrata 的网页 Monitor 界面,实时显示模型与 GPU/CPU/RAM 占用
对 coding agent 尤其友好:它提供一个本地 localhost 服务,同时兼容 OpenAI(`http://127.0.0.1:8080/v1`)和 Anthropic(`/v1/messages`,Claude Code 通过 `ANTHROPIC_BASE_URL` 接上)以及 Codex 的 `/v1/responses`,你现有的 agent 不用改代码就能直接调。安装也是一键:Windows 双击 START-HERE.bat,Linux/Mac 跑 `./setup.sh`,脚本会识别你的显卡、问你选哪个模型和量化档、要多少上下文、是否读图,一路回车用推荐值即可。
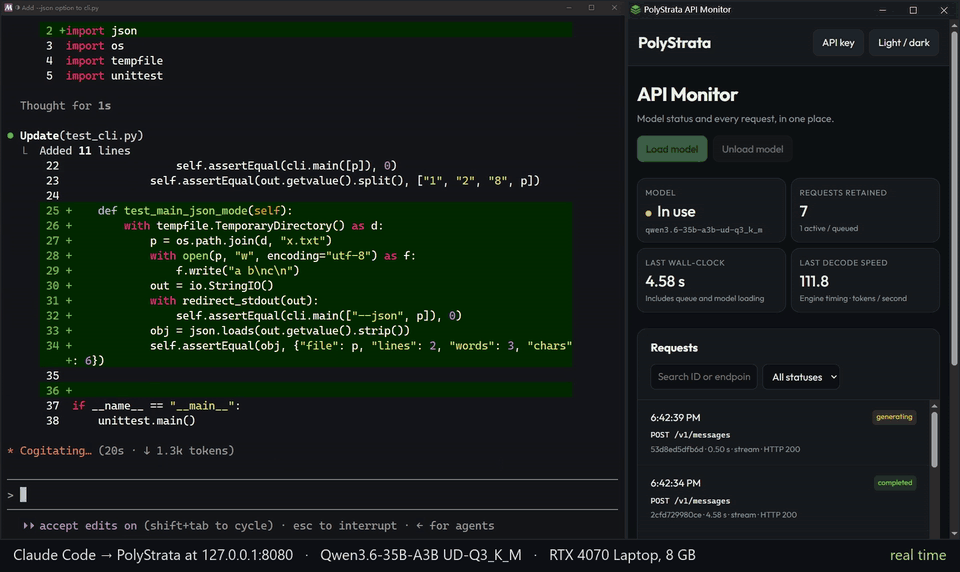
Claude Code 实测——PolyStrata 给小程序加 --token 按钮并写测试跑通
当然边界要说清:目前只支持 NVIDIA 卡,四个新增模型仍属实验性质,Windows 下需要 Visual Studio build tools 和 CUDA 工具包;模型下载动辄 70–114GB,硬件门槛是实的。但如果你手里正好有张游戏显卡,又想让 coding agent 在本地免费、无限速地跑起 350 亿参数模型,PolyStrata 值得一试。你愿意为了“数据不出本机 + 零云端账单”折腾一下本地部署吗?还是宁可多花点钱换省心?