记得那份 PDF 里写过「数据库索引」,却死活想不起文件名;聊天时截过一张报错图,现在只记得图上有行红字;翻遍文件夹,最后靠一个个点开碰运气。系统自带的搜索大多只认文件名,文件名一含日期编号就全废;能把内容也搜了的工具,又常常要先把文件传到云上建索引。
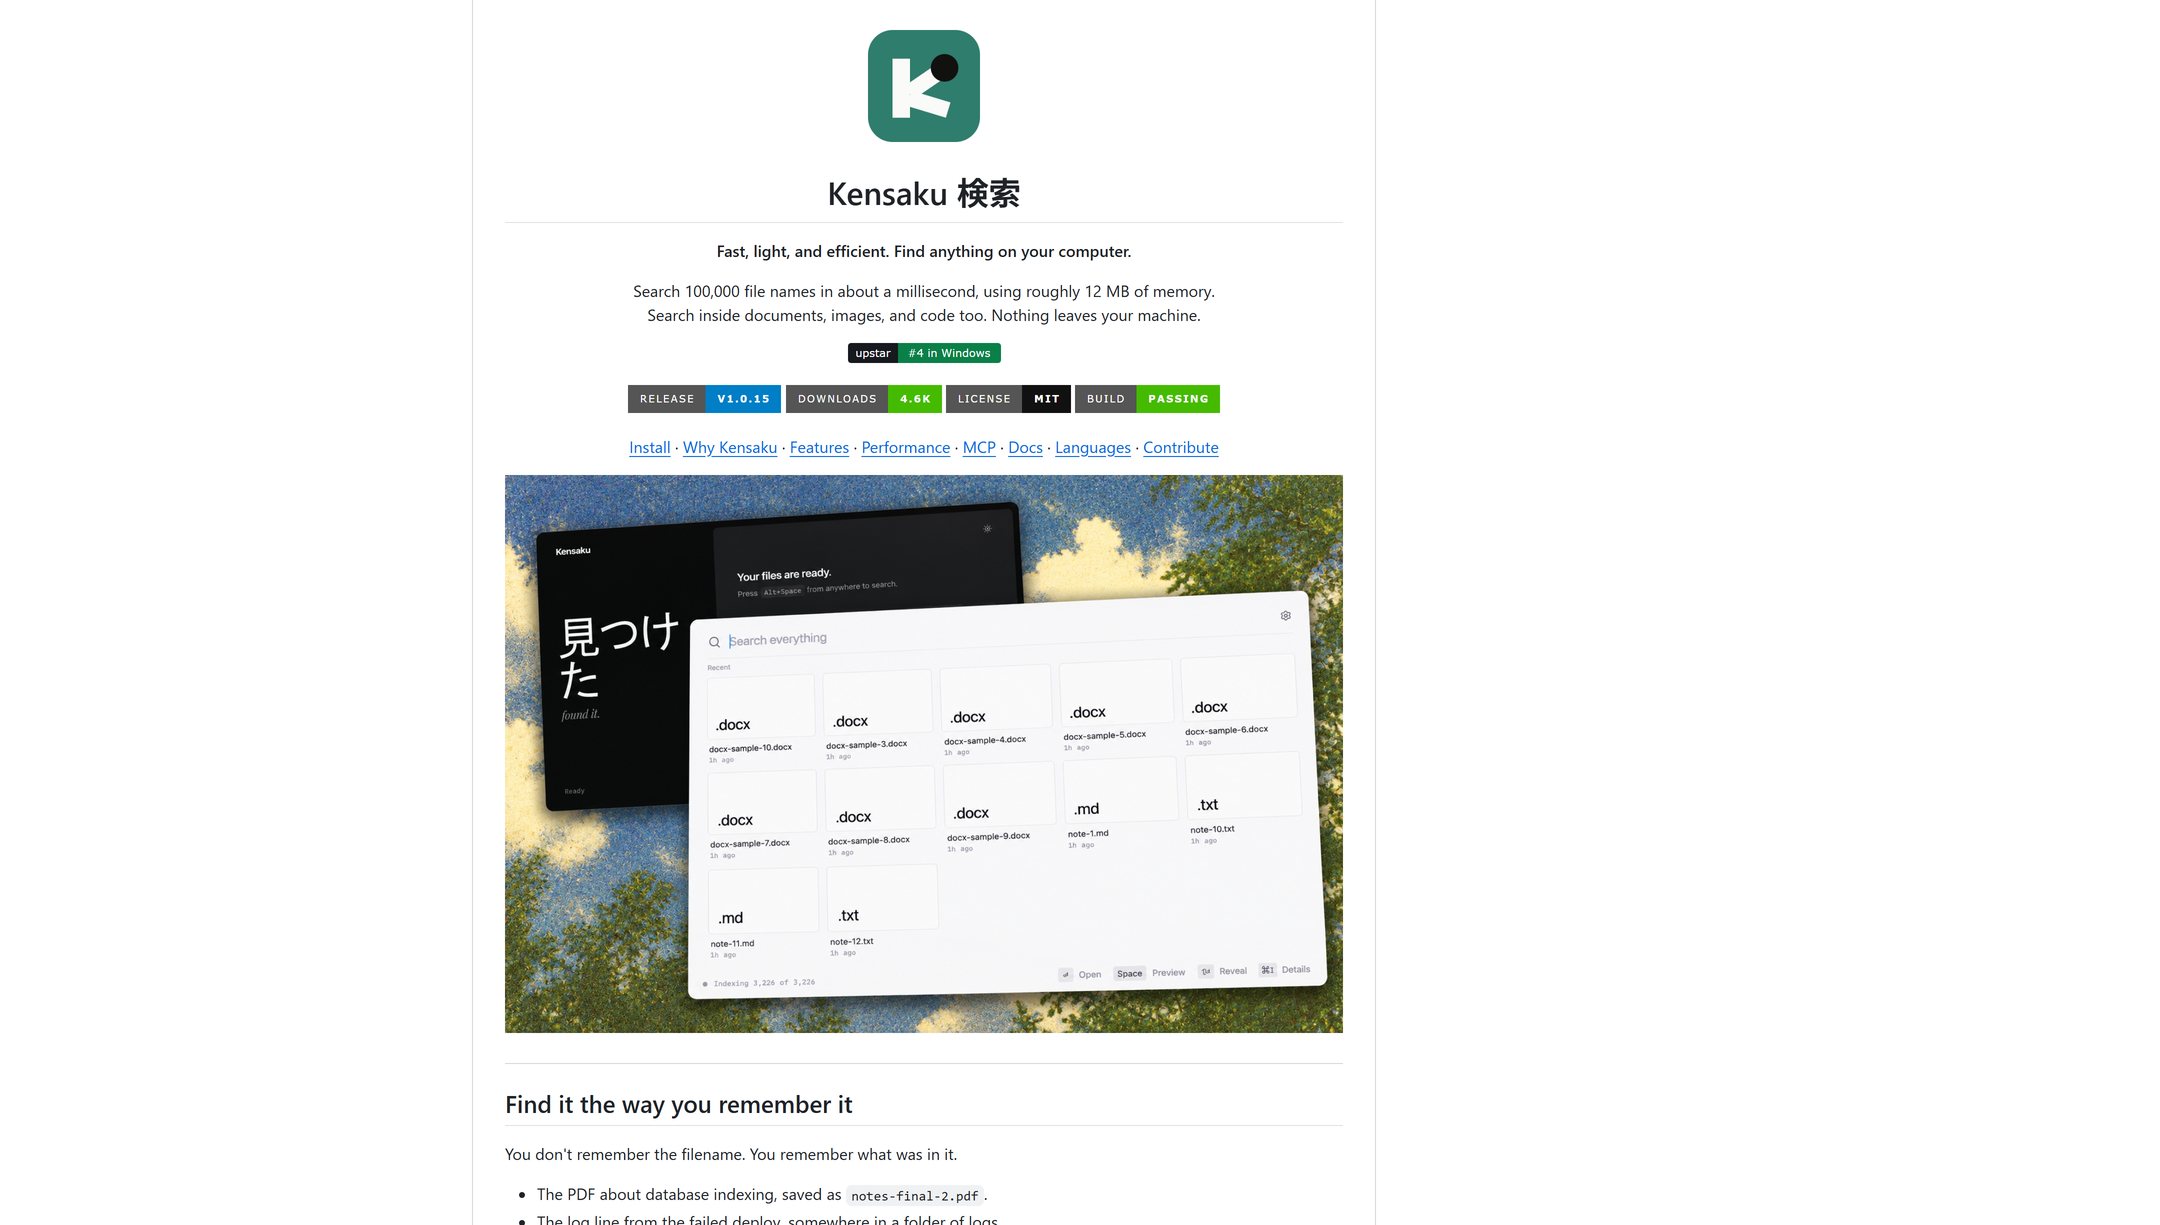
Kensaku 开源仓库首页,说明里写明全本机检索
Kensaku 是 10 月 24 日建仓的开源项目,MIT 协议,Rust 编写,825 颗星,最新版本 v1.0.15。它做的事可以拆成两层:先给文件名建极轻的索引,10 万个文件名检索约 1 毫秒,常驻内存约 12 MB;再往里走一层,把文档正文、代码、甚至截图里的文字一起收进索引,截图靠本机 OCR 识别。项目说明里给的看板示例是 24526 个文件、其中 3173 个能读进内容。按 Alt 加空格从任意界面唤起,输入记住的片段就能找到;记不清原文还能走语义检索,项目也留了 MCP 接口让智能体直接调用。整个过程没有文件出本机这一步。
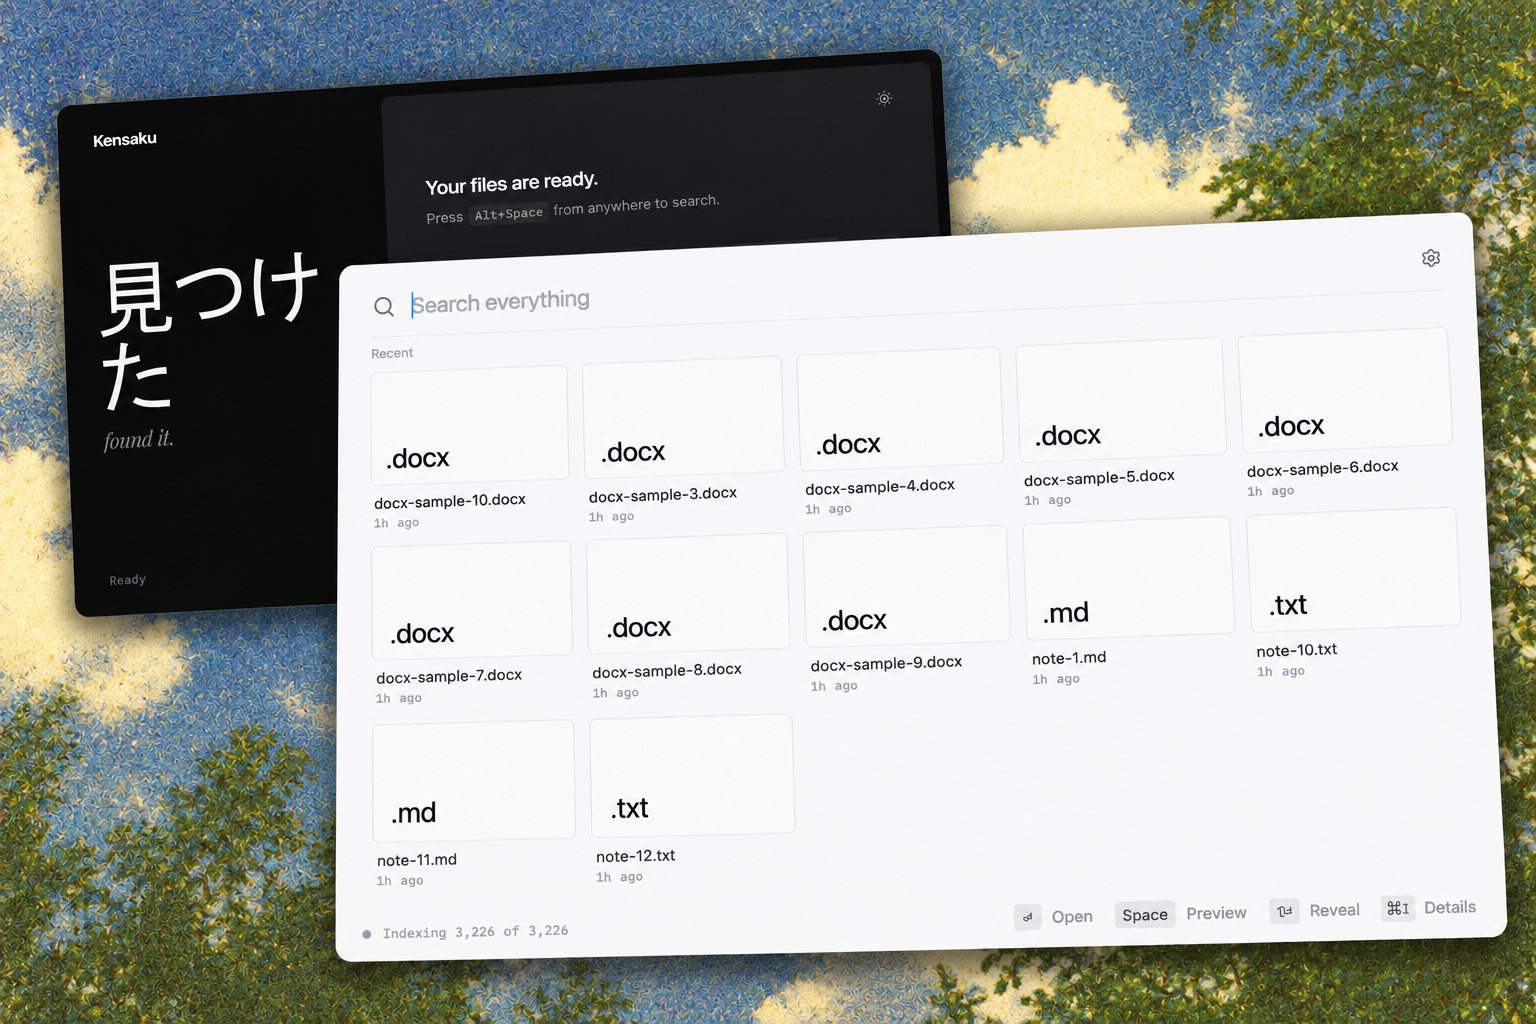
搜索主界面,按文件类型罗列最近索引的内容
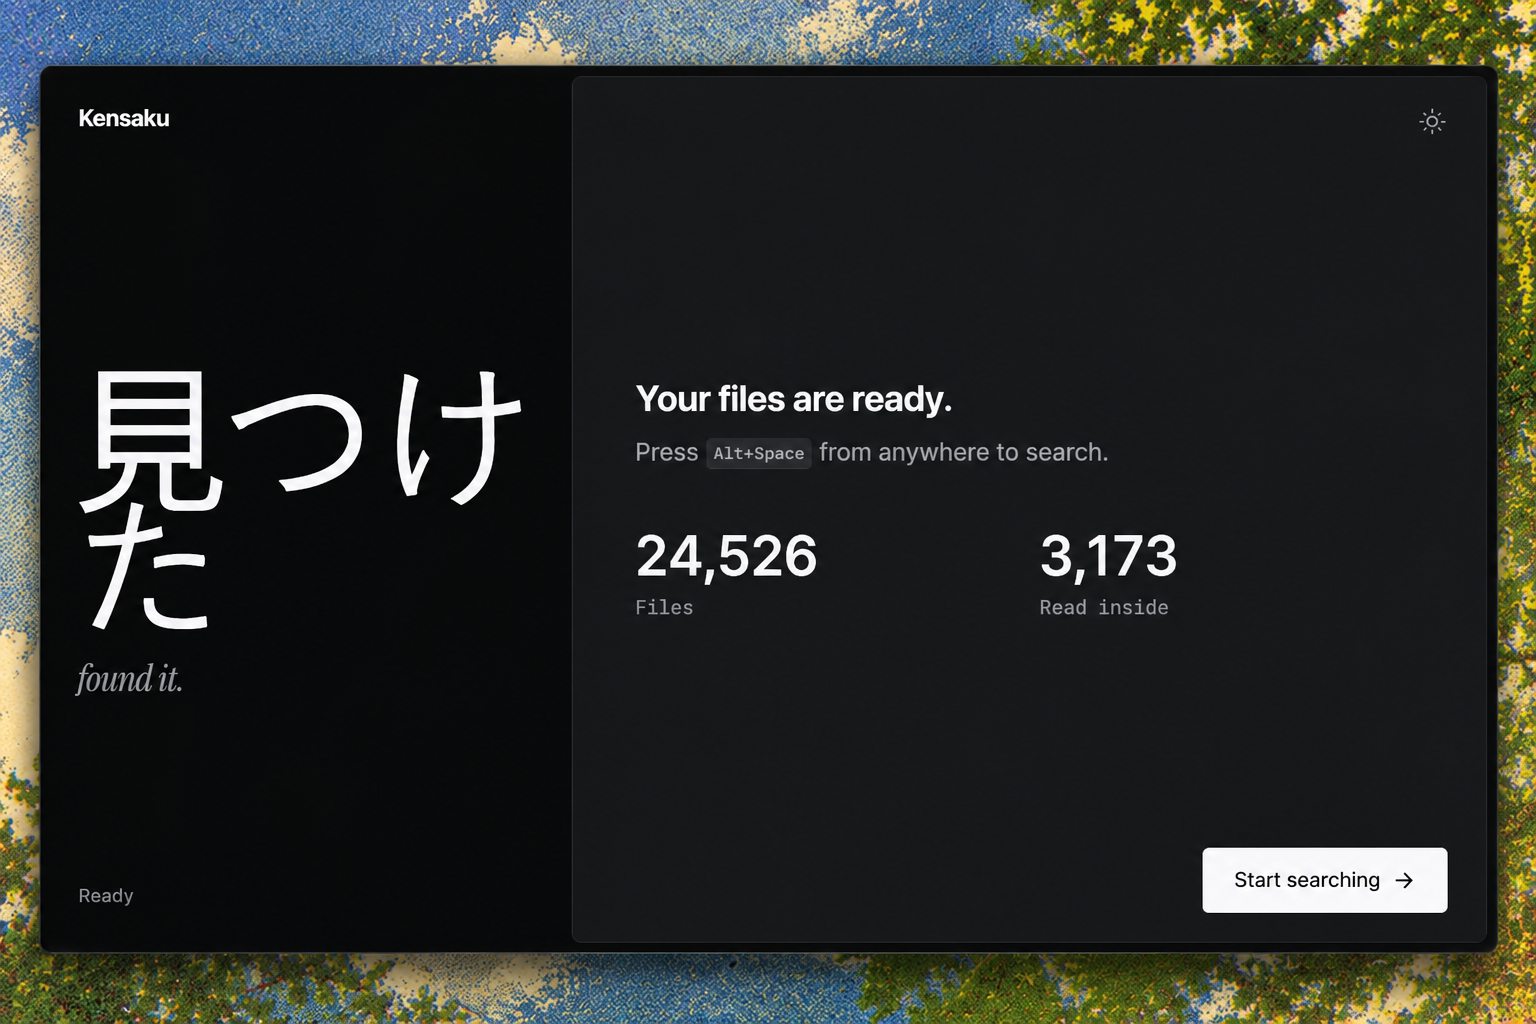
索引看板,显示文件总数与可读内容数
第一,它解决的是记得内容、不记得名字这个具体缺口。文件名搜索再快也只是第一层,真正费时间的是散落在 PDF、笔记、代码注释和截图里的那句话。把 OCR 和语义检索一起塞进本地索引,等于把先想文件名这个前置条件去掉了,找东西的路径从回忆命名规则变成回忆内容本身。
第二,轻是能长期挂着的前提。10 万文件名 1 毫秒、12 MB 内存,这个量级意味着它不必在开着占资源和关了找不着之间二选一;索引在本机生成、本机存放,涉密目录也不用先过一遍审批。对习惯把资料堆在几个大文件夹里的人,这比多几个花哨面板有用。
十万文件一毫秒、12 MB 内存等六项本地检索能力
第三,边界同样清楚。内容索引要预先跑完,新拷进来的文件有短暂空窗;OCR 对手写体、低分辨率截图的识别率不会是满分;语义检索的质量取决于模型与索引配置,别指望第一次就百发百中。它更像一个随叫随到的本机检索层,不负责替代网盘的版本管理,也不负责多人协作。
有个取舍挺实在:为了把内存压到十几 MB,它把力气全花在找得到上,没去做在线同步那一套。
你找旧资料时最常靠什么线索:文件名、大概时间,还是只记得里面一句话?