想把自己那点业务知识灌进一个 7B 小模型,让它成为懂你家产品的助手——这个念头很多人有过,卡住的地方通常不是算法,是环境:装 CUDA、对依赖、跑起来一行 CUDA out of memory,四条小时就没了。
更劝退的是那句"微调至少要一张 A100"。Unsloth 把这句话改掉了。
是什么
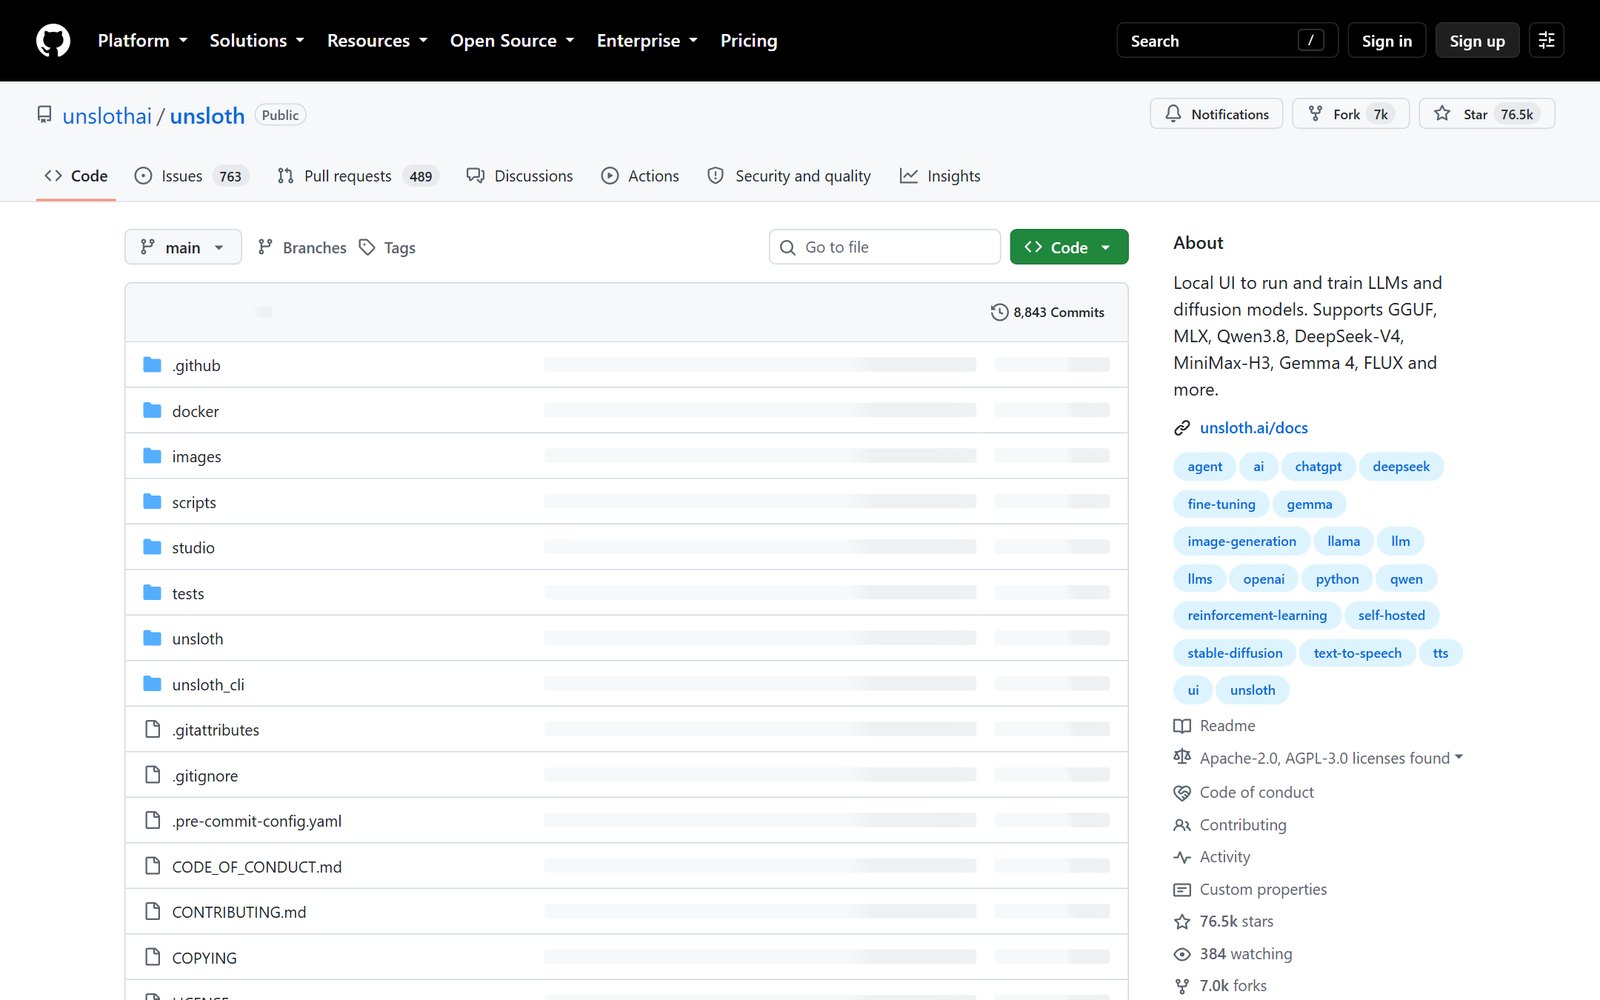
它原本是个做微调加速的 Python 库,现在长成了一个本地大模型工作台:Unsloth Desktop 是桌面应用,Unsloth Studio 是网页界面,Unsloth Core 是纯代码版,三条路通向同一套内核。仓库 7.6 万 Star、6992 Fork,当前版本 v0.1.811-beta,9 月 20 日还有提交,700 多条 Issue 和 480 多条 PR 在流转,维护节奏很快。
能力范围比名字看起来大:文本、图像、视频、语音、向量模型都能下载、运行、微调。它同时支持 GGUF 和 MLX 两种推理格式,官方对 Qwen、DeepSeek、GLM、Gemma、Kimi 这些新模型的适配跟得很快,很多是发布当天就能跑。
核心优势
显存门槛是真的降下来了。官方给的 QLoRA(4 位量化)最低显存对照大概是:3B 要 3.5GB、7B 要 5GB、8B 要 6GB、11B 要 7.5GB、14B 要 8.5GB、27B 要 22GB、32B 要 26GB、70B 要 41GB。翻译一下——一张 8GB 的消费级显卡能微调到 11B 这个级别,12GB 的卡(RTX 3060 12G、5070 这一档)做 14B 还有余量,24GB 的卡能碰 27B。同样这几个数是 16 位 LoRA 的话要翻好几倍,8B 就要 22GB,那才是劝退线原形。官方的口径是"训练快 2 倍、显存少 70%",这个数字来自他们自己的基准,没有公开基线,得打折看,但门槛下降这件事是做实的。
不用写代码。下载模型、开聊、建数据集、开训、导出,全在图形界面里点完。数据配方那块能从 PDF、CSV、DOCX 直接生成训练集,不用先写一套清洗脚本。对不做算法的人来说,这一步省掉的不是时间,是放弃的概率。
能接住编码 Agent,这是它比较妙的一手。一条 unsloth start claude 就把本地模型挂给了编码助手,同样的命令支持 Codex、OpenCode、Hermes Agent、DeepSeek Harness 这些。它同时暴露一个 OpenAI 兼容接口,也就是说现有那些只认 OpenAI 格式的脚本和 SDK 能直接连过来。想把本地模型当成编码栈的后端,这条路是通的。
顺带把图像视频也管了。扩散模型能本地运行和 LoRA 微调,视频模型(Wan、LTX 这类)也在支持列表里,语音合成和向量模型同样覆盖。它不是只服务文本。
私有知识库加联网搜索。它内置了搜索和深度研究流程,模型边想边查,生成带引用的报告。检索增强也做在里面。对不想把资料丢给外部服务的场景,这一块比单跑一个模型有用得多,模型还能把 Bash 和 Python 丢进沙箱执行,跑代码、验结果。
平台覆盖得比预期宽。Windows 原生跑,不用 WSL;macOS 走 MLX;Linux 和 WSL 完整支持。显卡上 NVIDIA、AMD、Intel 和三家的纯 CPU 路径都有,还支持 Vulkan 后端和多卡。想在外面看训练进度,它能通过 Cloudflare 隧道把本地模型挂到 https,手机上也能连。
怎么用
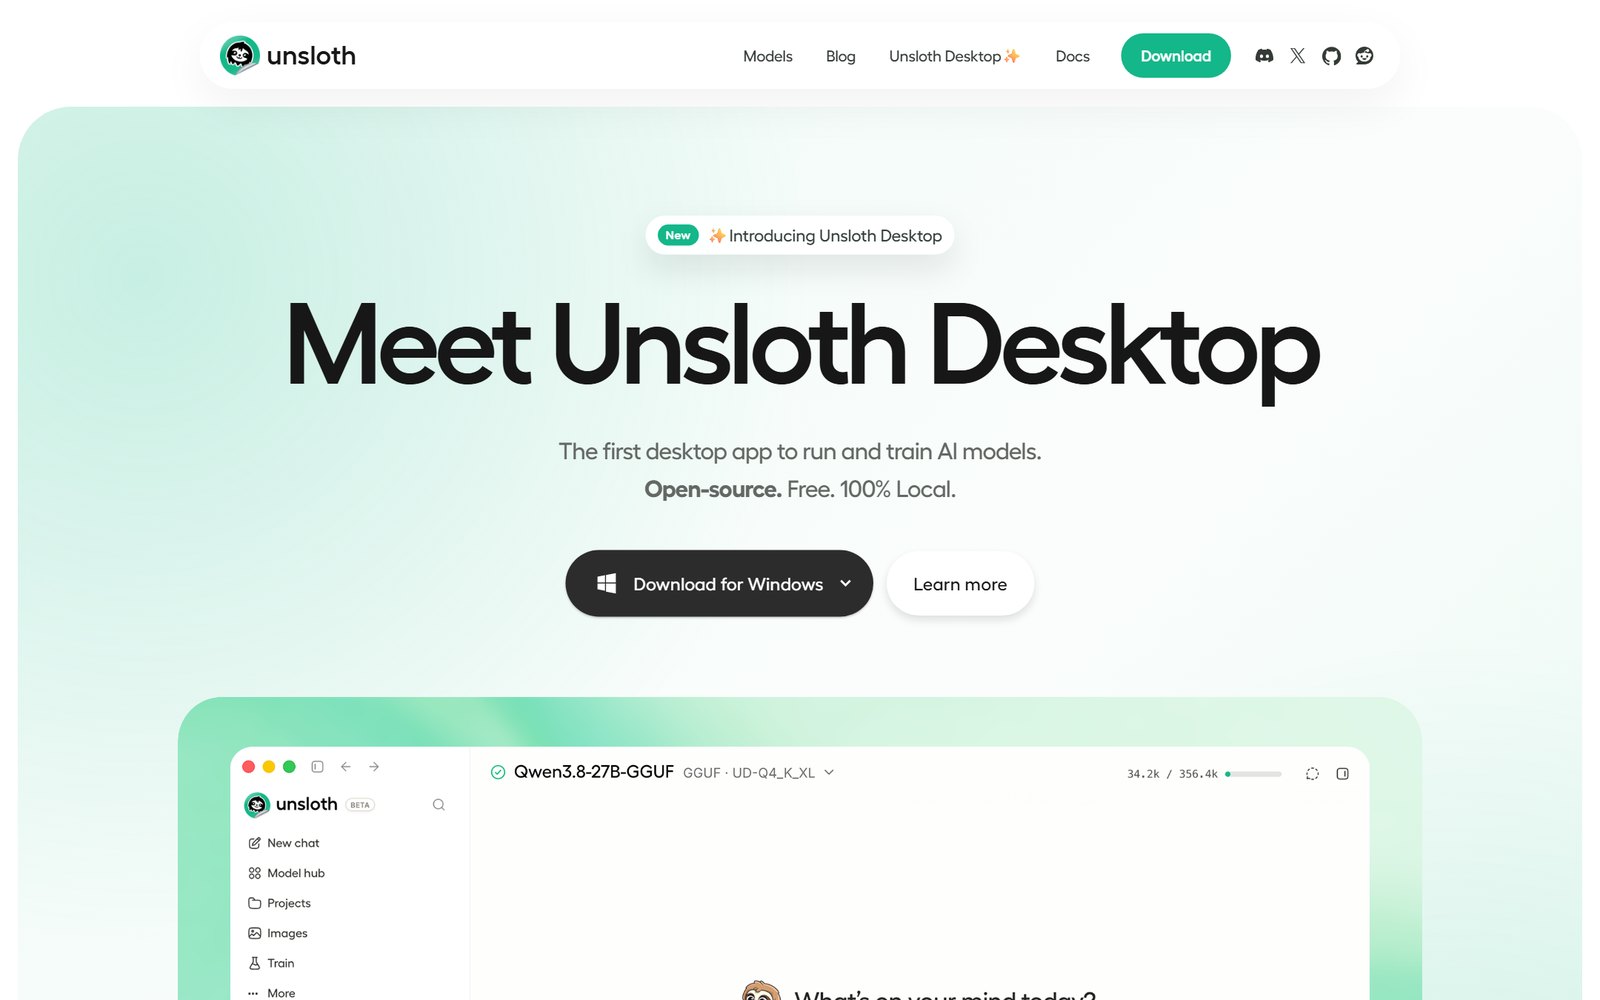
最省事的是下载桌面安装包,Windows、macOS、Linux、Ubuntu ARM64 都有,Windows 包大约 42MB。也可以走命令:macOS、Linux、WSL 上跑 curl -fsSL https://unsloth.ai/install.sh | sh,Windows 上用 irm https://unsloth.ai/install.ps1 | iex。喜欢容器就直接拉 unsloth/unsloth 镜像。
装完是一个跑在 8888 端口的本地网页界面。环境要求里唯一容易踩的是 Python 版本,需要 3.11 起步、低于 3.14。
不是没有槽点
那张显存表是"最短线",不是"安全线"。这是最需要说清楚的一点。项目里有个真实案例:RTX 4070 Ti 12GB 的卡,用 4 位 QLoRA 训一个 2B 的小模型、上下文设成 4096,照样 OOM——报的是想申请 7.58GB、但只剩 4.07GB 可用。同一张卡、同一个模型、同一套参数,换成扁平的 prompt/response 格式数据集能跑几千行,换成嵌套 role/content 的对话格式数据集,250 行就炸。原因是对话模板展开之后,序列占的内存会明显膨胀。所以出 OOM 时的第一处置不是换更小的模型,是把 batch size 从默认的 4 降到 1 或 2,顺手把上下文长度砍到数据实际需要的长度。默认参数(batch 4 配梯度累积 8)是给大卡准备的。
纯 CPU 只能聊天,训不了。文档写得很明确:CPU 环境下只剩聊天和数据配方两块,训练没有,导出功能标的是"即将上线"而不是"已支持"。想练手还是得有张显卡。
它不解决推理速度。如果你的需求纯粹是离线问答,不涉及微调,那它的优势发挥不出来——同样的 7B 量化模型,几个工具跑起来的显存占用和速度差别不大。日常离线聊天,Ollama 和 LM Studio 反而更成熟、模型库更全。
别急着卸载现有的工具。这三者更多是互补关系,不是替代关系。你完全可以让 Ollama 负责日常问答、让 Unsloth 负责训练和调优。
模型缓存默认放系统盘。一个模型动不动十几 GB,几轮下来 C 盘就满了。安装后第一件事应该是把模型保存路径改到数据盘。
版本号还带 beta。v0.1.811-beta 这个版本号说明项目还在快速迭代期,接口和界面会变,通用 GGUF 模型的兼容性也还在完善。拿来干活没问题,但别指望一年后文档和截图还对得上。
跟同类怎么比
对 Ollama。Ollama 最简洁,但最大的门槛是命令行——不少人在黑窗口那一步就退了。它没有图形化的训练能力。Unsloth 门槛比它低在界面,高在参数多。
对 LM Studio。LM Studio 最难被超越的是"点三下就能跑通模型"的顺畅度,模型生态也宽,可以直接导入任意 GGUF。它的短板是微调不是主场。论上手速度 LM Studio 更快,论定制能力 Unsloth 更完整。
对 HuggingFace 原生微调流程。原生流程最灵活,什么都能改,代价是环境、显存优化、训练脚本都得自己搭。Unsloth 的定位就是把这一段包起来,用它的内核换你的时间。要深度定制的话,它提供 Core 代码版,不至于完全被界面锁死。
对云上租卡。租 A100 按小时付费,显存随便用,但数据要上传、账要一直付。41GB 显存才能微调 70B,那是双卡 24GB 或者按小时租的生意;而绝大多数人的真实需求是 7B 到 14B 这一个区间,本机一张卡就够。想清楚自己落在哪一边,再决定买卡还是租卡。
一句话:有显卡、想把模型调成自己那个样子,Unsloth 是目前门槛最低的一条路;只想离线聊天,先别换。
项目地址:https://github.com/unslothai/unsloth
官方文档:https://unsloth.ai/docs
标签:#Unsloth #本地大模型 #模型微调 #LoRA #QLoRA #开源工具
你那台机器的显存是多少?如果只能选一样,你更想本地跑模型还是本地训模型?