做知识库或者 RAG 的人,大概都经历过这个瞬间:把一个 PDF 丢给大模型,问它第三张表里那个金额是多少,它答得特别自信,数字完全是编的。你回头打开原文件一看就明白了——那张表在解析器眼里早就散架了,几列数字被按阅读顺序拉成一串,行列关系全丢了。
这事儿的锅通常不在模型,在喂进去的格式。而 MarkItDown 就是专门处理这一段的:它把乱七八糟的文件统一洗成 Markdown,再交给你后面的大模型。
是什么
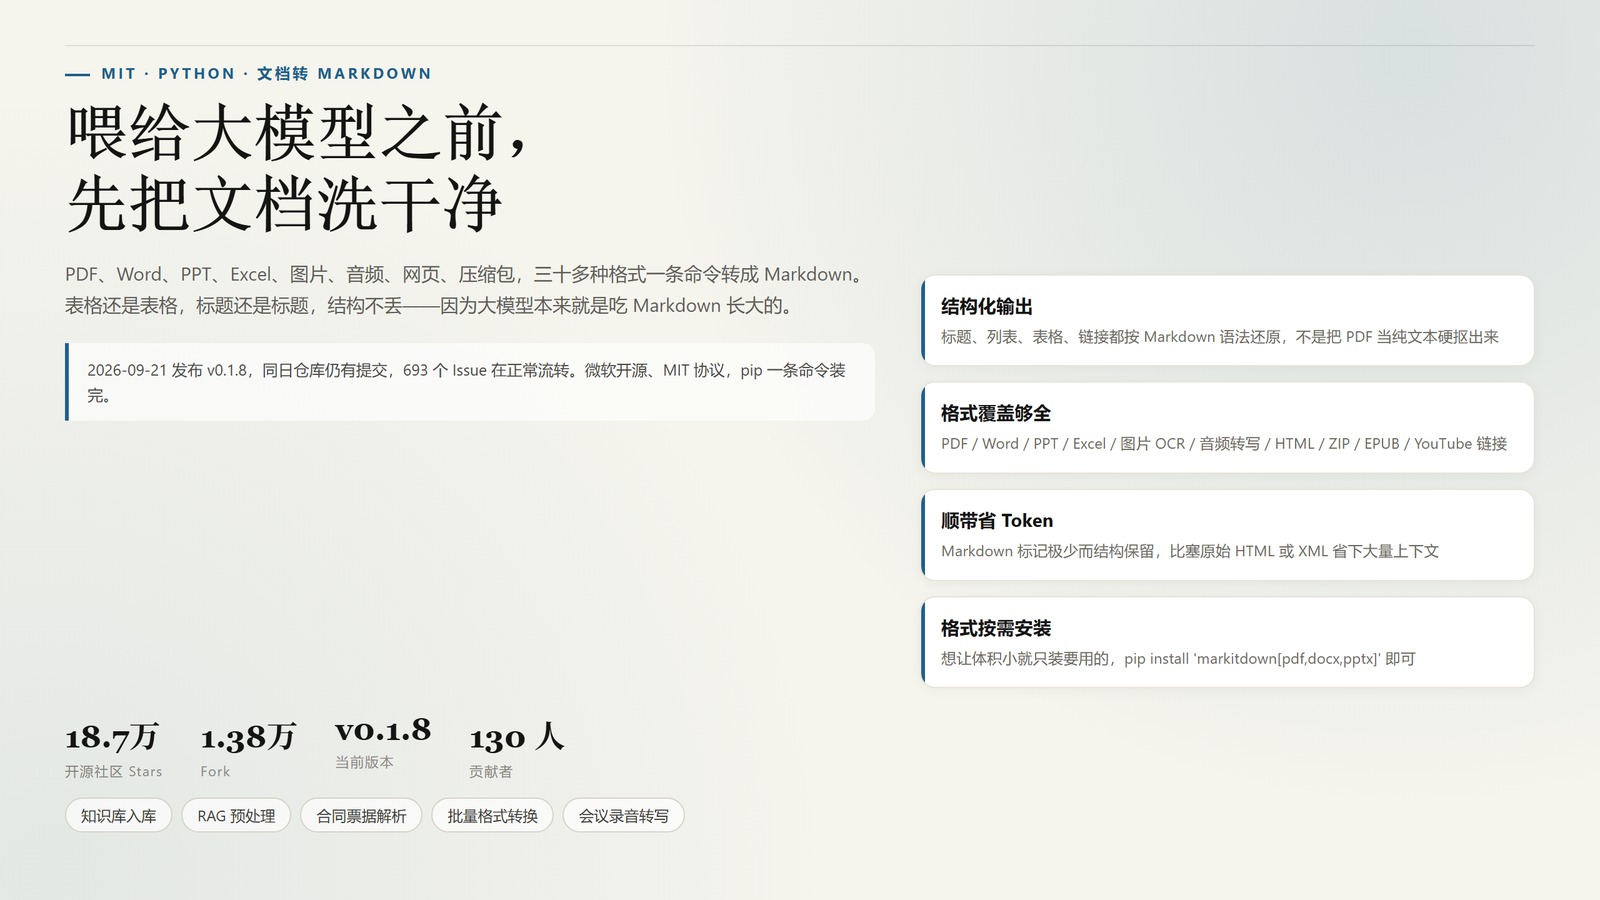
MarkItDown 是微软开源的 Python 工具,干的事情只有一件:把文件转成 Markdown。仓库当前 186,639 个 Star、13,761 个 Fork,130 位贡献者,MIT 协议,最新版本 v0.1.8 发布于 2026 年 9 月 21 日,当天仓库还有提交。
能转的格式相当杂:PDF、PowerPoint、Word、Excel(含老的 xls)、图片(读 EXIF 元数据加 OCR)、音频(元数据加语音转写)、HTML、CSV / JSON / XML 这类纯文本格式、ZIP 压缩包(会挨个遍历里面的文件)、EPUB,还有 YouTube 链接。
作者在 README 里解释了为什么选 Markdown 当中间格式,理由挺实在:主流大模型本身就"会说"Markdown,GPT-4o 这类模型不用你提示,回答的时候就自动带 Markdown 语法。这说明它们在训练数据里见过大量 Markdown,理解起来没障碍。顺带的好处是 Markdown 标记极少,同样一份文档,塞 Markdown 比塞原始 HTML 或 XML 省下不少上下文。
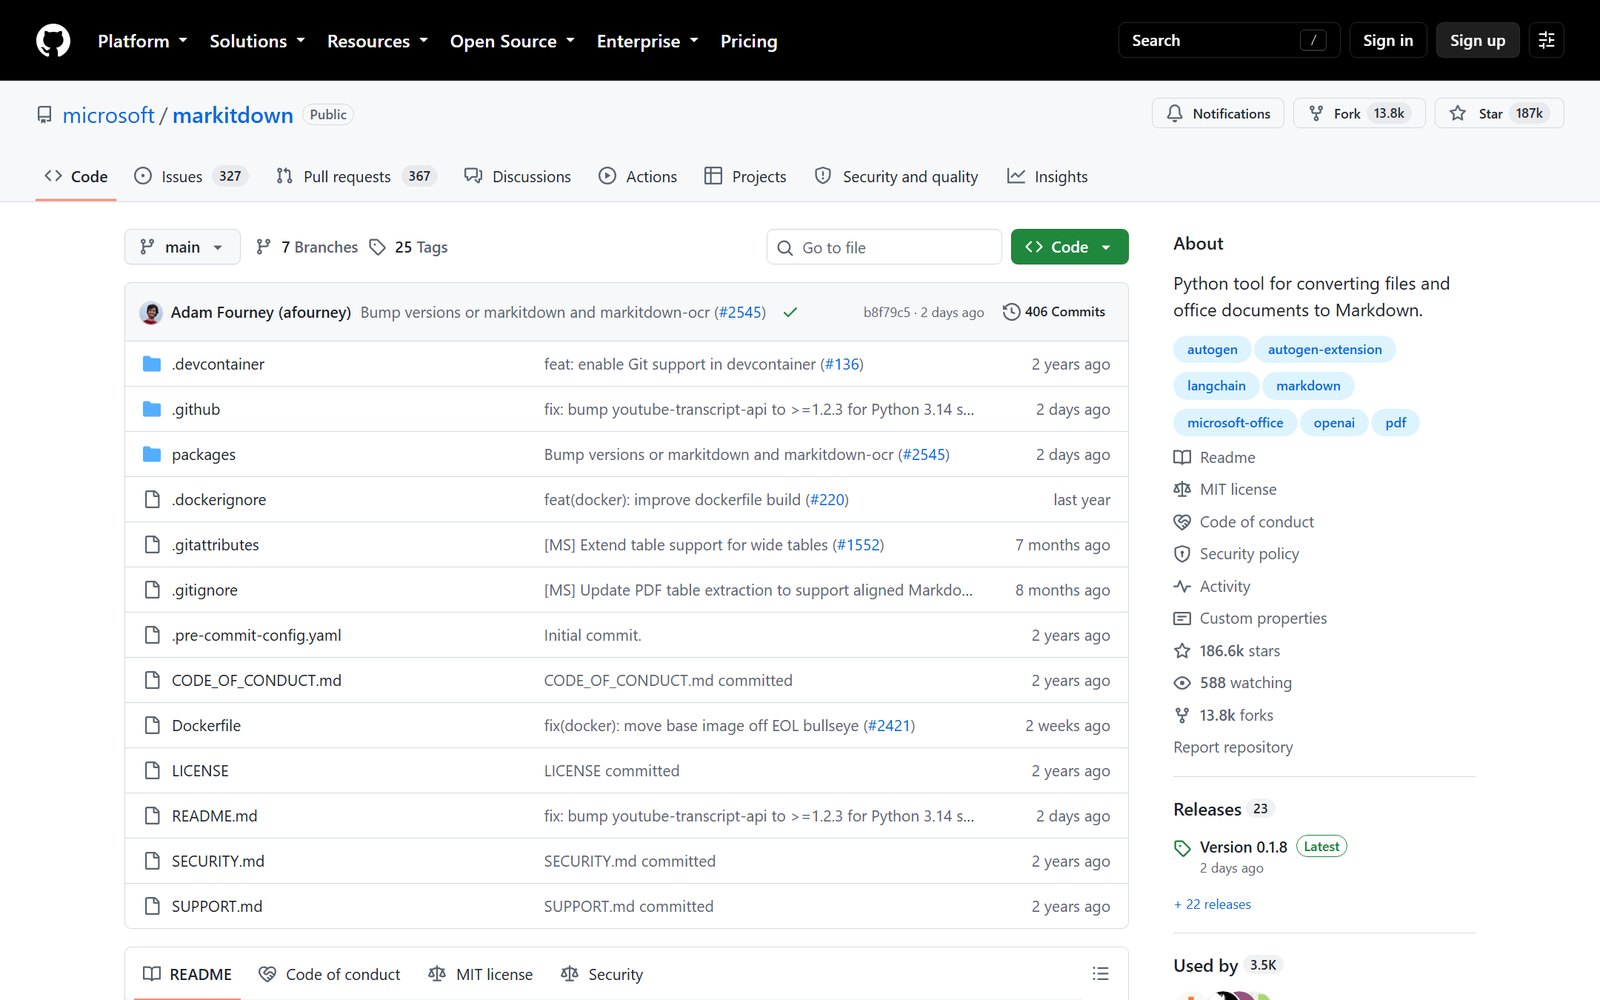
MarkItDown 的仓库首页。项目结构很直白,packages 目录下按功能拆分,最近一次提交在两天前
它到底好用在哪儿
第一是结构保住了。它输出的不是把 PDF 当纯文本硬抠出来的东西,标题、列表、表格、链接都按 Markdown 语法还原——该是表格的地方还是表格,该是一级标题的地方就是 #。对后面接 RAG 的切分环节来说,这直接决定了 chunk 切得合不合理。
第二是格式覆盖真的全。多数同类工具要么只管 Office 三件套,要么只管 PDF,它是全都管,连 ZIP 包和 YouTube 链接都算进去了。你有一批来源不一的资料要入库,可以不换工具。
第三是依赖可以按需装。如果你只需要处理 PDF 和 Word,没必要把音频转写那一大坨依赖也拉下来:pip install 'markitdown[pdf,docx]' 就够了。可选项还包括 [pptx]、[xlsx]、[xls]、[outlook]、[az-doc-intel]、[audio-transcription]、[youtube-transcription] 这几档。想省事直接 [all]。
第四是留了插件口子。插件默认关闭,得显式加 --use-plugins 才生效,这个设计挺克制。官方生态里有个 markitdown-ocr,用大模型的视觉能力给 PDF、DOCX、PPTX、XLSX 里的内嵌图片做 OCR,走的就是它原本描述图片用的那套 llm_client / llm_model 参数,不用再额外装一堆机器学习库或者二进制依赖——这点比很多方案干净。
怎么用
装:
pip install 'markitdown[all]'
命令行最短的用法就是把结果重定向到文件:
markitdown report.pdf > report.md
markitdown report.pdf -o report.md
cat report.pdf | markitdown
写进代码里也不长,三行:
from markitdown import MarkItDown

md = MarkItDown(enable_plugins=False)
result = md.convert("test.xlsx")
print(result.markdown)
想让它顺手描述图片内容,把大模型客户端传进去就行:
from markitdown import MarkItDown
from openai import OpenAI

client = OpenAI(max_retries=5)
md = MarkItDown(llm_client=client, llm_model="gpt-4o")
result = md.convert("example.jpg")
print(result.markdown)
注意 llm_model 这条路径目前只覆盖 pptx 和图片文件,PDF 里的图还得靠前面说的 OCR 插件。项目要求 Python 3.10 到 3.14,低于 3.10 别想了。
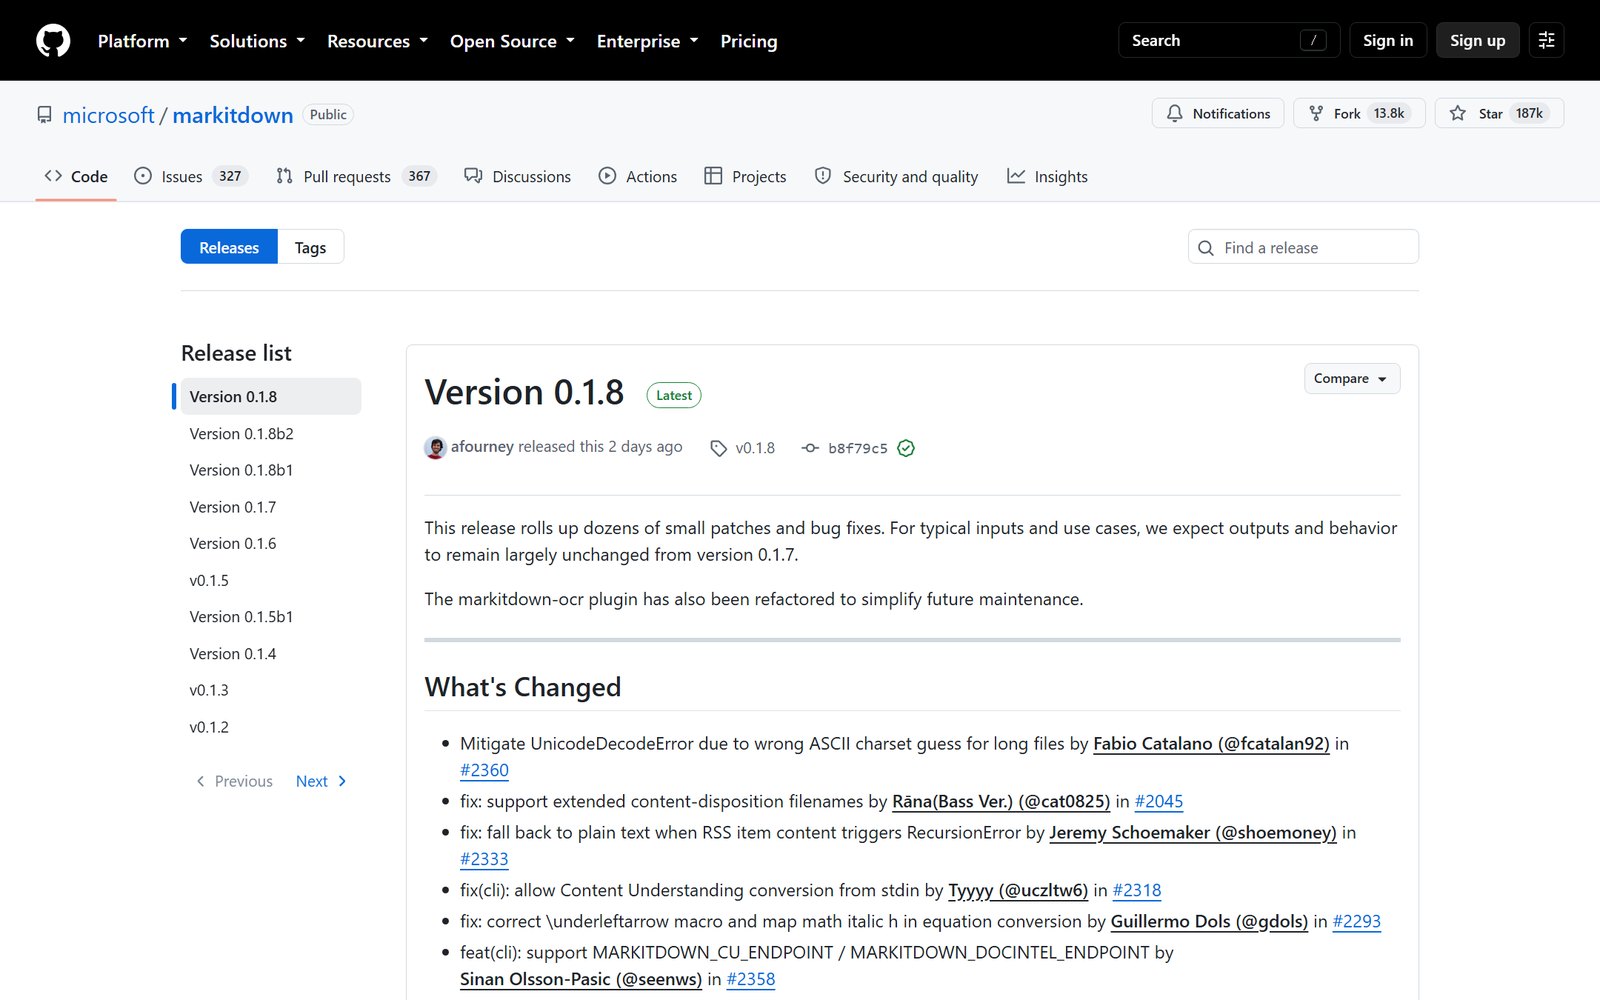
v0.1.8 的发布记录。这次主要是零散的补丁和修 bug,OCR 插件也跟着重构了一轮
不足也得说清楚
693 个未关闭的 Issue,这个数字本身就能说明需求堆了多少。它不是那种没人管然后慢慢烂掉的项目,但确实有相当多的边角情况还没覆盖完。
PDF 的表格到现在还是老大难。翻仓库的提交记录能看到专门为"支持宽表格"做的改动,这说明复杂表格的还原一直在补丁式推进。如果你的文档全是排版规整的简单表格,问题不大;要是碰上跨页、合并单元格、竖排表头的,出来的结果还得人工看一眼。
默认不带 OCR。图片和扫描件直接转,拿到的只有 EXIF 元数据,正文是空的。得另外装 markitdown-ocr 再配一个 OpenAI 兼容客户端,而且这一步要花钱调模型。
还有个容易被忽略的安全问题,README 专门用大段警告讲了:它以当前进程的权限做 I/O,跟 open() 或者 requests.get() 一个级别。也就是说,你拿它处理别人上传的文件,等于给了那个文件访问你本地资源的权限。官方的建议是——不可信环境下要么先把输入消毒,要么只调用最窄的那个函数,比如 convert_stream() 或者 convert_local(),别图省事统一用 convert()。做上传功能的人这一条务必读。
最后,版本号还是 0.x。虽然是微软在维护,API 已经比较稳了,但你要是准备把它嵌进长期维护的生产流程,得接受它可能在小版本里改接口。
跟同类怎么比
最直接的对照是 textract——同样定位的文件转文本库,历史更久,但维护活跃度明显不如 MarkItDown,格式更新也慢。功能上 MarkItDown 基本是它的超集。
IBM 的 Docling 是另一个路数:版面理解做得更深,表格和复杂版式还原更准,代价是模型和依赖更重,跑起来也慢。你如果追求的是"把复杂 PDF 尽可能还原成结构化内容",Docling 值得认真比一比;如果你要的是"批量、快速、低依赖地把一堆杂格式统一成 Markdown",MarkItDown 更合适。
unstructured 覆盖的格式也多,但它把很多能力拆成商业版,社区版和企业版的边界要提前看清楚,不然用着用着发现关键功能在付费档。
我的判断是:把小工具的价值放在"预处理"这一段来评估,它做得挺到位的——一个 pip 命令、一行 CLI、不用起服务、不依赖外部 API(除非你要 OCR),几十种格式一把过。你要是正在给知识库或者 RAG 做入库管道,把这一步从"各写各的解析器"换成统一的 Markdown,能省下不少调试时间。
GitHub:https://github.com/microsoft/markitdown
PyPI:https://pypi.org/project/markitdown/
标签:#MarkItDown #文档转Markdown #RAG预处理 #知识库入库 #PDF解析 #微软开源 #文档工具
你手上最头疼的是哪种格式的文件?扫描件、复杂的 Excel,还是那种带一堆公式的 PDF?