想做一个带门的滚筒洗衣机,常见做法是打开建模软件,一块块拉出箱体、滚筒、门圈、把手,再手工把门轴的角度、抽屉的行程记在别处。等要交给网页预览、仿真或者建筑软件时,又得按各自格式重新导一遍;哪天把门宽改了 5 毫米,零件位置、关节数值、导出文件都得跟着重算。让编码智能体帮忙也不省心:它能把脚本写出来,却很容易在某个面该用哪个坐标上算错。三维建模最磨人的往往不是画形状,而是让「同一个零件」在几处描述里始终对得上。
sand3d 官网首页,写着十万件三维资产以代码形式开放
sand3d 是 11 月 3 日新建的开源仓库,到 11 月 12 日有 1837 颗星,代码采用 Apache-2.0 许可,主体是建立在 Blender 的 Python 运行库之上的一套薄封装,当前版本 v1.6.3。它的做法是把三维物体写成短程序:先用轮廓、拉伸、打孔、倒角这些动作生成零件,每个零件、每条边、每个面都有名字;再用关节把零件连起来,写清谁绕谁转、能转多少度。说明页里那台滚筒洗衣机用了 38 行代码、约 827 个词元:箱体、滚筒、带玻璃和把手的门、洗涤剂抽屉、旋钮各是一个具名零件,四个关节分别写明门轴 0 到 143 度、抽屉 0 到 200 毫米、滚筒与旋钮连续转动。
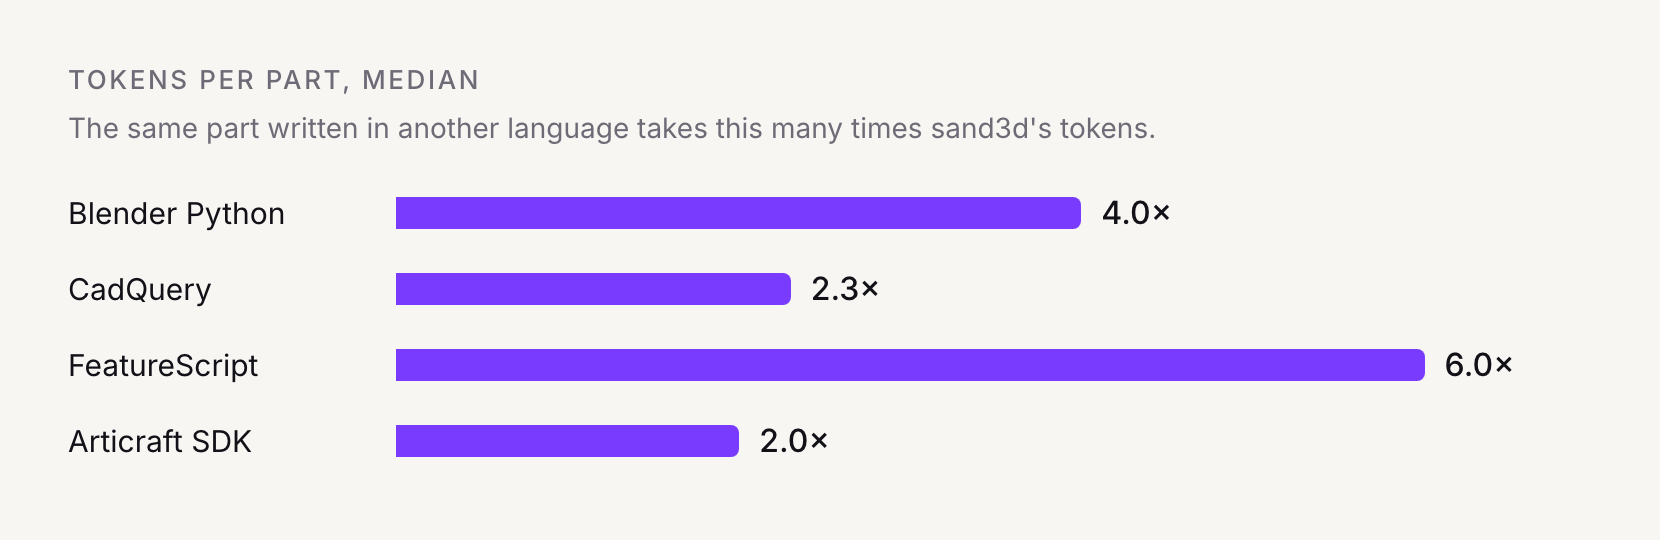
同一个零件用不同写法生成时,词元用量的中位数对比
这套写法的关键不是「换一门更短的脚本语言」,而是让形状始终由名字引用,不用手算坐标。说明页给出一组按零件统计的中位数:写同一个零件,Blender 原生 Python 大约是它的 4 倍词元,CadQuery 约 2.3 倍,FeatureScript 约 6 倍,另一套开发工具包约 2 倍;整个接口约 3600 个词元就能塞进一次提示里。同一段程序生成同一份网格,逐字节一致,改动之后可以稳定复现。
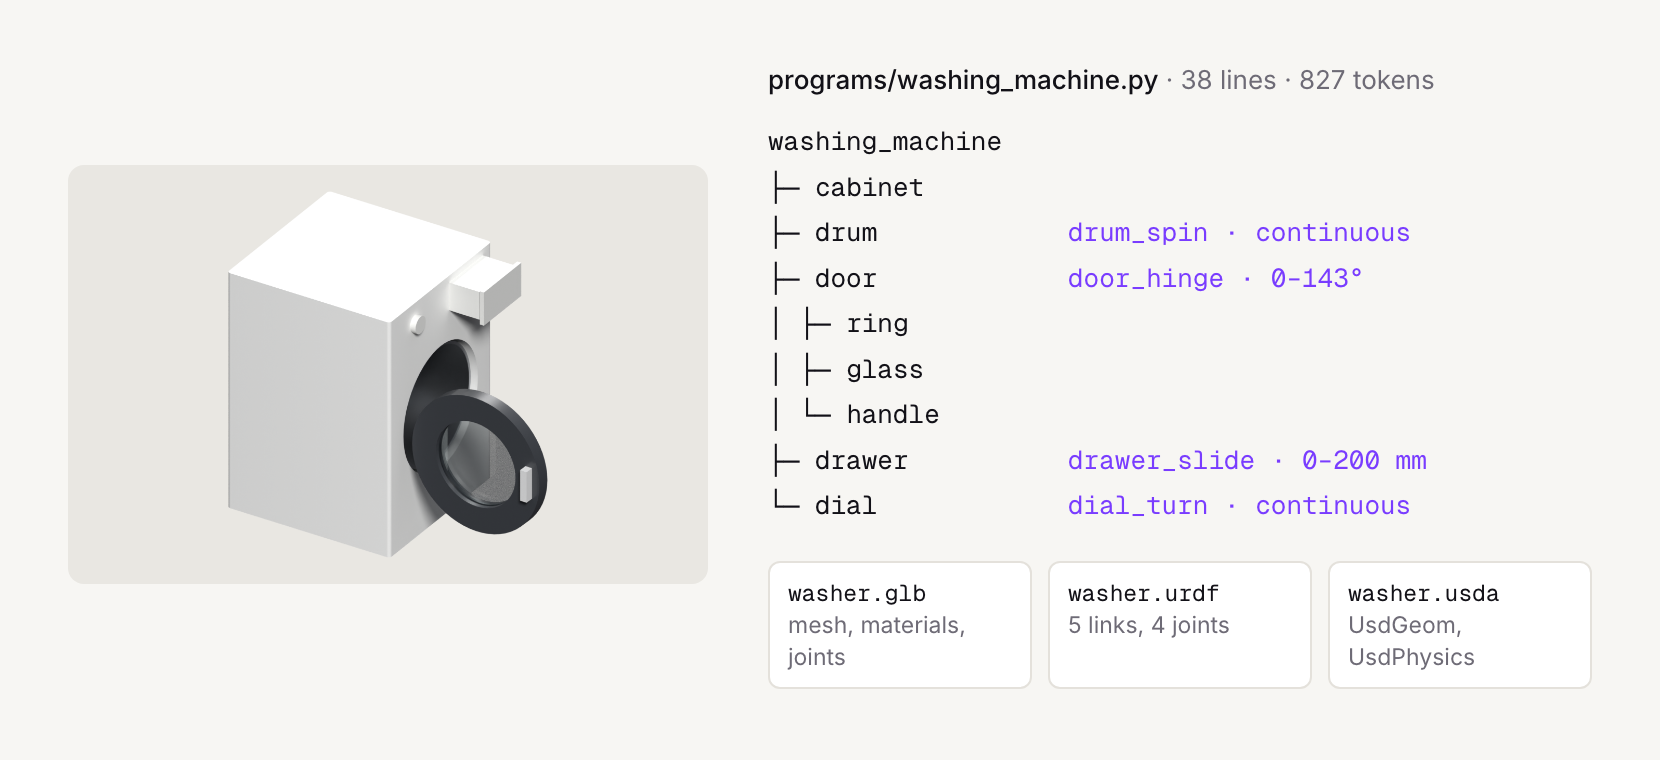
洗衣机被拆成具名零件、四个关节与三种导出文件
第一,它优先解决「能不能被读懂」。零件树、关节限制、导出目标都写在一段人能顺着读下来的程序里,智能体只需描述「把门轴限制在 143 度」,不必推导某条边的空间坐标。说明页把这种思路概括为按名字取、不按坐标算,这也是词元能压下来的主要原因。
第二,一次建模可以流向六种用途。导出时由文件后缀决定格式:GLB 带网格、材质和关节信息供网页与查看器使用;URDF 把每个活动零件写成连杆与关节,供机器人仿真;USDA 用通用场景描述保留同一棵零件树;IFC 把装配结构写成建筑信息模型可识别的工程;OBJ 与 STL 只带当前姿态下的网格。长度单位统一按米,导出前不必逐项换算。
第三,边界得先看清。它需要 Python 3.13 或 3.11,并依赖 Blender 附带的运行库,不是装好就能双击打开的独立建模软件;IFC 导出不含关节,且其中零件的标识会随几何与摆放变化,不能拿来跨文件追踪同一个零件;建筑软件自有的工程格式仍由该软件自己写出,这里走的是开放标准。它面向的是愿意从命令行起步、并且已经有导出目标的人。
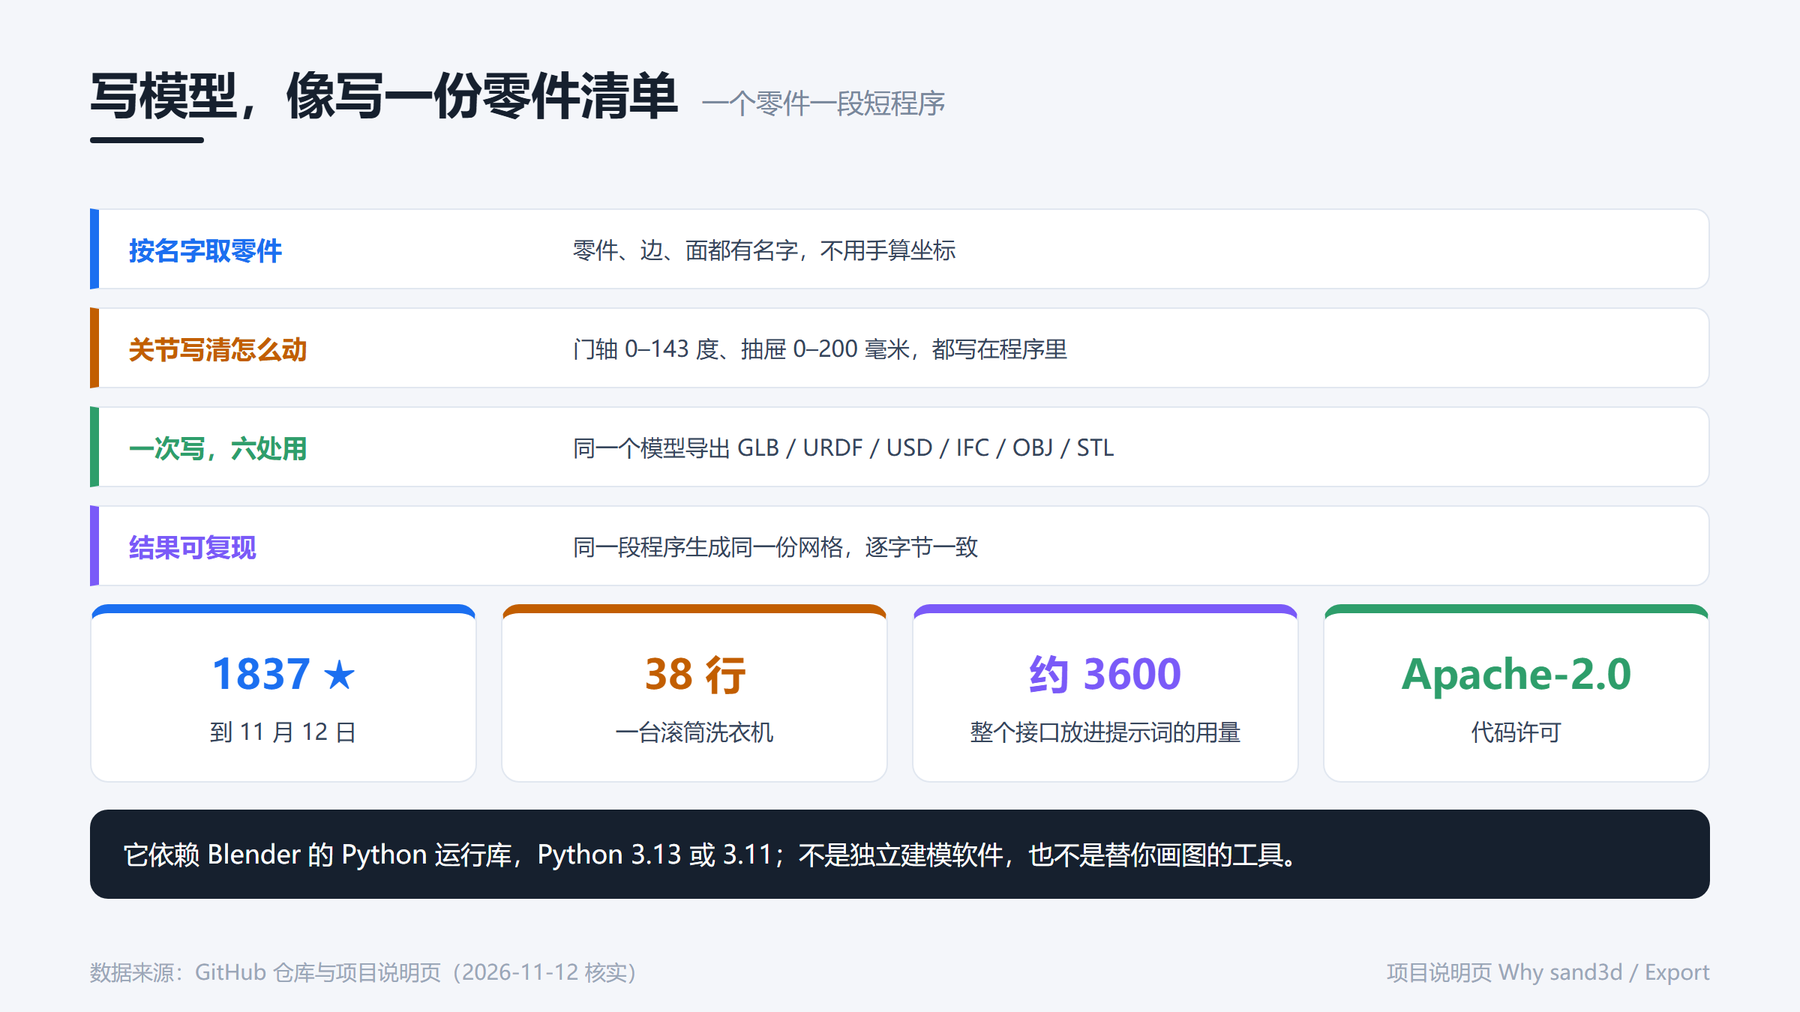
四类写法、六种导出格式与项目规模一图看清
有个细节挺克制:整套接口刻意保持得足够短,短到能整份放进提示词,而不是把每个建模动作都包成一个新概念。把「同一个零件」收敛成一处具名描述,比在多个软件里分别维护尺寸、关节和导出清单更容易长期对齐。
你手上的模型如果要同时给网页、仿真和图纸使用,最怕的是改一处尺寸要同步好几个文件、智能体算错坐标,还是导出格式各不相同、来回换算单位?