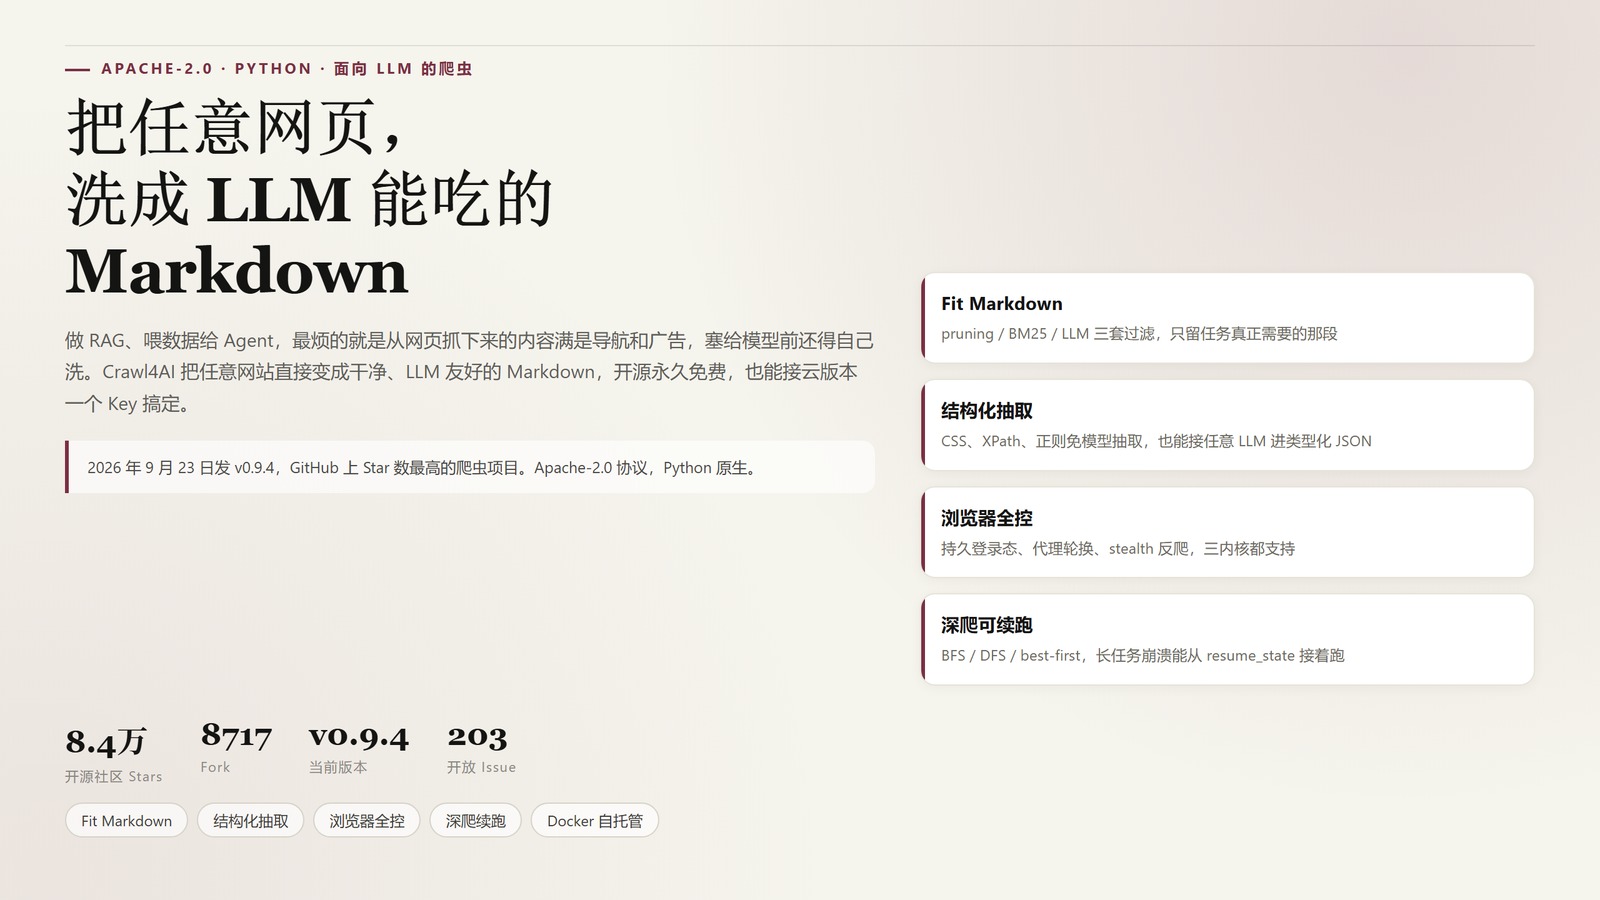
做 RAG、喂数据给 Agent 的人,多半都被同一件事卡过:从网页抓下来的内容,满是导航栏、广告、页脚和一堆没用的结构,塞给大模型之前还得自己洗一遍。清洗这一步,往往比后面调用模型还费劲。Crawl4AI 就是冲着这点来的——它把任意网页直接变成 LLM 能直接吃的干净 Markdown,而且开源、永久免费。
是什么
Crawl4AI 是一个面向 LLM 和 AI Agent 的开源网页爬虫与抽取器,作者 unclecode,Apache-2.0 协议,Python 编写。仓库当前 84,266 个 Star、8,717 个 Fork,最新版本 v0.9.4 发布于 2026 年 9 月 23 日,9 月 25 日仓库仍有提交。它干的事很直接:把一个网站变成结构清晰、LLM 友好的 Markdown,用来做 RAG、Agent 上下文和数据管道。
两种用法。要么自己跑开源版,永久免费;要么用它的云版本,一个 Key 搞定抓取、搜索和抽取,连浏览器都不用自己管。作者说它是 GitHub 上 Star 数最高的爬虫项目。
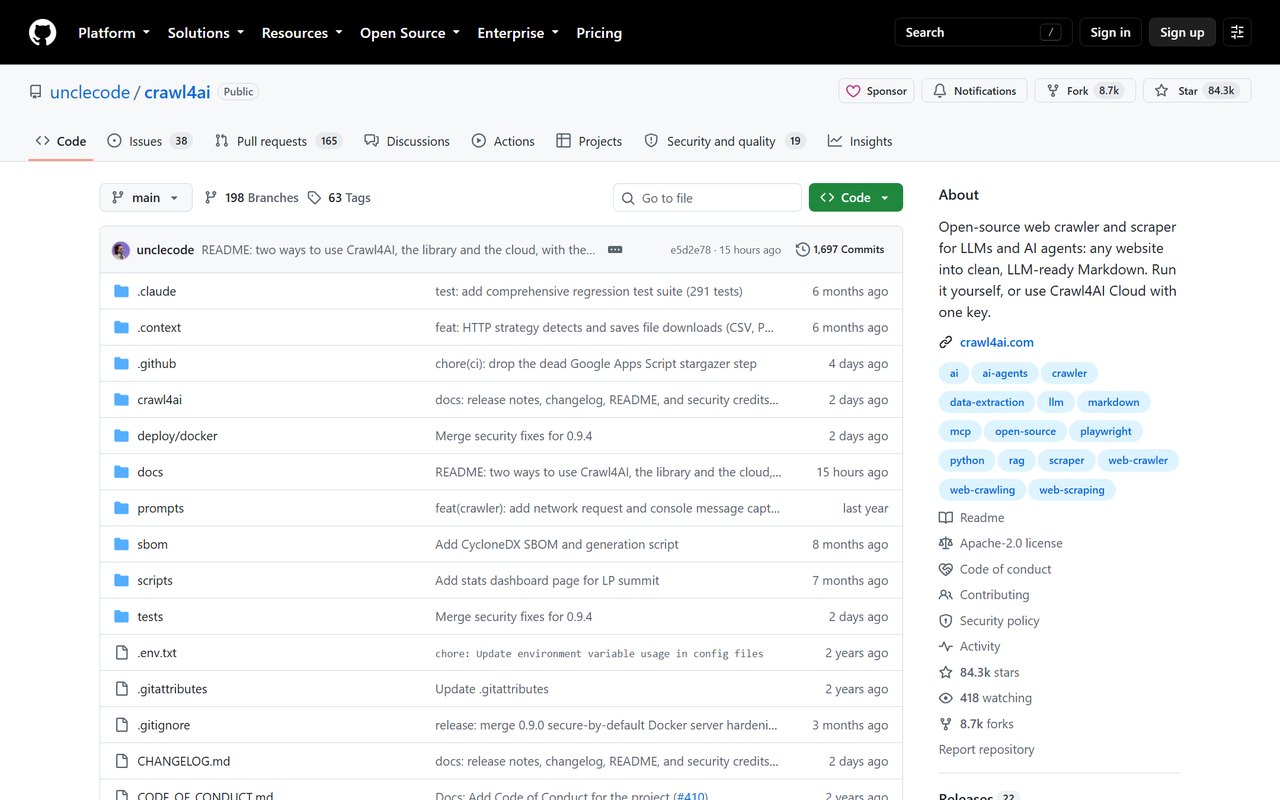
Crawl4AI 的仓库首页。Apache-2.0、Python 主仓,最近一次提交就在今天
它到底好用在哪儿
第一是「Fit Markdown」。普通爬虫吐出来的 Markdown 照样带菜单和页脚,它额外提供一套过滤:按 pruning 规则砍掉样板、按 BM25 围绕你的查询只留相关段落、甚至用 LLM 来筛。结果不是「网页的 Markdown 副本」,而是「你的任务真正需要的那段」。这个区别,喂给检索系统后召回质量差很多。
第二是结构化抽取很全。不用 LLM 也能抽:CSS、XPath、正则三种策略直接把字段抠出来;想偷懒就调 generate_schema 描述一下你要什么,它帮你写可复用 schema;要用模型也行,任意供应商都能接进类型化 JSON。长页面还有主题、正则、句子三种分块,外加余弦相似度找最匹配查询的块。
第三是浏览器控制到位。持久化登录态、走 CDP 连远程浏览器、跨多步的会话、带认证的代理轮换、还有 enable_stealth stealth 模式应付反爬——Chromium、Firefox、WebKit 三内核都支持。动态页面能跑 JS、等元素、滚到底抓无限加载;深爬支持 BFS / DFS / best-first,长任务还有崩溃续跑(resume_state)。
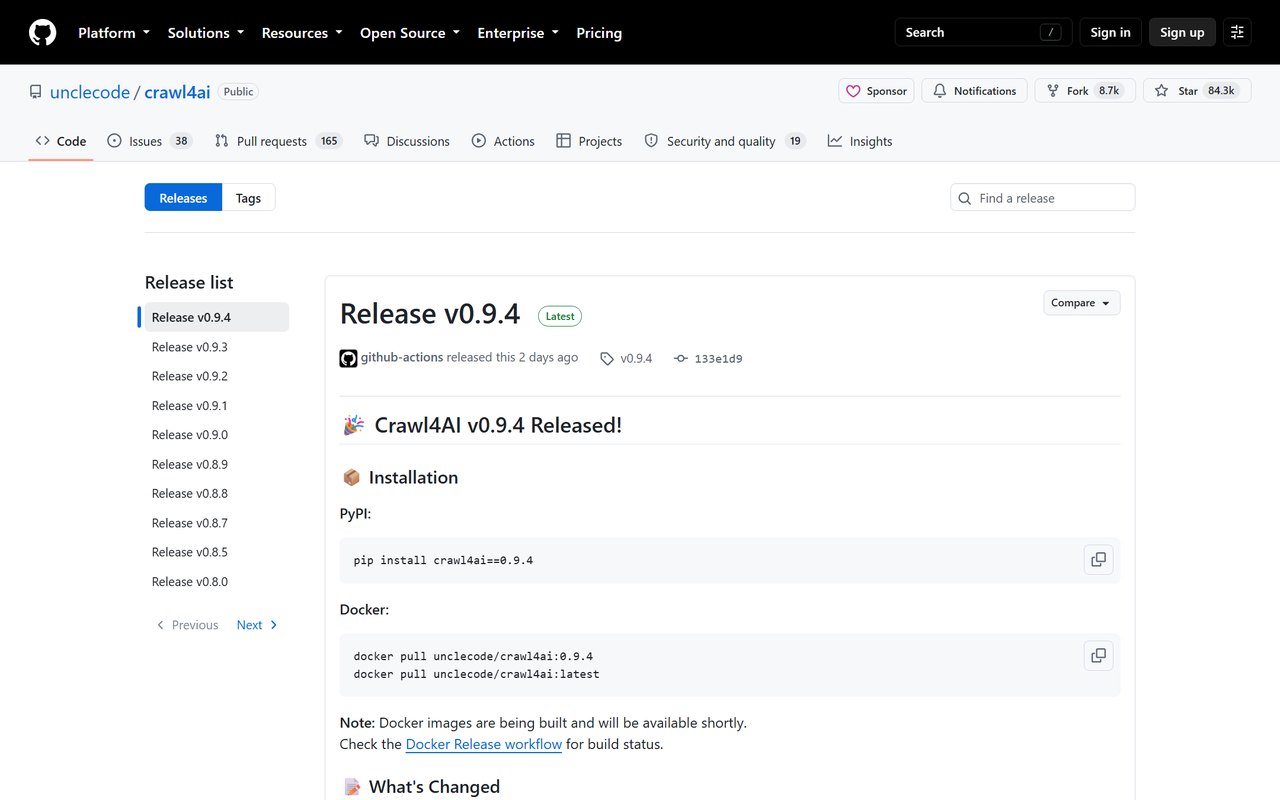
v0.9.4 的发布记录。版本还停在 0.x,但功能面已经铺得很开
怎么用
自跑版就两步:pip install -U crawl4ai 然后 crawl4ai-setup(装一次浏览器)。代码极简:
import asyncio
from crawl4ai import AsyncWebCrawler

async def main():
    async with AsyncWebCrawler() as crawler:
        result = await crawler.arun(url="https://news.ycombinator.com")
        print(result.markdown)

asyncio.run(main())
云版本更省事:邮箱验证拿 Key,你的前 10 美元额度白送(到 2026 年底),然后一条 curl 就能拿到任意页面的 Markdown。给 Agent 用也简单,Claude Code 里加一句 claude mcp add --transport http crawl4ai https://api.crawl4ai.com/mcp 就接上了。Docker 自托管则提供 /md、/html、/crawl、/screenshot、/pdf、/execute_js 一整套 REST,外加 MCP 和监控面板,AMD64 / ARM64 镜像都有。
不足也得说清楚
自跑版要自己养浏览器,吃内存也吃 CPU;碰到硬核反爬墙,得自己配代理和 stealth,这部分云版本才帮你自动兜。换言之,免费的「自己跑」和省心的「花钱托管」之间,差的是运维成本。
版本还停在 v0.9.4,没到 1.0。功能面已经很宽,但 API 稳定性按作者一贯风格仍可能动,升级时留意一下迁移说明。另外未关闭 Issue 有 203 个——相对它的体量算克制,但深度用的边角场景仍可能踩到。
云版本的计费是按量,免费额度用完后就进入 pay-as-you-go。它对个人够友好,但团队大批量抓取前最好先算清账单。还有一点:它自称「GitHub 上 Star 最高的爬虫」,但 FireCrawl、ScrapeGraph 这些对手也在快速迭代,选择时别只看热度。
跟同类怎么比
最直接的对照是 FireCrawl。它也是「网页转 LLM 就绪数据」这条赛道,体验成熟、托管稳,但核心是商业服务、用量收费。Crawl4AI 的卖点是 Python 原生、完全开源免费、对 Agent 友好——你要的是在自己进程里、用几行代码拿到干净 Markdown,它比谁都顺手。
另一类是传统爬虫框架,比如 Scrapy。Scrapy 强在大规模结构化抓取和 pipeline,但产出是原始 HTML / item,喂 LLM 前还得自己洗。Crawl4AI 把「洗成 Markdown + 直接抽取」做成了开箱能力,定位更贴 RAG 和 Agent 场景。
我的判断:如果你是 Python 技术栈、要给 RAG 或 Agent 喂网页数据,它基本是首选——免费、可控、输出直接能进向量库。8.4 万 Star、提交挤在最近几天、文档站和云都齐活,说明这个项目不是昙花一现。但要是你只偶尔抓一两个页面,Jina Reader 那种 /r/ 一键端点可能更轻。
GitHub:https://github.com/unclecode/crawl4ai
官方网站:https://crawl4ai.com
标签:#Crawl4AI #AI开发平台 #网页爬虫 #RAG #数据抽取 #LLM #开源工具
你现在的 RAG 数据是怎么进来的?自己写清洗脚本,还是已经有趁手的爬虫在用了?